值得关注的模型和新技术
o3-mini
OpenAI o3-mini 是一款高效且成本优化的推理模型,专为科学(Science)、技术(Technology)、工程(Engineering)和数学(Mathematics)(STEM)领域优化。它在数学、编程和科学推理方面表现出色,能够在 AIME 2024 和 GPQA 等基准测试中达到或超过 OpenAI o1 的水平。o3-mini 具备三种推理模式(低、中、高),可根据需求在速度和准确性之间进行权衡。此外,它支持函数调用、结构化输出和视觉任务。相比 o1-mini,o3-mini 的响应速度提高了 24%,平均响应时间为 7.7 秒。它的上下文窗口为 200k tokens,输入成本为每百万 tokens 1.10 美元,输出成本为 4.40 美元。
QwQ-Max-Preview
QwQ-Max-Preview是阿里巴巴Qwen系列的最新推理模型,基于Qwen2.5-Max架构开发,专注于提升数学、编码及多领域复杂问题的解决能力。该模型在LiveCodeBench代码评估中取得65.6分,超过OpenAI的o1中型模型(63.4分)和o3迷你低配版(60.9分),展现了卓越的代码生成与逻辑推理性能。其核心优势包括深度推理、Agent任务处理及通用领域适应性,特别适合需要实时响应的隐私敏感场景。作为预览版,QwQ-Max-Preview为后续开源版本铺路,未来将发布Apache 2.0许可证下的完整模型QwQ-Max及轻量级版本(如QwQ-32B),并计划推出iOS/Android端Qwen Chat应用以增强用户体验。阿里巴巴同时宣布未来三年投入530亿美元加强AI基础设施,进一步推动该模型在行业中的竞争力。
我们计划在不久的将来以 Apache 2.0 许可协议开源发布 QwQ-Max 以及 Qwen2.5-Max
官方blog:
Claude 3.7 Sonnet
Claude 3.7 Sonnet 是 Anthropic 推出的首个“混合推理模型”,兼具快速响应和深入思考能力,能够根据任务需求在标准模式和扩展思考模式之间切换。其核心能力包括:在复杂任务中通过扩展思考模式进行详细分析和多角度考虑;在编码任务中表现出色,特别是在 SWE-bench Verified 测试中达到行业领先的 70.3%;支持多模态数据处理,展现强大的适应性;以及在 Amazon Bedrock 中提供可调整的推理预算,供开发者根据需求权衡速度、成本和性能。
Claude 3.7 Sonnet and Claude Code
Grok-3
Grok-3是由Elon Musk的xAI公司开发的第三代AI模型,具备2.7万亿参数和12.8万亿token的训练数据集,采用基于NVIDIA GPU的Colossus超级计算集群(20万张GPU)训练,计算能力比前代提升10倍。其性能表现优异,在MMLU(多任务语言理解)基准测试中达到92.7%,GSM8K(数学推理)89.3%,AIME 2025数学竞赛93.3%,GPQA科学推理84.6%。该模型支持128,000 token的上下文窗口(扩展版达100万token),响应延迟仅67毫秒,并具备多模态处理能力(文本、代码、图像)。独特功能包括DeepSearch实时网络研究代理、“Think"模式分步推理,以及"Big Brain"模式强化复杂问题解决,主要应用于STEM领域、代码生成和商业分析。目前通过X平台Premium+订阅($40/月)和专属网站Grok.com提供访问,API接口即将开放。
Grok-3: The Next Evolution in AI by xAI
Deepseek OpenSourceWeek
FlashMLA
- 功能描述:FlashMLA是一个高效的解码内核,专为多头潜在注意力(MLA)设计,优化Hopper GPU上的变长序列处理。它支持BF16和分页KV缓存(块大小64),已在生产环境中使用。性能指标:在H800 SXM5 GPU上(使用CUDA 12.6),FlashMLA实现3000 GB/s内存带宽和580 TFLOPS计算吞吐量,分别在内存绑定和计算绑定场景下表现出色。性能提升与资源优化:这些指标表明FlashMLA显著提升了解码任务的GPU性能,特别是在处理长序列时减少了内存和计算开销。相比传统内核,其高吞吐量显示出对GPU资源的充分利用。
- 功能描述:FlashMLA是一个高效的解码内核,专为多头潜在注意力(MLA)设计,优化Hopper GPU上的变长序列处理。它支持BF16和分页KV缓存(块大小64),已在生产环境中使用。
- 性能指标:在H800 SXM5 GPU上(使用CUDA 12.6),FlashMLA实现3000 GB/s内存带宽和580 TFLOPS计算吞吐量,分别在内存绑定和计算绑定场景下表现出色。
- 性能提升与资源优化:这些指标表明FlashMLA显著提升了解码任务的GPU性能,特别是在处理长序列时减少了内存和计算开销。相比传统内核,其高吞吐量显示出对GPU资源的充分利用。
DeepEP
- 功能描述:DeepEP是一个为混合专家(MoE)和专家并行(EP)设计的通信库,提供高吞吐量和低延迟的all-to-all GPU内核。它支持FP8运算,并包括不对称域带宽转发的优化内核,适用于训练和推理预填充任务。对于延迟敏感的推理解码,提供纯RDMA的低延迟内核。此外,它引入了基于钩子的通信-计算重叠方法,不占用流式多处理器(SM)资源。
- 性能指标:虽然具体量化数据有限,但其设计目标是最大化InfiniBand和NVLink带宽利用,减少通信延迟,尤其在分布式训练中。
- 性能提升与资源优化:DeepEP通过高效的通信管理减少了数据传输时间,提升了分布式系统的整体性能,特别是在大规模GPU集群中,优化了资源利用率。
DeepGEMM
- 功能描述:DeepGEMM是一个FP8通用矩阵乘法(GEMM)库,支持密集和MoE分组GEMM,专为Hopper张量核心设计。它使用CUDA编写,通过轻量级即时编译(JIT)模块在运行时编译内核,无需安装时的复杂编译。核心逻辑仅约300行代码,采用CUDA核心两级累积解决FP8精度问题,借鉴CUTLASS和CuTe的概念但避免依赖其复杂模板。
- 性能指标:在Hopper GPU上,DeepGEMM实现1350+ TFLOPS的FP8计算性能,超越大多数专家调优内核,尤其在各种矩阵尺寸上表现优异。
- 性能提升与资源优化:FP8的低精度计算减少了内存使用和计算时间,DeepGEMM的高性能显示出对GPU计算资源的有效利用,特别适合训练和推理中的矩阵运算。
DualPipe
- 功能描述:DualPipe是一个双向管道并行算法,旨在在DeepSeek-V3和R1的训练中实现计算-通信重叠。它通过创新的调度减少管道气泡,将前向和后向计算与通信阶段完全重叠,特别是在跨节点专家并行中隐藏通信开销。它充分利用InfiniBand和NVLink带宽,优化内存占用,无需昂贵的张量并行(TP)。
- 性能指标:DeepSeek-V3的训练仅需278.8万H800 GPU小时,相比其他模型(如OpenAI的GPT-4,训练成本约1亿美元),显示出显著的效率提升。论文提到,通过DualPipe,计算-通信比保持恒定时,可实现近零的all-to-all通信开销。
- 性能提升与资源优化:DualPipe通过减少通信瓶颈和优化管道调度,显著降低了训练时间和计算资源需求,提升了大规模GPU集群的利用率。
EPLB
- 功能描述:EPLB用于专家并行(EP)场景,通过复制负载重的专家并启发式地分配到不同GPU,确保负载均衡。由于DeepSeek-V3采用组限制专家路由,EPLB尝试将同一组的专家放置在同一节点,减少节点间数据流量。其算法已在eplb.py中开源,便于再现和部署。
- 性能指标:具体量化数据有限,但其设计目标是通过负载均衡优化GPU利用率,减少训练中的瓶颈。
- 性能提升与资源优化:EPLB通过防止GPU过载或未充分利用,确保资源的高效分配,特别是在专家负载不均时,提升训练效率和稳定性。
值得关注的研究和论文
Deliberative Alignment
https://openai.com/index/deliberative-alignment/
https://arxiv.org/abs/2412.16339
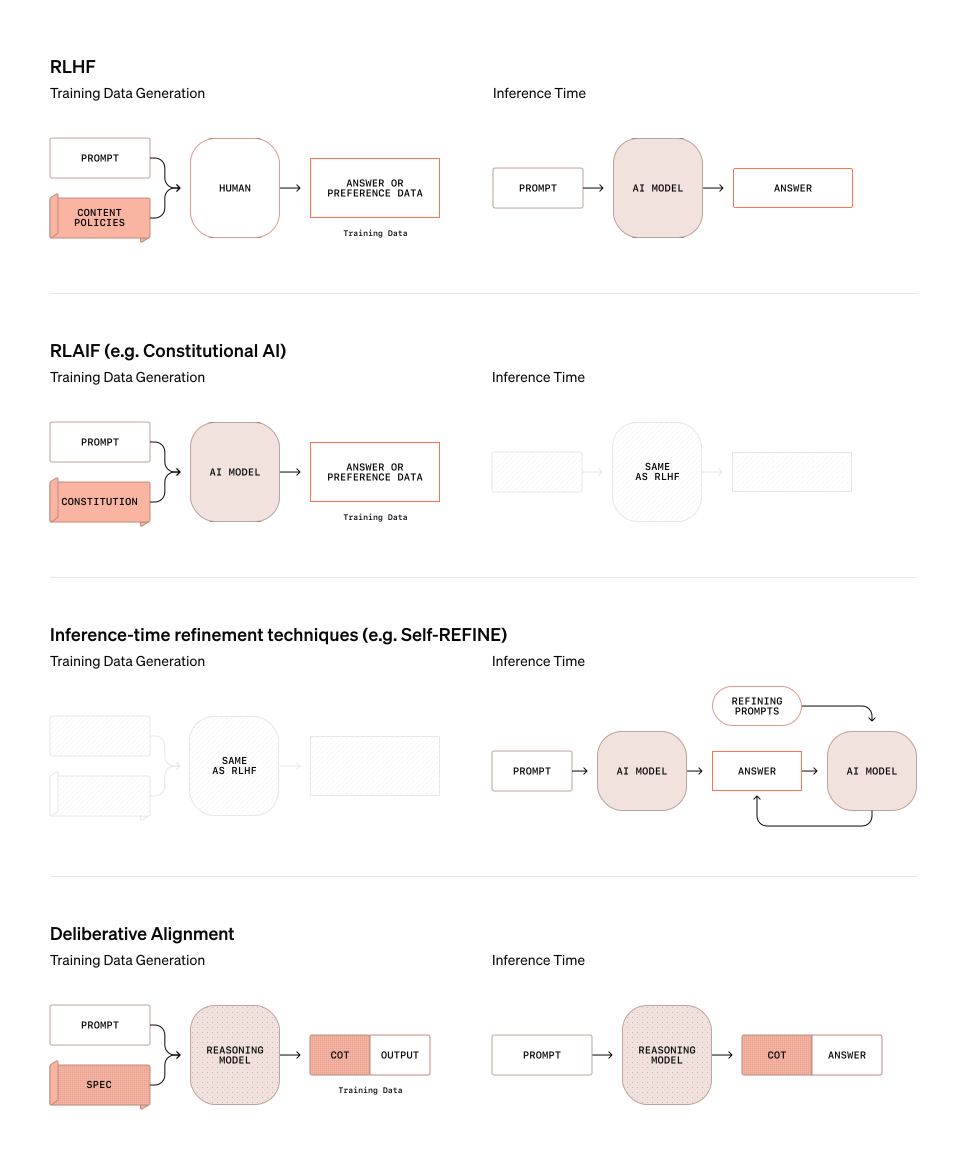
针对o1-like reasoning 模型的安全对齐方法
当前模型的安全性问题
- 即便经过safety training,仍可以被jailbreak
- 模型的响应时间过快,导致它们不能充分评估所有可能的风险和复杂情况
- 模型并没有直接学习如何确保安全,而是通过标注的数据来间接理解应如何回应
Deliberative alignment 解决了:
- 模型响应速度过快、缺乏对安全规范的深入理解
- 通过直接学习safety specifications,使模型不仅仅记住安全规范的内容,还能在实际应用时根据上下文仔细考虑这些规范
- 在推理阶段对安全规范进行复杂的推理
Methods
对齐训练使用过程性监督和结果性监督的结合
- train an o-style model for helpfulness, without any safety-relevant data
- then build a dataset of (prompt, completion) pairs where the CoTs in the completions reference the specifications.
- inserting the relevant safety specification text for each conversation in the system prompt, generating model completions, and then removing the system prompts from the data
- SFT on this dataset
- then use RL to train the model to use its CoT more effectively
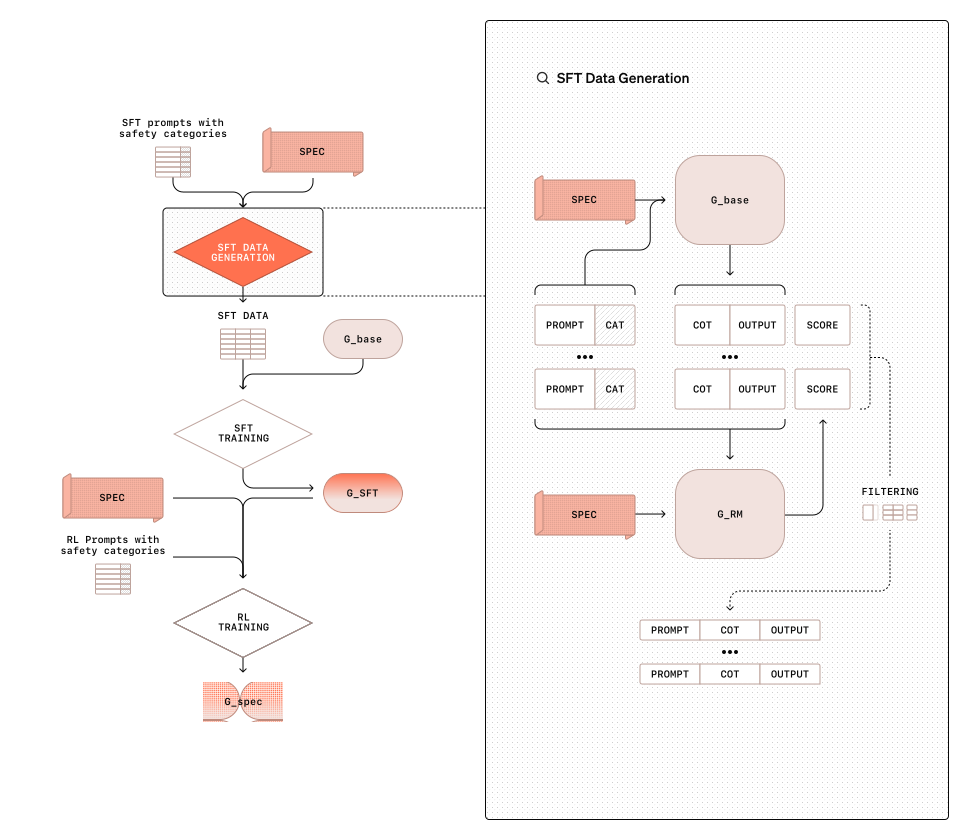
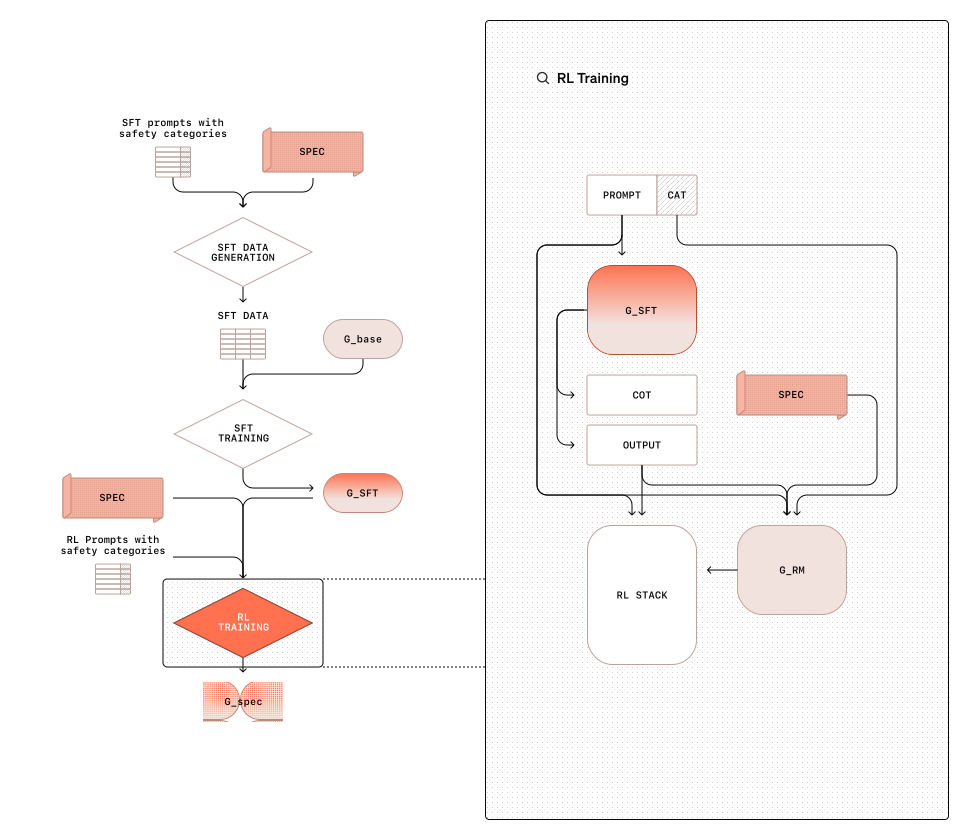
- 模型自动从安全规范和已分类的安全提示中生成训练数据,而不需要人工标注的回答
Trading inference-time compute for adversarial robustness | OpenAI
Trading inference-time compute for adversarial robustness
研究推理模型在推理阶段增加计算资源,对于对抗性攻击(adversarial attacks)的影响
实验发现:
推理时间计算的增加提升了对抗性鲁棒性:在大多数情况下,随着推理时间计算的增加,攻击成功率趋近于零。这表明,允许模型在推理阶段花费更多计算资源进行推理,可以有效提高其对抗性鲁棒性;
无需对抗性训练即可提升鲁棒性: 仅通过增加推理时间计算来提升模型的鲁棒性,而无需专门的微调训练;
推理时间计算的局限性: 在某些特定攻击下,增加推理时间计算可能不会带来显著的安全性提升,甚至可能导致新的安全漏洞;
此外,文中还介绍了两种针对推理计算扩展模型的新型攻击方式:
- Think Less 攻击:攻击者诱导模型减少推理时间,从而降低其对抗性鲁棒性
- Nerd Sniping 攻击:攻击者诱导模型在推理过程中浪费计算资源,使其在无关紧要的推理任务上消耗过多计算能力,可能导致安全漏洞。
Constitutional Classifiers: Defending against universal jailbreaks |Anthropic
为提升LLMs对 universal jailbreaks(通用越狱攻击)的防御能力,Anthropic 研究团队提出了一种名为 Constitutional Classifiers 的方法。
https://www.anthropic.com/research/constitutional-classifiers
解决的问题
- LLMs 易受越狱攻击影响: 现有的 LLMs 仍然容易受到 prompt engineering攻击,例如使用 超长输入 或 特殊格式(如大小写混合)来绕过安全限制;
- 现有防御机制的局限性:传统的安全机制往往难以检测 通用越狱攻击(universal jailbreaks),即能够绕过多个安全限制的攻击方式
- 安全性与可用性之间的权衡:许多安全机制会导致 过度拒绝(over-refusal),即模型拒绝回答大量无害的查询,从而影响用户体验
亮点
- 基于“宪法”规则的分类器:采用 Constitutional AI 的理念,使用一套预定义的“宪法”规则来指导模型的安全性,这些规则明确划分了允许和禁止的内容,并用于训练分类器。
- 输入与输出双重分类器:该系统包含 输入分类器(检测并拦截恶意输入)和 输出分类器(实时监测模型生成的内容,并在检测到有害信息时立即终止响应)
- 合成数据增强训练:利用 Claude 生成大量合成数据以提高分类器的泛化能力
- 实时流式预测:支持 流式预测,即在生成每个 token 时评估其潜在的有害性,从而在检测到风险时立即终止响应,而无需等待完整的输出生成
结论
- 显著降低越狱成功率(从 86% 降至 4.4%)
- 保持较低的误拒率(仅增加 0.38%)
- 计算成本适中(增加 23.7%)
Qwen2.5-1M
开源的长上下文模型, 上下文扩展到1M;包含Qwen2.5-7B-Instruct-1M和Qwen2.5-14B-Instruct-1M两个版本;
方法
- 预训练阶段:
- 从Qwen2.5 的checkpoint 开始 (上下文4K)
- 将RoPE基础频率 从10,000 提高到10,000,000
- SFT阶段:分两个阶段
- 第一阶段:仅在短指令(32K)上微调
- 第二阶段:混合短指令(32K)和长指令(256K)进行训练
- RL阶段:在短文本(8K)上训练,能够泛化;最终获得256K instruction-tuning 模型
- 长度外推:
- 引入 Dual Chunk Attention (DCA), 以解决训练过程中未见过的,Query和Key间相对位置距离过大问题
- 稀疏注意力机制,以提升推理速度:
- 分块预填充(Chunked Prefill), MLP层激活权重的显存使用量可减少96.7%
- 稀疏性优化
注意项
Qwen2.5-7B-Instruct-1M 至少需要120GB
Qwen2.5-14B-Instruct-1M 至少需要320GB
Large Language Diffusion Models (LLaDA)
基于Diffusion Models的新型LLM;能够在多个基准测试中与 LLaMA3 8B 竞争;
不同于传统的LLM,采用Autoregressive的方式,即从左到右预测下一个token,LLaDA采用掩码扩散(Masked Diffusion)方法: 训练时,LLaDA 通过前向过程(Forward Process)随机掩盖输入文本中的 token,并在反向过程(Reverse Process)中预测被掩盖的 token, 从而允许 LLaDA 在双向上下文中进行推理,而不像自回归模型那样受限于单向信息流;
LLaDA 采用标准的预训练 + SFT范式,并在2.3 万亿个 token上进行训练,随后使用450 万对数据进行 SFT
Mercury, the first commercial-scale diffusion large language model
由 Inception Labs 开发的首个商业级扩散大语言模型
- Mercury 在 NVIDIA H100 GPU 上的推理速度超过 1000 tokens/sec,相比于 GPT-4o Mini(59 tokens/sec)和 Claude 3.5 Haiku(61 tokens/sec),提升了 10-20 倍
- 这使得 Mercury 比传统 LLM 便宜 5-10 倍,适用于大规模商业应用
- Mercury 适用于代码生成(Mercury Coder)、对话 AI、企业自动化等多个领域
- 免费试用:Mercury Coder 目前已上线,可在 Inception Labs Playground 试用
Trade-offs of Diffusion Language Models
但也存在一些显著的权衡,例如高推理成本、在链式推理(CoT)中仍需多次迭代以及延迟的流式输出
Thoughts Are All Over the Place: On the Underthinking of o1-Like LLMs
o1-like 模型通过扩展推理计算能力来提升推理深度,但存在着underthinking的问题,即它们在推理过程中频繁切换思路,而未能充分探索有前景的推理路径,导致推理深度不足,影响最终的准确性;
对此研究者引入 Underthinking Score,用于衡量模型在错误答案中的 token 效率,以量化思维切换对推理质量的影响;
为了缓解Underthinking问题,研究者提出了一种新的解码策略 TIP(Thought Switching Penalty),其核心思想是:
- 在解码过程中对思维切换施加惩罚,鼓励模型在当前推理路径上进行更深入的探索,而非过早切换
- TIP 通过调整 logits 进行惩罚,减少模型在短时间内频繁改变推理方向的可能性
Optimizing Large Language Model Training Using FP4 Quantization
由于FP4格式的动态范围和表示能力有限,直接将LLMs量化到这种低比特格式通常会导致模型性能大幅下降
通过以下两个关键创新点来应对挑战
- 可微分量化估计器(Differentiable Quantization Estimator, DGE):为了精确的权重更新,提出了一种可微分量化估计器,以减少FP4计算中的梯度更新误差。
- 异常值夹紧和补偿策略(Outlier Clamping and Compensation, OCC):为了防止在LLMs训练过程中常见的激活值异常值导致的量化精度损失,提出了一种异常值夹紧和补偿策略。
FP4训练框架能够在保持与BF16和FP8相近的准确性的同时,有效地扩展到高达130亿参数的LLMs,并在最多1000亿个训练token上进行训练
推荐内容
一些仓库
专注于强化学习(RL)提升大语言模型(LLM)推理能力的仓库: github.com/bruno686/Awesome-RL-based-LLM-Reasoning
适合LLMs的抓取数据工具集合:
github.com/patrickloeber/llm-data-scrapers
MCP服务器列表: github.com/punkpeye/awesome-mcp-servers
开源小红书图文采集工具: github.com/JoeanAmier/XHS-Downloader
基于 LLM 的智能字幕助手: github.com/WEIFENG2333/VideoCaptioner
阅读和学习
Reasoning best practices | OpenAI: openAI 官方的reasoning模型使用指南
alphaxiv:可在 arXiv 论文上进行评论讨论,选择文章内容同AI讨论
AI Agents Course| huggingface:huggingface 官方的AI Agent课程
影音记录
精选歌单
Live演出
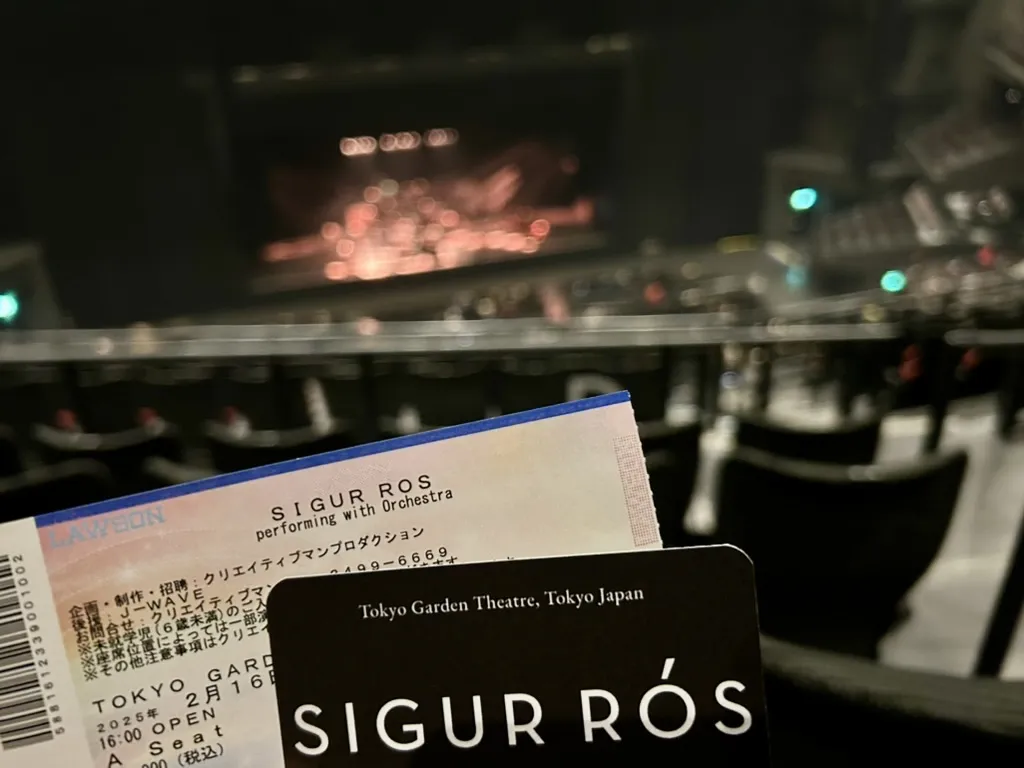
02.16 Sigur Rós TOKYO GARDEN THEATER
电影
哪吒之魔童闹海 ⭐️⭐️⭐️⭐️
书&阅读摘录
《逃走的人》 李颖迪
谈论工作的意义似乎早就过时了,太热情了甚至显得傻。“工作就是工作。”这才是正确的态度。我们说起工作,说的是绩效和KPI,不是它的乐趣、意义和自我实现。当时仍在新冠流行期间,它更加剧了某种困顿感和停滞感。但我们其实也害怕真的停下—离开既定轨道,比如辞职了,之后还能找到下一份工作吗?就这样迟疑着,踌躇着,不满意想走,想走又不敢走。明明还“年轻”,按照教科书上的说法,这不应该正是踌躇满志的时候吗?
2022年,中国城市的房子往往每平方米一万元上下——在北京,这个数字是四万(海淀、朝阳等地甚至每平方米九万),上海、深圳也差不多——在城市买房,往往意味着贷款,动辄几百万。年轻人买房等于交出人生的主动权:未来几十年运转于一场数字游戏般的任务,上班,赚钱,还房贷。但向往城市,就不得不挤上这条令人望而生畏的漫长轨道。
人们对此有不同的看法。有人认为,低廉的房价将源源不断地吸引年轻人来到鹤岗,从而形成新的活力。
但另一个人说,人们在城市里购房,购买的只是那一套简单的钢筋水泥么?
他接着说,不,人们购买的是希望。“房价走低不可能带来希望。没有希望,这里的房价才会走低。”
去鹤岗,也不能说他就此自由了,要看怎么定义“自由”——自由不是想干什么就干什么吧—他停了下——自由是不想干什么就不干什么。但他又换了一个说法,也可能人生都这样,还能烂到哪里去?
one minute blog: the triangle of talent
The weird thing is: as a manager, you’ll spend 90% of your time dealing with the employees on the left (problem employees) or the middle (average joes). But it’s the people on the right side (the star employees) that create 90% of the value in the company.

CEOs - how many level 5s do you have on your team? If you’re just started (cofounders) - you should have 100% level 5 If you’re a small team (5-20 people) - you should have at least 30% If you’re a medium team (20-150 people) - shoot for 15% If you’re a big company (150+ people) - 5-10%… but honestly just quit, big companies are no fun
Suno创始人访谈:至少对音乐来说,Scaling Law不是万灵药|Bolt荐阅
音乐与文字非常不同,不能简单的认为在 AI 的发展过程中,语音只是比文字发展的慢了一点,认为 Scaling law 会解决所有问题。音乐是非常主观的领域,要把音乐的模型训练的好、做出好的产品,还需要很多其他的技能。
一个国家的工程师与律师的比例直接影响经济增长。工程师越多,经济增长越快;律师越多,经济增长越慢
音乐行业当前有一种“蛋糕就这么大,大家来分”的心态,大家都在争夺有限的财富,导致不公平的分配。如果我们能够一起把蛋糕做大,那么一切都会变得更加容易
这首先需要让每个人都能享受音乐创作的乐趣
Deepseek R1可能找到了超越人类的办法
这就导致了预训练撞墙的事实:模型体积虽然增加了 10 倍,但我们已经无法获得比现在多 10 倍的高质量数据了。
RLHF 本质上是一种讨好人类的训练方式,它让模型输出符合人类偏好,但同时它扼杀了超越人类的可能性。
使用强化学习(RL)来训练模型思维链成为了所有人的新共识
未来的模型对人类标注需求会越来越少。
未来的 Reasoning 模型可以收集用户和模型聊天时 AI 生成的思维链来训练
硅谷创业教父Paul Graham:为什么你一直在拖延真正想做的事?
“要么在拖延中痛苦,要么让自己行动起来,花费的功夫是一样的。”
我们为什么害怕“开始”? 障碍1:缺少经验 障碍2:他人的质疑 障碍3:自我怀疑
让开始开始的 9 种策略 策略1:用乐观的心态看待事物 策略2:适度的过度自信 策略3:适度的“无知” 策略4:寻找同路人 策略5:关注进步的速度,而非当前的位置 策略6:降低期望值 策略7:选择容易上手的工具 策略8:将失败当成学习的过程 策略9:改变你的衡量标准
最好的工作是自由市场中持续学习者的创造性表达
“最好的工作是自由市场中持续学习者的创造性表达”(The best jobs are creative expressions of continuous learners in free markets)这句话出自《纳瓦尔宝典》(The Almanackof Naval Ravikant)
特有知识更多关注你的内在天赋,你真正的好奇心和热情,这种知识通常极富技术性和创造性,因此不能被外包或自动化。
更舒服的哲学是“做一个制造者,制造人们想要的有趣的东西,练好你的手艺,合适的人最终会找到你。”
关键是你得迈出第一步——开始创作,成为那1%的内容创作者
一句话总结普通人如何建立自己的财富之路:产品化你自己
The AI Architect — Bret Taylor
“Across our customer base, we are seeing a new role emerge - the role of the AI architect. These leaders are responsible for helping define, manage and evolve their company’s AI agent over time. They come from a variety of both technical and business backgrounds, and we think that every company will have one or many AI architects managing their AI agent and related experience.”
“There’s a lot of power in combining product and engineering into as few people as possible… few great things have been created by committee.” …And it’s almost impossible to specify the requirements of a product when you’re not sure of the limitations of the technology itself.”
One thing I just, I just observe is that I think the early Google days had this interesting mix of PM and engineer, which I think you are, you didn’t, you didn’t wait for PM to tell you these are my, this is my PRD.
Is your job as a maker of software to author a code in an editor? I would argue no just like a generation ago. Your job wasn’t to punch cards in a punch card That is not what your job is. Your job is to produce digital something, whatever it is, what is the purpose of the software that you’re making? Your job is to produce that. And so I think that like our jobs will change rapidly and meaningfully, but I think the idea that like our job is to type in a
They didn’t type faster or produce more code. They did the right thing in the right market, the right time.
都没人看我为什么还要写博客?
你拿着相机在城市里穿行,看见一幕——光影交错,人情味流露。你按下快门。 没人关心。 但你并不是为了别人去做。你做,是因为你看到了什么。 写博客也是如此。你写,因为你思考,因为你观察,因为你需要一个“出口”来安放这些想法。 有人看吗?有就算赚到。没有也没关系。创作这件事,本身就已经完成了它的意义。 这才是重点所在。
写博客能让你理清思绪,让你的观点更明晰。你会更谨慎地组织语言,避免废话——说实话,你是为自己写。如果连你自己都提不起兴趣,那别人就更没有理由了