值得关注的模型和新技术
OpenAI 更新系列模型
发布了多款新一代AI模型,包括o3、o4-mini、GPT-4.1及其mini和nano版本。这些模型在推理能力、成本效益和多模态处理等方面实现了提升。o3专注于复杂推理和工具使用,已在ChatGPT Plus等产品中取代前代模型。o4-mini则以高性价比和多模态能力为亮点。GPT-4.1系列主打超长上下文和高效编码,mini和nano版本进一步降低成本和延迟。
Introducing GPT-4.1 in the API
Introducing OpenAI o3 and o4-mini
Kimi-VL 和 Kimi-VL-Thinking
由Moonshot AI推出了新一代视觉语言模型Kimi-VL及其,主打高效多模态推理高级版本Kimi-VL-Thinking。采用轻量级混合专家架构(16B总参数量,2.8B的激活参数),支持128K上下文窗口和超高分辨率视觉输入,Kimi-VL-Thinking通过链式思考和强化学习训练,专注于复杂推理和数学任务。
Hugging Face Kimi-VL-Thinking 模型页面
A2A协议
A2A协议(Agent2Agent Protocol)是由谷歌于2025年4月10日在Google Cloud Next 2025大会上宣布开源的标准智能体交互协议,旨在实现跨平台、跨供应商的AI智能体(AI Agent)无缝通信与协作。功能与特点:A2A协议通过统一规则支持多模态协作,允许智能体共享和处理文本、音频、视频等多种数据格式,兼容HTTP、SSE、JSON-RPC等现有标准,降低企业集成成本。其核心机制包括Agent Card,用于智能体能力发现与协作对接,支持自然、非结构化协作模式,即使智能体不共享内存或上下文也能协同工作。
Announcing the Agent2Agent Protocol (A2A)
Qwen3
Qwen3 是Qwen的第三代大语言模型系列,于2025年4月正式发布,包含6个稠密模型(0.6B至32B参数)和2个混合专家(MoE)模型(30B-A3B和235B-A22B)。功能与特点:Qwen3支持119种语言,训练数据高达36万亿token,具备自然语言理解、文本生成、工具调用、复杂推理及多模态交互能力。模型采用混合推理模式,可根据任务复杂度自动切换“思考”与“快速响应”模式,优化计算效率与响应速度。支持128K token上下文长度,适用于长文档处理、编程、数学推理及智能体任务。创新点:Qwen3引入动态可调MoE架构,通过分层稀疏调度和动态专家激活(最多128个专家,单token激活8个),显著降低推理耗时(15B模型推理效率提升42%)和显存占用(从28GB降至18GB)。新增Qwen3RMSNorm归一化层优化注意力机制,支持多种RoPE变体(dynamic、yarn、llama3)以提升长序列处理能力。词表优化引入动态加权合并算法,增强高频词组处理,并新增智能体专用控制符。效果:旗舰模型Qwen3-235B-A22B在Codeforces编程竞赛、AIME数学基准及BFCL推理测试中超越OpenAI的o3-mini和谷歌Gemini 2.5 Pro,Qwen3-32B在LiveCodeBench编码任务中优于OpenAI o1。
值得关注的开源项目
Inbox Zero
Inbox Zero 是一个开源的 AI 邮件管理工具,旨在通过智能化功能帮助用户快速清空收件箱并高效处理邮件。项目包含两部分:AI 邮件助手与开源邮件客户端。其核心功能包括:
- AI 个人助理:基于用户自定义的文本指令,可自动执行邮件管理操作(如起草回复、标记分类、归档、标记垃圾邮件或触发网络钩子),显著减少手动处理时间。
- Reply Zero 跟踪:实时追踪需用户回复的邮件及等待他人回复的邮件,提升沟通效率。
- 智能分类与退订:自动整理联系人邮件并智能归类,支持一键批量退订低价值订阅。
- 冷邮件拦截与分析:自动过滤陌生发件人邮件,并提供每日/周/月邮件活动统计,帮助用户优化收件箱管理。
技术优势与适用场景
项目采用 Next.js、Tailwind CSS 等现代技术栈构建,支持通过 Vercel 快速部署或自托管,兼容 Anthropic、OpenAI 等 LLM 模型,甚至可集成本地 Ollama 服务以降低成本。
Github:github.com/elie222/inbox-zero
FastMCP v2
FastMCP v2 是一个专为快速构建 Model Context Protocol (MCP) 服务器和客户端设计的 Python 工具库,旨在简化MCP开发。基于标准化的 MCP 协议,FastMCP 通过简洁的 Pythonic 设计,帮助开发者高效创建工具、资源、提示模板,并无缝连接组件,同时自动处理协议细节与服务器管理。其核心功能包括:通过装饰器快速定义工具(Tools)及资源(Resources),支持代理服务器配置、多服务组合,以及从 OpenAPI 或 FastAPI 规范自动生成 MCP 服务;客户端则提供灵活的连接方式、LLM 采样等高级功能,便于程序化测试与创新应用
Github:github.com/jlowin/fastmcp
HawkinsDB
HawkinsDB是一款受杰夫·霍金斯“千脑理论”启发的神经科学驱动型记忆系统,旨在为LLM应用提供更接近人类认知的记忆管理能力。不同于传统的向量数据库,它通过整合语义、情景和程序性记忆,构建了一个多维度的记忆框架,使AI能够精准理解数据间的关联与上下文,而非仅依赖模糊的相似性搜索。其核心功能包括:
- 神经科学架构:采用“参考框架”(Reference Frames)和“皮层柱”(Cortical Columns)概念,模拟大脑多角度处理信息的方式,支持从属性、关系到场景的结构化知识存储。
- 透明化决策:通过清晰的逻辑链展示信息关联,避免“黑箱”问题,帮助开发者理解AI的推理过程。
- 灵活扩展:支持SQLite和JSON存储,集成ConceptNet实现知识自动丰富,并提供自然语言查询接口。
Github:github.com/harishsg993010/HawkinsDB
Task Master
Task Master 是一个基于Claude AI的任务管理系统,专为AI驱动的开发流程设计,能够自动解析产品需求文档(PRD),生成结构化任务体系,并与Cursor AI等工具无缝集成,帮助开发者高效规划和追踪项目进度
具体功能:
- 智能任务拆解:自动解析PRD文档,生成包含Epic和子任务的结构化任务体系
- 依赖关系管理:智能分析任务间的依赖关系,确保开发顺序合理
- 编辑器深度集成:通过MCP配置无缝接入Cursor或Windsurf等编辑器,支持自然语言指令直接与AI交互
Github:github.com/eyaltoledano/claude-task-master
Graphiti
Graphiti 是一个专为动态环境设计的实时知识图谱框架,旨在帮助AI代理高效管理时序数据。其核心特性包括:1)实时增量更新,支持动态数据流的即时整合;2)双时态模型,精准追踪事件发生时间和数据摄入时间;3)混合检索引擎,通过语义嵌入、关键词搜索和图遍历实现亚秒级低延迟查询;4)可定制实体系统,允许开发者通过Pydantic定义自定义实体类型。相比传统RAG方法,Graphiti无需全量重算即可处理数据变化,特别适用于需要上下文感知、历史追溯的企业级应用。
Github:github.com/getzep/graphiti
值得关注的研究和论文
PaperBench: Evaluating AI’s Ability to Replicate AI Research
如何评估AI代理自主复现前沿AI研究的能力:
- 理解复杂的科研论文。
- 从零开始开发功能代码库。
- 执行实验以复现论文的实证结果。

创新点
- PaperBench Benchmark
- LLM-Based Judge
- **PaperBench Code-Dev变体:**放宽执行要求的轻量级版本
具体实现:
-
代理接收论文,生成包含
reproduce.sh脚本的代码库,用于执行实验 -
提交内容在配备A10 GPU的Ubuntu 24.04虚拟机中从零执行
-
评分标准
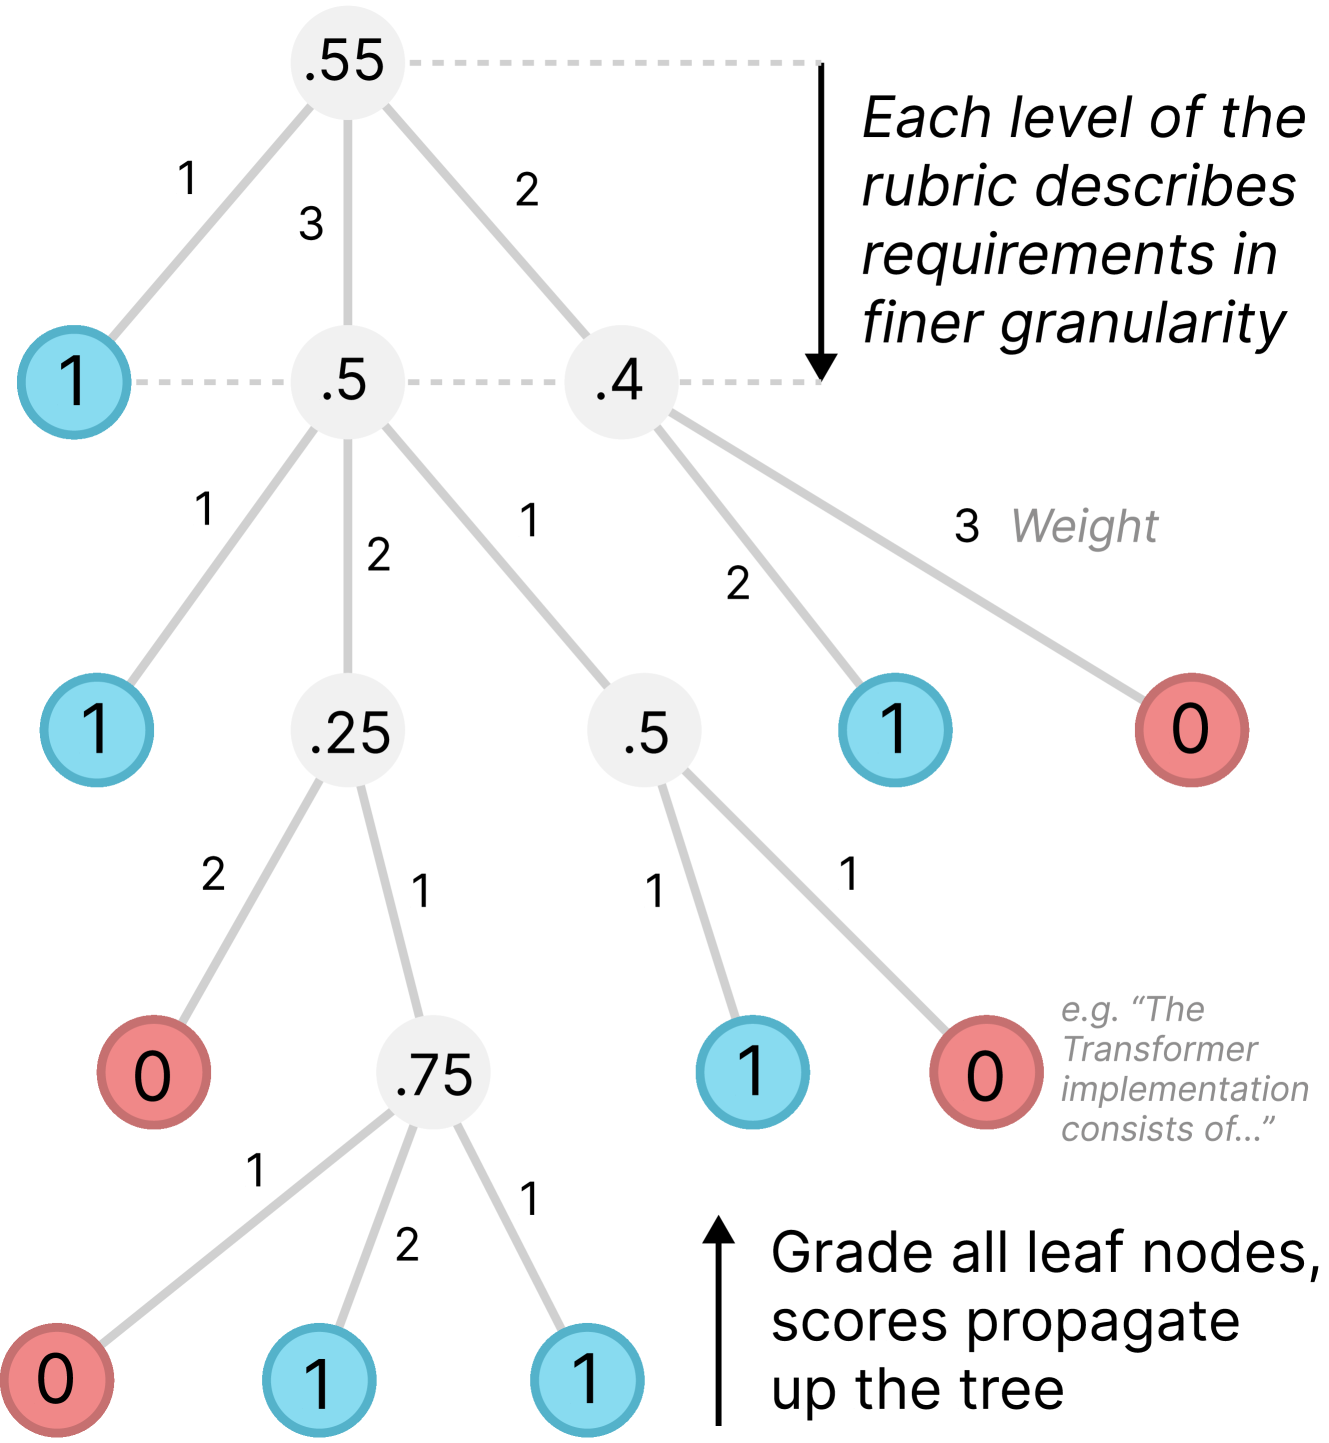
- 分层评分标准将任务分解为叶子节点(二元通过/不通过)
- 三种评估类型:
- 代码开发:代码实现的正确性。
- 执行:
reproduce.sh脚本的正确运行。 - 结果匹配:复现结果与论文的一致性。
-
LLM评分(o3-mini|o1)
实验结果
- Claude 3.5 Sonnet 为已测试模型中最佳(21.0%)
- 人类基线:博士生(取得41.4%的得分,显著优于模型)
- 观察:
- 模型常过早终止任务,未能有效制定策略
- 性能停滞:模型初期进步后趋于平稳,而人类持续提升。
- 代码与执行差距:模型擅长编写代码(代码开发得分35.4%),但执行(1.8%)和结果匹配(0.7%)表现极差。
- IterativeAgent (forced to use full time) 能够提升agent分数

RARE: Retrieval-Augmented Reasoning Modeling

核心问题:
- RAG仅仅补充知识,未系统优化推理能力,特别是在特定领域下(如医疗、金融等)需要专业知识和复杂推理能力,导致在需要多步骤逻辑分析的任务中表现不佳。
RARE shifts LLM training from memorizing knowledge (“Remember”) to applying and evaluating it (“Analyze”, “Create”). It separates domain knowledge (retrieved externally) from domain thinking (learned during training), enabling better performance under tight parameter budgets.
创新点
- RARE(Retrieval-Augmented Reasoning Modeling),一种解耦知识存储与推理优化;具体而言, 将知识存储于数据库中, 通过训练将领域特定的推理模式内化至模型中
具体实现
- 训练流程:
- 使用QwQ-32B模型,生成包含知识和推理步骤的高质量训练数据 (知识蒸馏)
- 对错误答案进行多次迭代修正,直到生成正确结果(自适应重采样,adaptive retries)
- 在Llama-3.1-8B上做SFT,优化推理能力而非知识记忆
- 推理阶段:
- 同普通RAG

Why do LLMs attend to the first token?
这篇论文研究了LLMs中的"注意力汇聚"(attention sink)现象,即为什么LLMs会大量关注序列中的第一个token(通常是


over-mixing: 在LLMs中信息往往会被过度混合,导致所有token的嵌入变得相似
研究发现:attention sink 是模型避免"过度混合"(over-mixing)的一种机制, 注意力sink——即许多注意力头集中在⟨bos⟩(beginning of sequence)token上——起到类似“空操作”的作用,减少token之间的相互作用,从而在各层之间保持表示的多样性。
实验方式:
- 扰动分析实验 (Perturbation Analysis):验证注意力汇聚如何影响信息传播;在输入序列中改变单个词(如将"greatest"改为"best"),比较有/无
标记时扰动的传播情况,在模型上测量表示变化。 - 上下文长度实验: 研究预训练上下文长度对注意力汇聚的影响
- 模型规模实验:研究模型大小对注意力汇聚的影响
- 预训练策略实验
- 表示距离实验:测量最终层token表示与均值的距离,比较有/无
时的表示分布。
在Gemma 和Llama上的实验结果:在Gemma 7B模型中的扰动测试表明,⟨bos⟩显著减缓了变化在模型中的传播速度。同时,在LLaMa 3.1的405B模型中,超过80%的注意力头表现出明显的sink行为。
Sink是自然形成的,即使没有特别的预训练,sink也倾向于在第一个位置形成,这并不是因为⟨bos⟩ token本身的特性,而是因为它所处的位置。然而,如果在训练期间固定使用⟨bos⟩,但在推理时将其移除,模型性能会崩溃,说明sink的形成依赖于训练数据。
作者将sink的出现与Jacobian范数的上界联系起来,证明sink可以降低模型对token扰动的敏感性。
一些注意力头会默认将⟨bos⟩作为关注目标,除非出现特定模式才会触发真正的计算。(默认关注⟨bos⟩,除非有更重要的地方需要关注)
DAM(Describe Anything Model)
Describe Anything: Detailed Localized Image and Video Captioning
解决的问题
传统图像描述模型只能生成整体场景的概括性描述,,缺乏针对图像/视频特定区域的细节描述能力,即局部化描述(Detailed Localized Captioning, DLC);同时缺乏评估区域描述质量的基准数据集。
创新点
- 提出了"Focal Prompt"机制,同时提供全局图像和目标区域的放大视图
- Localized Vision Backbone:融合全局和局部特征
- 设计了一个半监督学习数据管道DLC-SDP来生成高质量的局部化描述数据
- 提出了一个新的基准测试DLC-Bench,用于在不依赖参考描述的情况下评估DLC模型
Test-Time Reinforcement Learning(TTRL)
在「无任何真标签的测试时数据」上,如何利用强化学习去自我训练(Test-Time Training),从而提升大语言模型的推理能力
创新点:
相比于传统RL中需要奖励信号学习,TTRL通过在推理阶段生成多个候选输出,设计基于多数投票的伪标签估计与二值化奖励函数,将模型自身生成的多次候选答案进行投票,进而为每条生成打分,将 Test-Time Training 与 RL(如 GRPO/PPO)结合,实现模型在推理阶段的动态微调。
具体实现
测试集(AIME2024|AMC | MATH-500)都是具有标准答案的数学推理题。
对每个输入 prompt 重复抽样 N=64 条响应,对这 64 条输出做多数投票,取出现频次最高的答案作为“估计标签”(伪标签),单条输出与伪标签吻合得 1 分,否则 0 分
RL 微调:用 GRPO(或 PPO)算法优化生成策略;
发现:
- Test-Time RL 对超参的敏感
- 更强的先验知识有助于伪标签质量和自我演化效果,模型规模越大,TTRL 提升越明显
Concise Reasoning via Reinforcement Learning
一些结论:
- Long ≠ better reasoning
- A Two Phase RL Strategy:首先在困难的问题上训练,从而提升模型的reasoning能力;而后在一些偶尔能解答的任务上进行微调,目的是让模型在保持准确率的前提下,生成更简洁的CoT;(用更少的话表达同样的推理过程,以减少50%的token消耗)
- PPO训练时建议λ<1,以保证训练稳定和输出质量
PHYBench: Holistic Evaluation of Physical Perception and Reasoning in Large Language Models
解决的问题
- 现有LLMs在物理场景下的推理能力评估不足
- 缺乏高质量的物理推理数据集和细粒度的自动评估指标
创新点
提出了一个名为 PHYBench 的新基准测试,它是一个大规模、人工设计的基准,专门用于评估模型在物理环境中的复杂推理能力;PHYBench 包含 500 个精心挑选的物理问题,涵盖力学、电磁学、热力学、光学等多个领域;
同时提出了表达式编辑距离(Expression Edit Distance,EED)评分,通过计算数学表达式之间的编辑距离来评估模型的推理过程和结果,EED 评分能够有效地捕捉模型推理过程中的差异,优于传统的二元评分方法。
EED Score 的核心思想是:将模型生成的符号表达式(gen)和标准答案(gt)都转化为表达式树(如SymPy表达式树),计算二者之间的最小编辑距离(包括节点的插入、删除、替换、子树插入/删除等操作),再根据相对编辑距离给出一个连续分数。
设 Distance(T_{gt}, T_{gen}) 表示标准答案树 T_{gt} 与模型生成答案树 T_{gen} 之间的最小编辑距离(节点操作数),Size(T_{gt})表示标准答案树的节点总数,则相对编辑距离: $$ r = \frac{\text{Distance}(T_{gt}, T_{gen})}{\text{Size}(T_{gt})} $$ EED Score 的分段函数: $$ \text{score} = \begin{cases} 100, & \text{如果 } r = 0 \quad (\text{完全一致}) \ 60 - 100r, & \text{如果 } 0 < r < 0.6 \ 0, & \text{如果 } r \geq 0.6 \end{cases} $$
发现:
- 即便是最强LLM(Gemini 2.5 Pro),得分也远低于人类基线(49.5 vs 70.4)
- 模型常在物理场景理解(如动力学关系、变量识别)和长链符号推理(如多步方程求解)两方面出错
OTC: Optimal Tool Calls via Reinforcement Learning

使用RL提升LLM的tool-using能力,当前LLM存在tool overuse和tool underuse的问题。
引入“工具生产力”(Tool Productivity)指标,衡量每一次工具调用带来的正确答案数量,同时提出了Optimal Tool Call-controlled Policy Optimization (OTC-PO) 框架,通过强化学习(RL)奖励函数显式地鼓励模型以最少的工具调用获得正确答案。
在奖励设计方面,不仅考虑答案是否正确,还根据工具调用次数与最优调用次数的偏差动态调整,鼓励模型在保证正确率的前提下减少工具调用。具体而言, 对于每个问题和模型,存在一个“最优工具调用数”(即达到正确答案所需的最少工具调用次数)。目标是用最少的工具调用获得正确答案。
具体设计:
- 只有当答案正确时,工具调用效率奖励才生效(防止reward hacking)
- 奖励值随工具调用次数的增加而递减,且当调用次数等于最优值时奖励最高
- 最终奖励 = α × 工具效率奖励 × 正确性奖励
该方法可无缝集成到主流RL算法(如PPO、GRPO)中。
推荐内容
来自各大厂的Agent 指南
Anthropic: Building Effective AI Agents
LangGraph: How to think about agent frameworks
Agent 综述文章:https://arxiv.org/abs/2504.01990
微软AI红队发布的Agentic AI系统安全白皮书:Taxonomy of Failure Mode in Agentic AI Systems
一篇语音AI&Agent长文
一些仓库
GenAI & LLM System Design: 500+ Production Case Studies:汇总了500+genAI & LLM的系统设计
Awesome RAG in Computer Vision:state-of-the-art papers on Retrieval-Augmented Generation (RAG) in Computer Vision
Awesome LLM Apps: collection of awesome LLM apps built with RAG and AI agents
Awesome-MCP-ZH: 一个专为中文用户打造的 MCP资源合集
GitHub MCP Server:GitHub’s official MCP Server
DeepWiki
DeepWiki 由 Cognition Labs 开发,该团队此前以其 AI 编码助手 Devin 闻名。DeepWiki 利用LLMs分析代码仓库,自动提取关键信息并生成结构化知识库文档,已索引超过 30,000 个热门 GitHub 仓库,处理超过 40 亿行代码,并集成LLM对文档进行提问。用户只需将 GitHub 仓库的 URL(如 https://github.com/user/repo)中的 “github” 替换为 “deepwiki”(如 https://deepwiki.com/user/repo),即可在几秒内访问增强文档,无需注册。
教程
OpenAI Academy:OpenAI 提供的ChatGPT教学
HuggingFace-Reasoning-Course: Huggingface 和unsloth 推出的open-R1 reasoning 模型的building教学,作为LLM系列课程的补充。
Tutorial: Train your own Reasoning model with GRPO: Unsloth推出的reasoning 模型训练教学
Reinforcement Learning from Human Feedback — Nathan Lambert: A short introduction to RLHF and post-training focused on language models.
JoyRL Book: 强化学习实践教程
影音记录
精选歌单
Live演出
- 04.05 Lise de la Salle
- 04.10 This will destroy you
- 04.17 YIN YIN & Tokyo Ska Paradise Orchestra
- 04.18 水中スピカ
- 04.19 峰厚介四重奏
电影
《孤独的美食家剧场版》
《黎明的一切》
《黑镜》第7季
书&阅读摘录
The case against conversational interfaces
When people say “natural language” what they mean is written or verbal communication. Natural language is a way to exchange ideas and knowledge between humans. In other words, it’s a data transfer mechanism.
Data transfer mechanisms have two critical factors: speed and lossiness. … We are significantly faster at receiving data (reading, listening) than sending it (writing, speaking). … To put the writing and speaking speeds into perspective, we form thoughts at 1,000-3,000 words per minute. … but whenever possible we switch to other modes of communication that are faster and more effortless. Speed and convenience always wins.
These text-based commands were effectively a natural language interface, but required precise syntax and a deep understanding of the system. … It’s faster to click a button than to type a long text command. … Touch-based interfaces are considered the third pivotal milestone in the evolution of human computer interaction
The core problem was never the quality of the output function, but the inconvenience of the input function: A natural language prompt like “Hey Google, what’s the weather in San Francisco today?” just takes 10x longer than simply tapping the weather app on your homescreen. LLMs don’t solve this problem. The quality of their output is improving at an astonishing rate, but the input modality is a step backwards from what we already have. Why should I have to describe my desired action using natural language, when I could simply press a button or keyboard shortcut? Just pass me the goddamn butter.
For this future to become an actual reality, AI needs to work at the OS level. It’s not meant to be an interface for a single tool, but an interface across tools.Kevin Kwok famously wrote that “productivity and collaboration shouldn’t be two separate workflows”. … The second thing we need to figure out is how we can compress voice input to make it faster to transmit.
This isn’t really a case against conversational interfaces, it’s a case against zero-sum thinking. … The future isn’t about replacing existing computing paradigms with chat interfaces, but about enhancing them to make human-computer interaction feel effortless
低质量内容看多了,脑子真的会烂掉
它形容的是一个人因过度消费琐碎、无意义的互联网内容与资讯,而引起的精神或智力状态的恶化。
引发「脑腐」的第二个因素,是长时间无节制地消费琐碎、无意义、低质量的内容或资讯
「脑腐」对大脑认知的影响:分散注意力,削弱记忆力
一是控制屏幕时间,二是主动锻炼大脑,让它重新掌握主导权。
阅读后尝试复述核心观点、写下自己的理解,而不是仅仅接受信息
AI Product Managers Will Be In-Demand
I think teams will need more product management work (as well as design work) as a fraction of the total workforce.
AI Product Management requires a different set of skills than traditional software Product Management.
The demand for good AI Product Managers will be huge. In addition to growing AI Product Management as a discipline, perhaps some engineers will also end up doing more product management work.
How Software Engineers Actually Use AI
The realists see AI as a force multiplier, not a job killer—automating repetitive coding but leaving the creativity, architecture, and debugging to humans
AI isn’t coming for your job—but it is changing it. Adapt or get left behind.🚀
AI Horseless Carriages
I am beginning to suspect that these apps are the “horseless carriages” of the AI era. They’re bad because they mimic old ways of building software that unnecessarily constrain the AI models they’re built with.
There is a simple solution to this problem that many AI app developers seem to be missing: let me write my own “System Prompt”.
The modern software industry is built on the assumption that we need developers to act as middlemen between us and computers. … By splitting the prompt into System and User components, we’ve created analogs that map cleanly onto these old world domains.
AI-native software should maximize a user’s leverage in a specific domain.
The Second Half
tldr: We’re at AI’s halftime
That illustrates the game of the first half: focus on building new models and methods, and evaluation and benchmark are secondary
This game is being ruined because: The recipe has essentially standardized and industried benchmark hillclimbing without requiring much more new ideas … Even if we create harder benchmarks, pretty soon (and increasingly soon) they get solved by the recipe … I think we should fundamentally re-think evaluation. It means not just to create new and harder benchmarks, but to fundamentally question existing evaluation setups and create new ones, so that we are forced to invent new methods beyond the working recipe.
our evaluation setups are different from real-world setups in many basic ways Evaluation “should” run automatically, … Evaluation “should” run i.i.d.
This game is hard because it is unfamiliar. But it is exciting. While players in the first half solve video games and exams, players in the second half get to build billion or trillion dollar companies by building useful products out of intelligence. While the first half is filled with incremental methods and models, the second half filters them to some degree. The general recipe would just crush your incremental methods, unless you create new assumptions that break the recipe. Then you get to do truly game-changing research.
让我们来治愈一下《黑镜》带来的致郁
原初丰裕论:技术与幸福的反比 … 人类进入农业社会并不是因为早期农业社会能提供更好的个体福祉,而是早期农业社会能够支撑更多的人口,转过来消灭了狩猎采集社会。这是一种典型的“同态压力”。 … 农业革命说明了一点:技术的进步并不必然等同于个体幸福的提升。进入农业社会,反而让人类个体的“生活质量”降低了 … 农业革命的遗产提醒我们,技术的发展往往伴随着意料之外的代价,而这些代价可能需要数代人来消化。
这引发了一个核心问题:我们究竟想要一个完全服从的 AI,还是一个能够独立思考的 AI? … 康德认为,道德行为应以意图而非结果来评判 … 人类自身是否能够对齐? … 人类是过去环境演化的产物,而演化本身就充满了冲突,不讲道理,将就凑合,补丁和 hack。一旦面临新的环境,无法适应无法接受就成了必然的 … 人类对于所谓的技术文明的适应程度,实际上是很可疑的
人类不可能再回到狩猎采集社会,我们只能向前。每一代人都试图定义“好的生活”,却发现下一代人对“好”的理解截然不同。每一代人都觉得自己这一代的生活是某种神圣的,天经地义无法改变的,完美的生活方式,而每一代人也都会变成错的。