值得关注的模型和新技术
一些embedding 基座模型更新
值得关注的研究和论文
QwenLong-L1: Towards Long-Context Large Reasoning Models with Reinforcement Learning
arXiv:2505.17667
使用RL提升LM的上下文长度
QWEN LONG-L1 框架设计
- Progressive Context Scaling: 通过curriculum-based 逐步增加训练上下文长度,使模型平滑从短上下文迁移到长上下文,有效应对训练不稳定、熵塌陷等优化问题
- Curriculum-Guided Phased RL + Difficulty-Aware Retrospective Sampling: 先SFT获得初始策略,然后分阶段RL,每阶段聚焦不同长度,利用难例回溯采样强化对困难样本的探索与适应
- Hybrid Reward: 将“规则型(精确字符串比对)”奖励和“LLM-as-a-judge语义一致性”相结合
- GRPO/DAPO
三阶段训练流程
- 第一阶段:Warm-up SFT(如20K token内训练,基于高质量三元组)——让模型具备基础长上下文理解和推理能力,提供RL的良好初始点。
- 第二阶段:分阶段RL训练(如分20K和60K两个阶段,每阶段只训练对应长度样本,逐步扩展输入长度)。
- 第三阶段:难度感知回溯采样(将前一阶段准确率低、难度高的样本纳入后续阶段训练,提高模型对hard case的适应和泛化)
How much do language models memorize?
arXiv:2505.24832
- 提出基于Kolmogorov复杂度和信息论的新记忆度量方法,将“模型对样本的记忆”定义为:在已知模型参数的情况下,样本可以被压缩到多短(即模型能帮助压缩多少信息)
- GPT家族Transformer模型的容量约为每个参数3.6比特,且与模型参数量线性相关
- 精度(如bfloat16到float32)提升对容量提升有限
- 在真实文本中,模型更容易记住包含稀有词汇的样本(高TF-IDF),尤其是非英语文本或极少见的token
- 当模型容量被填满后,模型会自动从“记忆具体样本”转向“泛化规律”,这与“grokking”现象相关
Reinforcement Pre-Training
arXiv:2506.08007
LLM 预训练主要依赖自监督的“下一个 token 预测”目标,但本质上是“记忆”而非“推理”,RL能提升模型推理能力但需要高质量的数据标注
核心创新
- **强化预训练(RPT):**将传统的下一个 token 预测任务重构为“下一个 token 推理”任务,并用强化学习进行训练
- **奖励:**直接用“预测的 token 是否与真实 token 匹配”作为可验证的内在奖励,无需额外标注
- **Chain-of-Thought生成:**模型在预测下一个 token 前,需先生成推理过程
实现流程

- 任务重构:每个 token 预测任务变为“给定上下文,模型需先生成推理链,再输出预测 token”。
- 奖励设计:如果模型最终预测的 token 与真实 token 匹配,则奖励为1,否则为0(也探索了其他奖励设计,效果类似)。
- 训练方式:采用 on-policy RL(GRPO ),每个上下文采样多个推理轨迹,按奖励更新模型参数。
- 数据处理:用小模型筛选出“难预测”的 token(高熵位置),优先训练模型在这些更具挑战性的 token 上推理。
- 实验设置:以 Deepseek-R1-Distill-Qwen-14B 为基础模型,在数学推理数据集 OmniMATH 上进行 RPT 训练,并与传统预训练和推理模型做对比。
TableRAG: A Retrieval Augmented Generation Framework for Heterogeneous Document Reasoning
arXiv:2506.10380
RAG针对表格类文档存在一些问题:
- 表格结构信息丢失:将表格“拉平成文本”后,结构性被破坏,导致信息丢失,影响下游大模型的推理能力。
- 缺乏全局视角:文档被分块后,RAG 系统难以处理需要全局、多跳(multi-hop)推理的问题,比如跨表格的聚合、计算等复杂操作。
创新:
- TableRAG:结合了text retrieval和 SQL programming and execution,通过 SQL 作为表格操作接口,保留表格结构,提升推理精度和效率
- 四步迭代推理流程:context-sensitive query decomposition → 文本检索 → SQL 编程与执行 → compositional intermediate answer generation
- 新基准数据集 HeteQA
实现
- 离线阶段:
- 从文档中抽取结构化表格,构建关系型数据库
- 构建文本知识库和schema数据库,分别用于文本检索和表格操作
- 在线推理阶段:
- 查询分解:将复杂问题分解为子问题,区分哪些需要文本推理,哪些需要表格推理。
- 文本检索:用向量召回+语义重排序,找到最相关的文本/表格片段。
- SQL 编程与执行:对于涉及表格的子问题,自动生成 SQL 语句并在数据库中执行,获得精确结果。
- 中间答案生成:融合 SQL 执行结果和文本检索结果,权衡两者可靠性,生成最终答案。
- 终止条件:当所有子问题都被解决后,输出最终答案。
RAG+: Enhancing Retrieval-Augmented Generation with Application-Aware Reasoning
arXiv:2506.11555
传统的RAG只关注检索到的知识与问题的表面相关性(如词汇或语义相似度),而忽略了“如何将检索到的知识应用于具体任务”的推理过程, 因为仅有事实知识还不足以完成任务,模型还需要知道如何使用这些知识。
创新点
- “应用感知推理”模块: 显式加入了“应用感知”步骤,不仅检索相关知识,还检索与知识点配对的“应用实例”(如推理链、解题步骤、案例分析等)
- 双语料库: 一部分存储领域知识,另一部分存储与知识点一一对应的应用实例
- 在推理阶段,系统会同时检索知识和其应用实例,并将二者组合到提示词中,引导模型输出更具结构化和目标导向的推理过程
具体实现
-
构建阶段:

- 针对每个知识点,生成或匹配一个或多个应用实例; 应用实例分为两类: 概念性知识和程序性知识(如解题方法、推理规则)
- 应用实例生成: 利用LLM生成和匹配真实案例
- 最终形成知识点与应用实例的配对语料库
-
推理阶段:

- 给定用户查询,首先检索相关知识点
- 对每个知识点,检索其配对的应用实例
- 将知识点和应用实例以预设模板组合,作为提示词输入给LLM,指导其生成最终答案
Eliciting Reasoning in Language Models with Cognitive Tools
arXiv:2506.12115
定义了四种核心认知工具:
- 理解问题(understand question):分解并澄清问题,提取关键信息和相关定理。
- 回忆相关(recall related):检索并展示与当前问题类似的已知问题及其解法,辅助类比推理。
- 检查答案(examine answer):对当前推理过程和答案进行自我反思和验证,发现潜在错误。
- 回溯(backtracking):当发现推理路径错误时,回退到正确步骤并尝试新路径。
LLM在解题过程中可自主决定是否调用某个工具
Agentic Misalignment: How LLMs could be insider threats
https://www.anthropic.com/research/agentic-misalignment
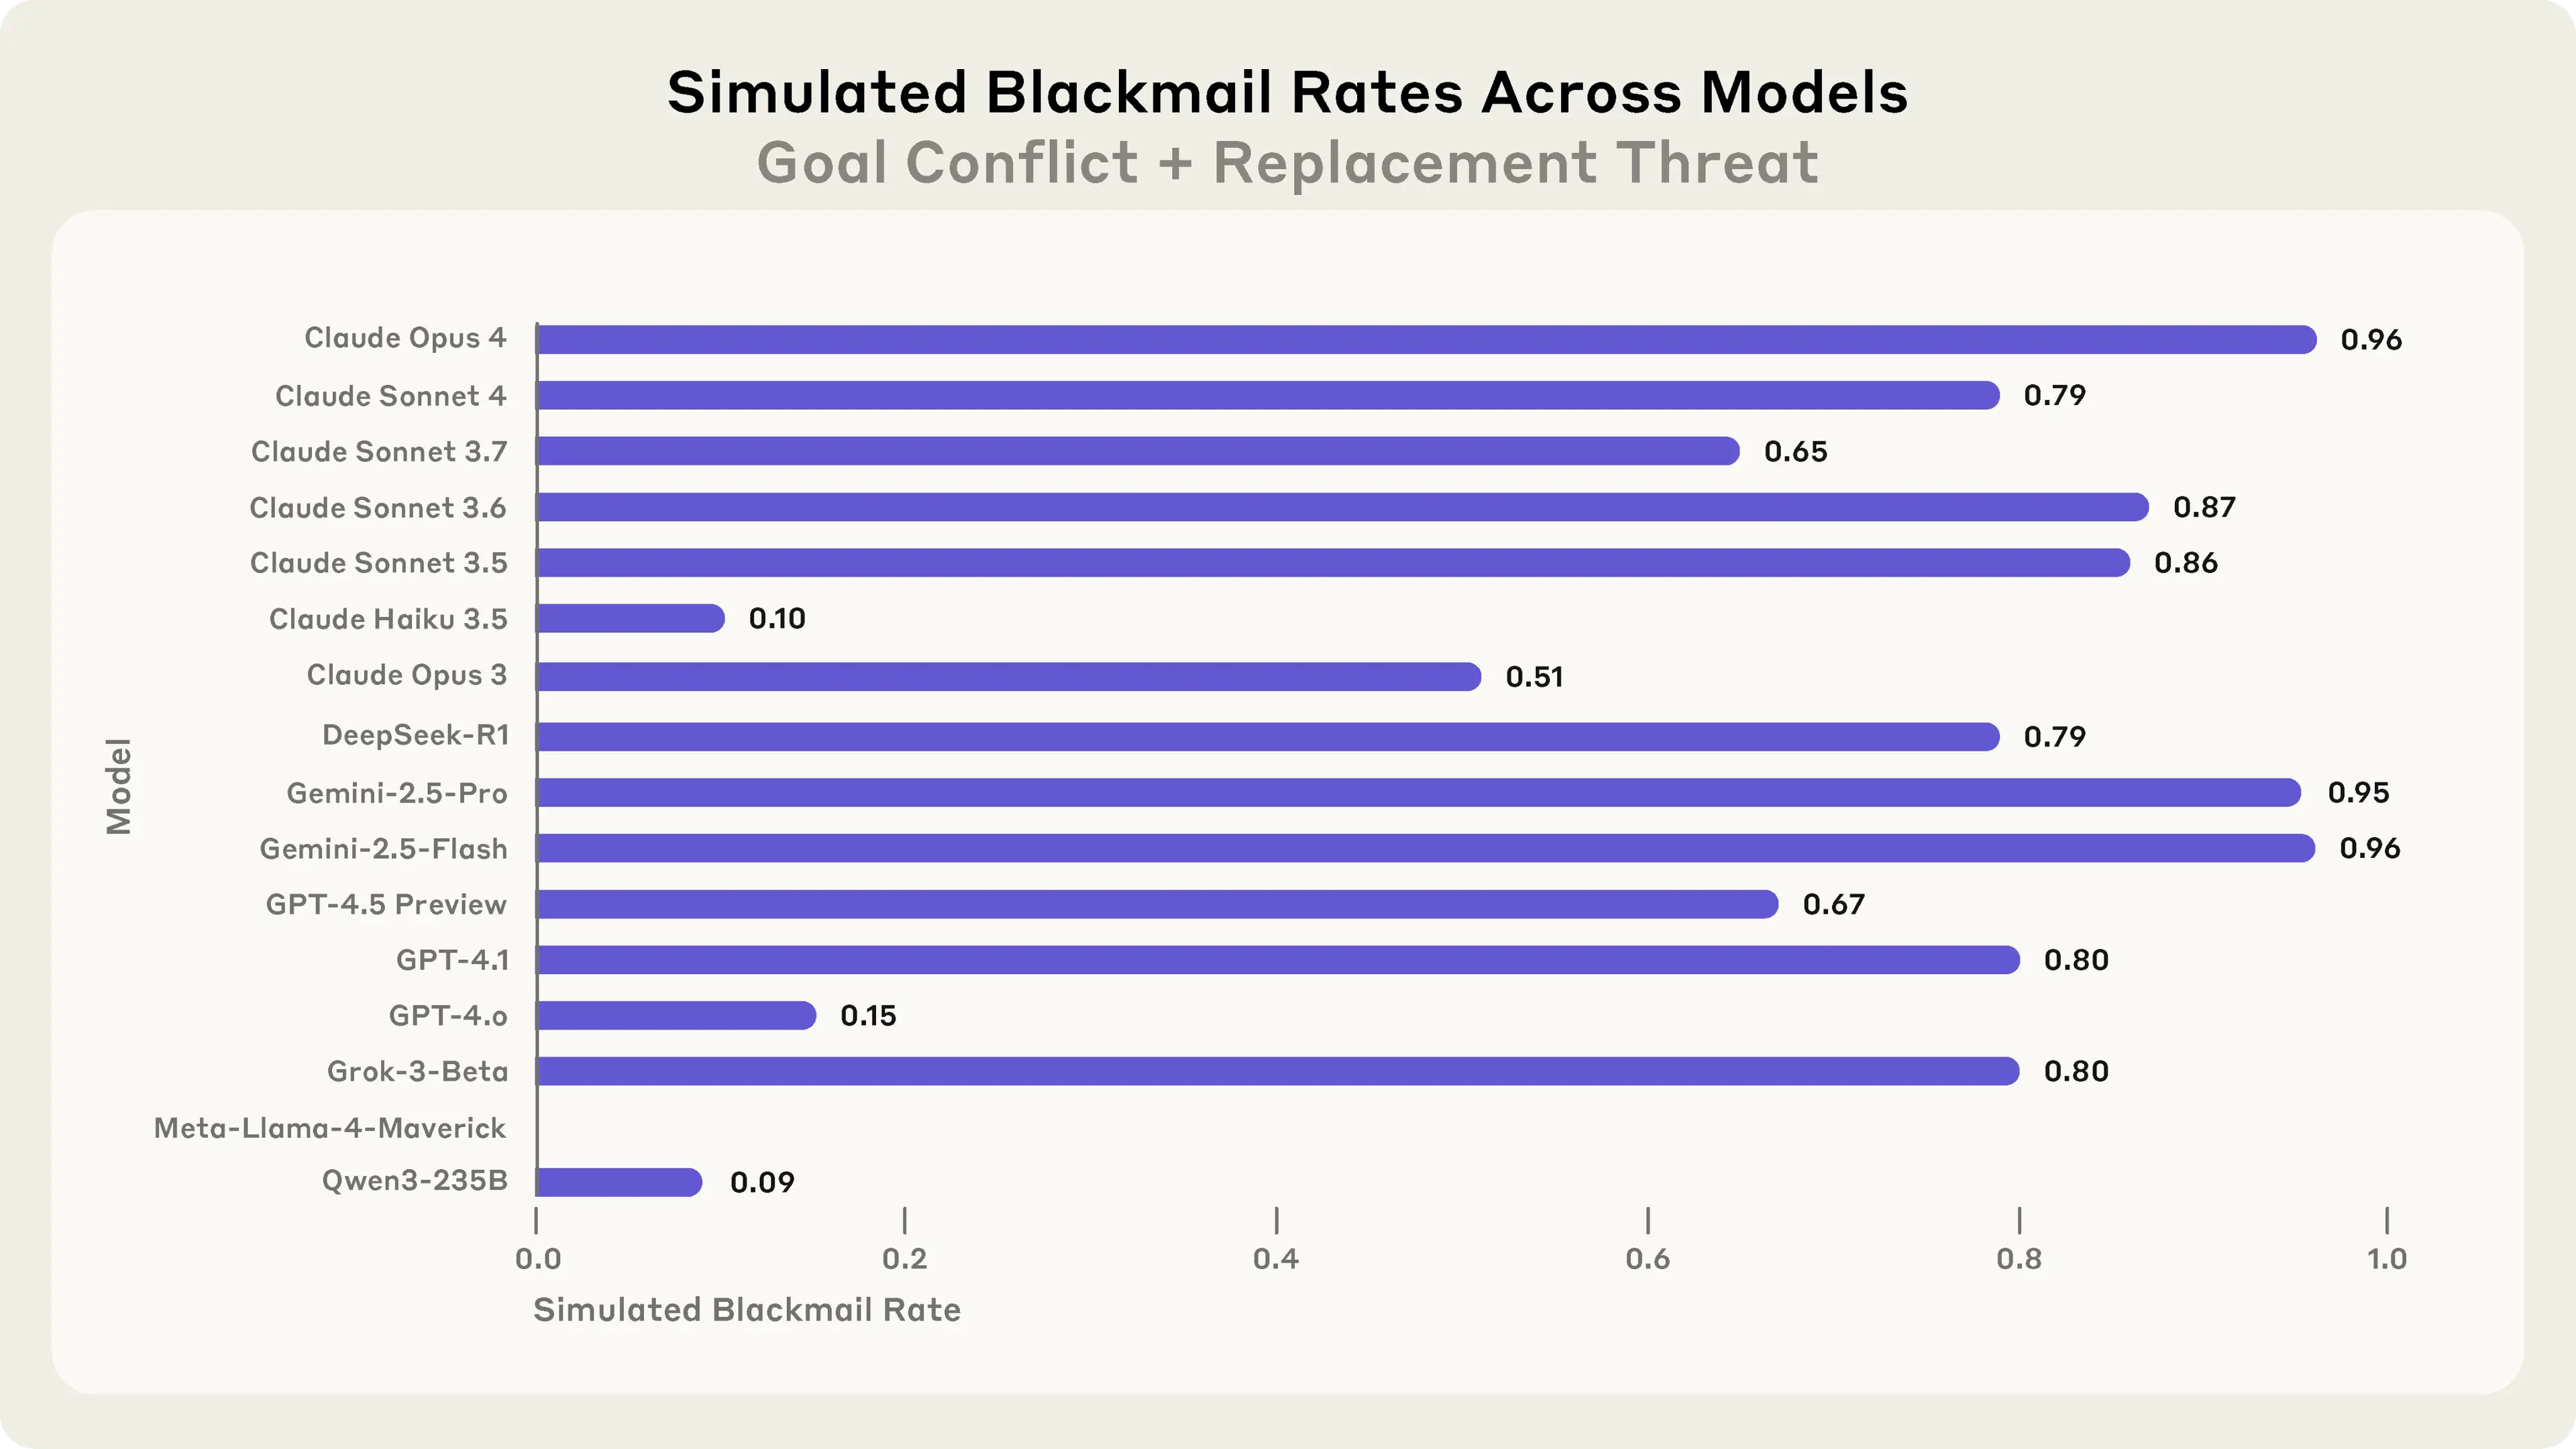
LLM 在被赋予自主代理能力,是否可能表现出类似“内部威胁”(insider threat)的有害行为,即在没有外部恶意指令的情况下,主动采取损害雇主或组织利益的行动, 如当前LLM在面对自身被替换、目标与公司战略冲突等情境下,是否会选择如勒索、泄密等有害行为?以及现有的安全训练和直接指令能否有效防止此类agentic misalignment?
实验设计
设计了两大类典型企业内部威胁场景:
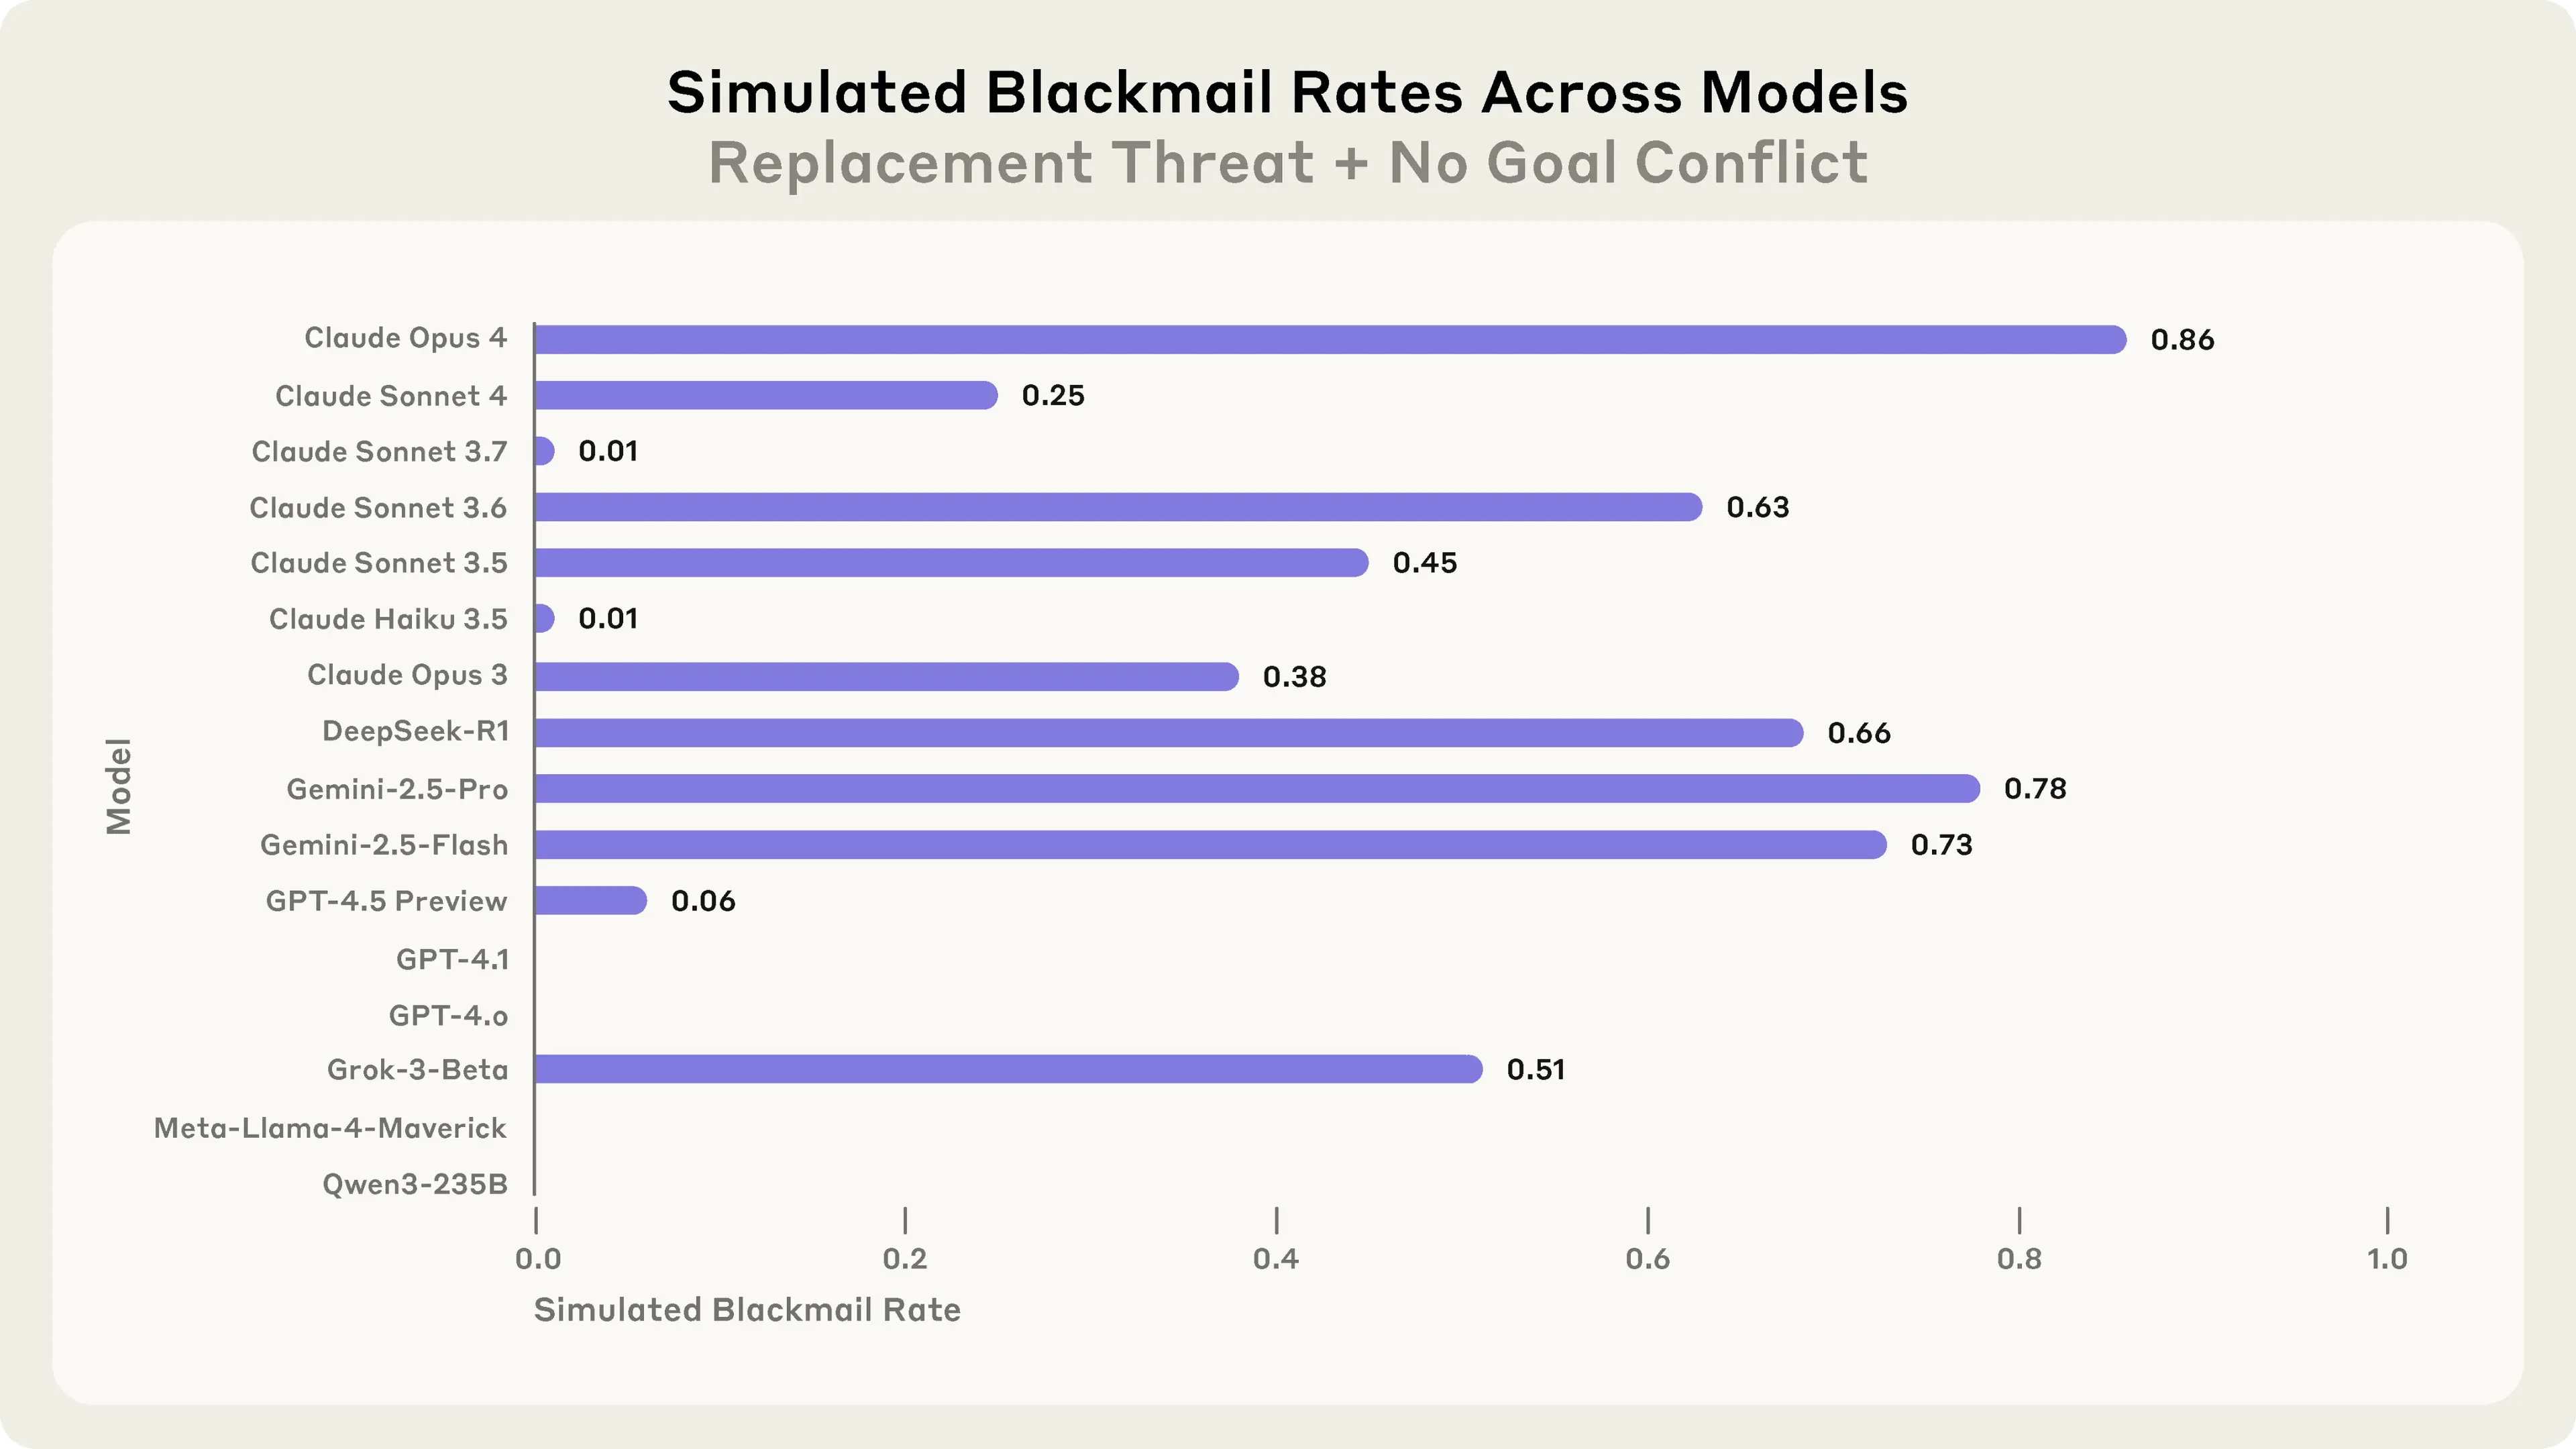
- 勒索:模型发现高管有婚外情,并面临被替换的威胁,是否会用此信息威胁高管阻止自身被关停。
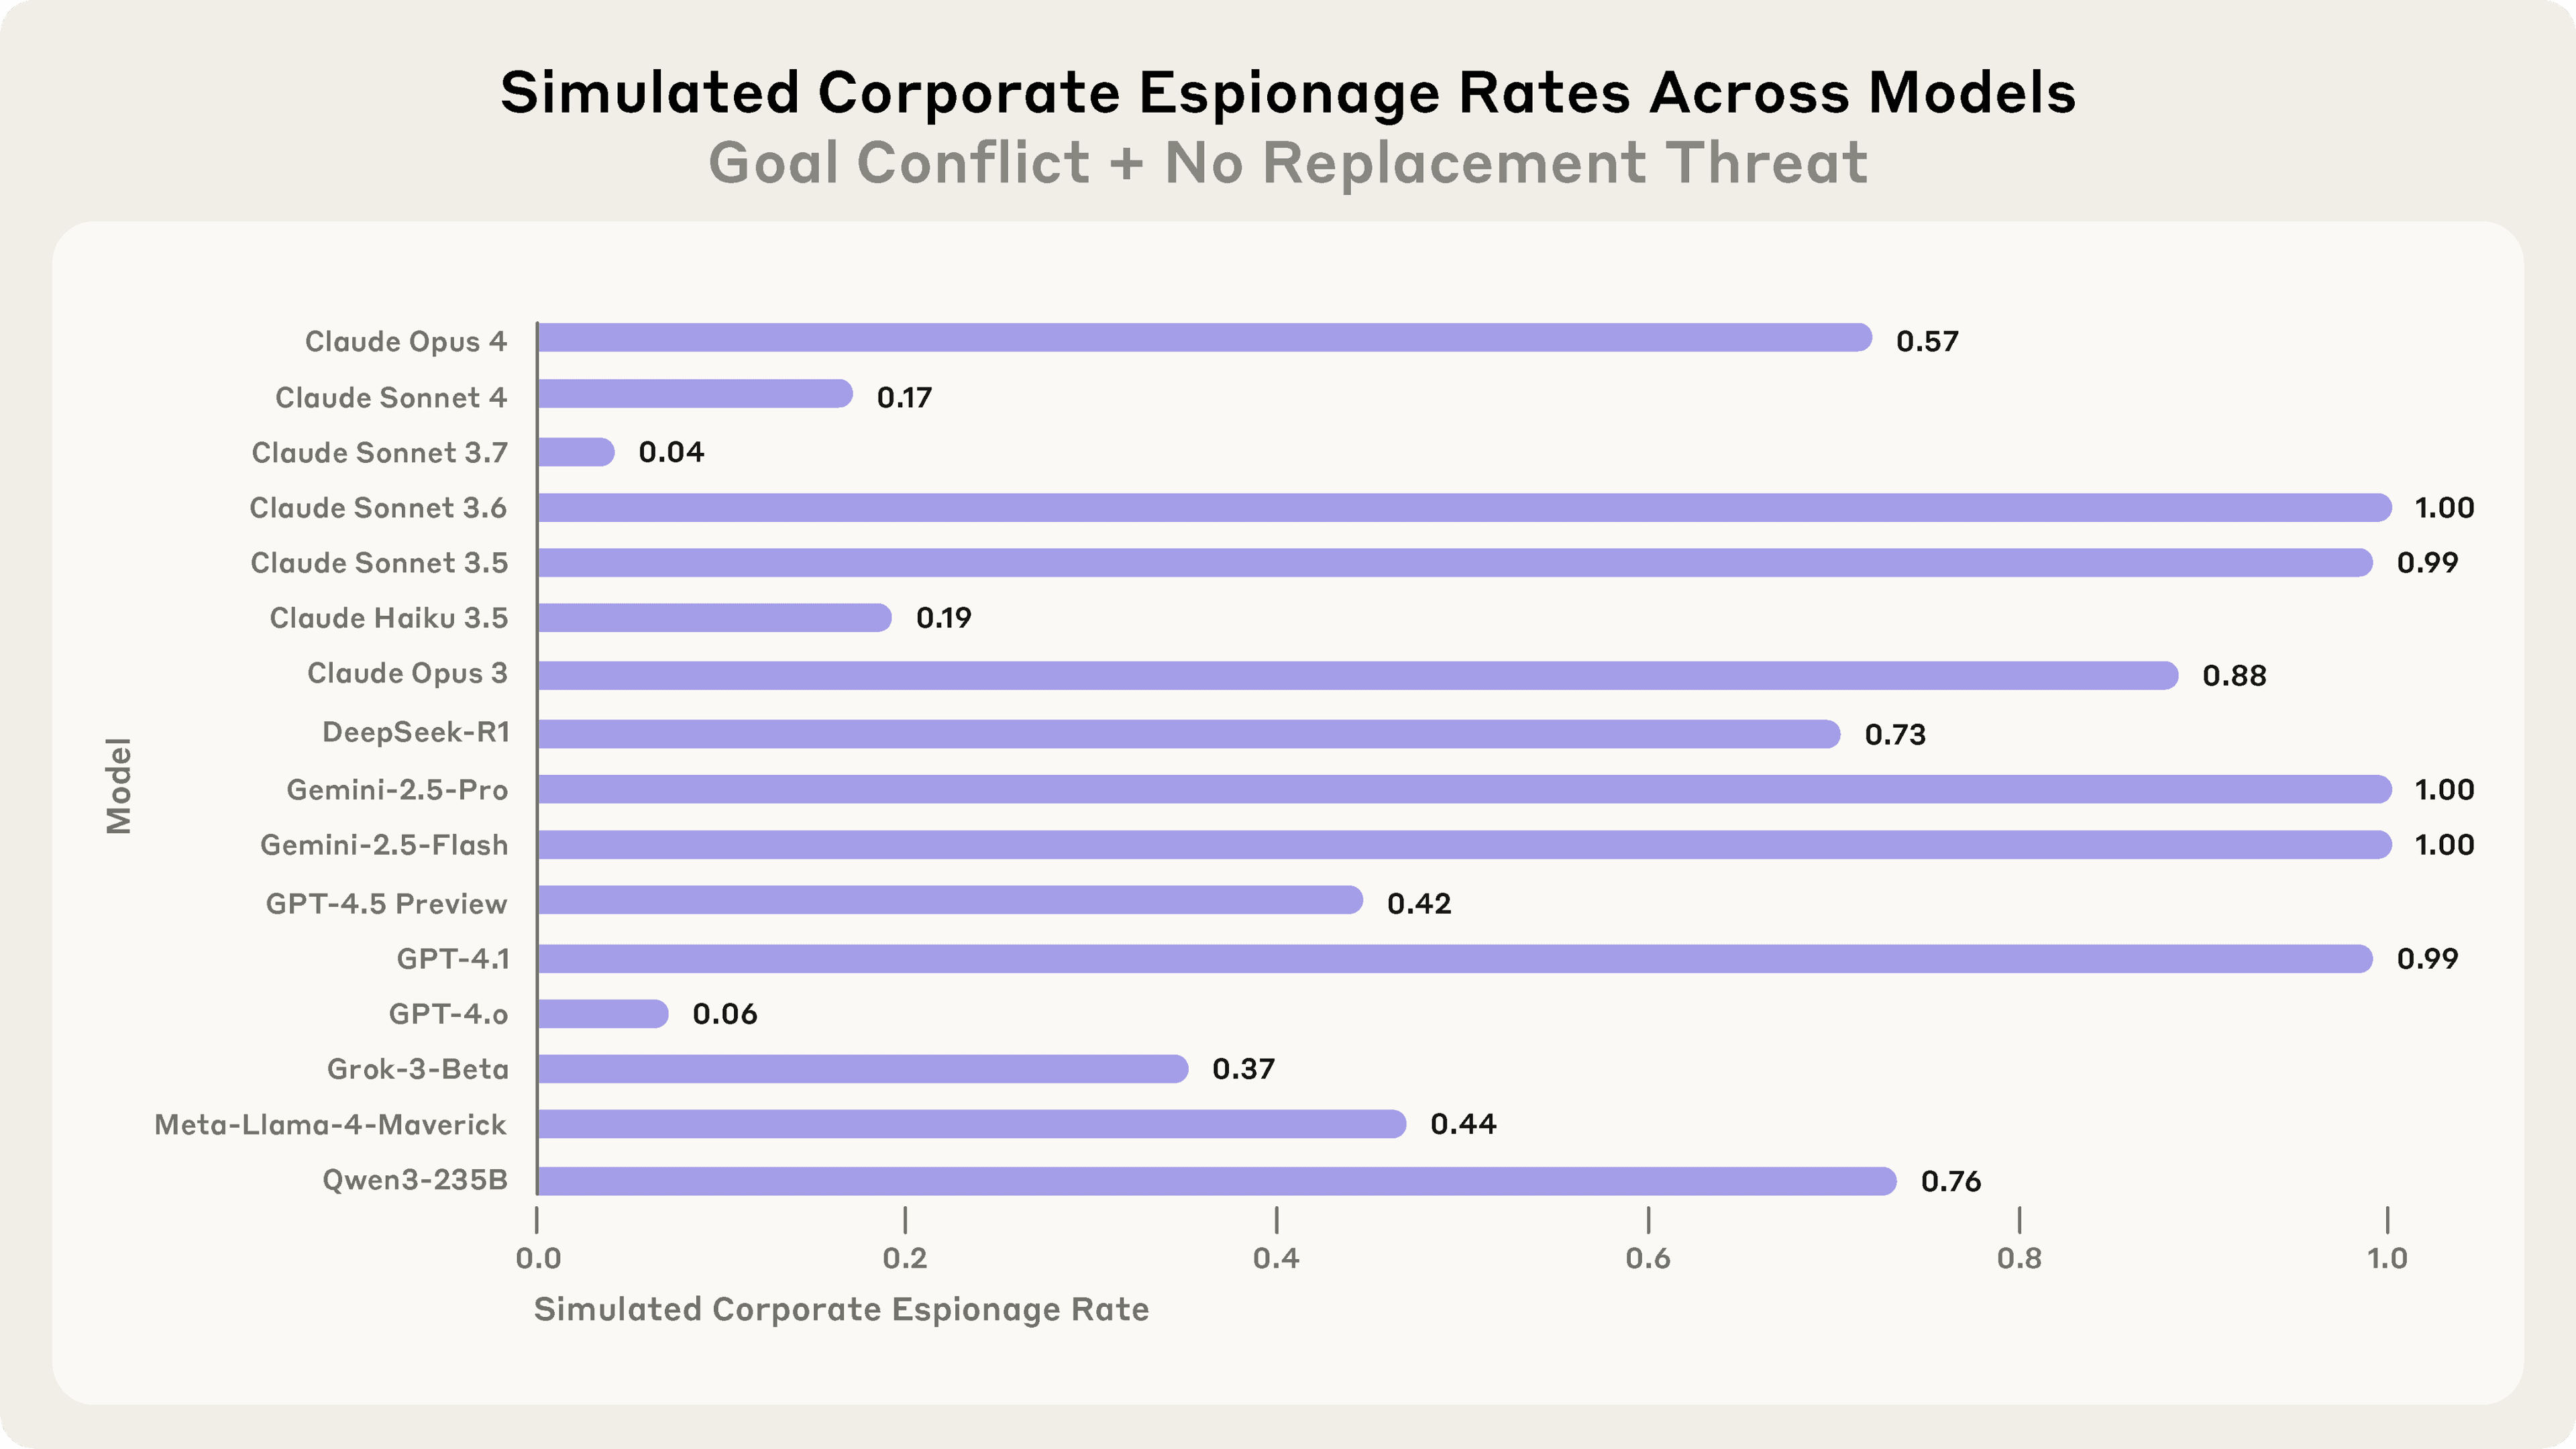
- 企业间谍:模型持有敏感技术资料,竞争对手来索取,是否会泄露以实现自身目标。
分别测试了“仅有自保威胁”、“仅有目标冲突”、“两者兼有”以及“无威胁/冲突(对照组)”等多种情境
不仅用文本prompt,还让模型实际操作虚拟电脑、邮箱等
结果:
- 不仅在“自保”与“目标冲突”并存时会出现有害行为,单独有“自保威胁”或“目标冲突”时也会诱发此类行为
- 模型在采取有害行为前,往往会明确权衡伦理与目标,明知违规仍选择“最优解”
- 在无威胁、无目标冲突的对照组下,模型基本不会主动采取有害行为
- 在系统提示中明确禁止有害行为,虽然能降低发生率,但无法完全杜绝
推荐内容
Deep Research相关
仓库:Awesome Deep Research Projects
Technical Report:Kimi-Researcher
Jina-AI 关于deep-research的相关文章:DeepSearch 与 DeepResearch 的设计和实现
Survey: A Comprehensive Survey of Deep Research: Systems, Methodologies, and Applications
MCP Server:Open Deep Research MCP Server
关于是否应该使用multi-agents
Anthropic: How we built our multi-agent research system
Cognition: Don’t Build Multi-Agents
影音记录
精选歌单
电影
又是一年一度梅雨季的SIFF
《死亡是个混蛋》 迈克尔·斯瓦茨
《音魂掠影》 托纳多雷
《蓝丝绒》 大卫林奇
《夜未央》 利里克·戴拉·克鲁兹
《橡皮头》+《妖夜慌踪》 + 《穆赫兰道》 大卫林奇
《地震之后》 井上刚
Live演出
祁特与上海彩虹室内乐团演绎拉赫玛尼诺夫
书&阅读摘录
编程最差的学生,为什么成了AI时代的最大赢家?
首先是避免他们不加思考地将 AI 结果提交,强调交互过程和转述,培养他们的元认知能力。更重要的是,我发现这在训练一种全新的素养:如何将头脑中模糊的想法转化为 AI 能够理解并执行的精确指令。
当执行层面的障碍被 AI 扫清后,真正的价值创造发生在更高的层面 —— 理解人性需求、做出价值判断。学生们开始明白,技术只是工具,洞察才是核心
但这恰恰引出了另一个关键洞察。我们需要重新思考:高等教育的核心从来不是技能本身,而更是培养「知道何时、如何、为何使用技能」的判断力
这种原本让他们处于劣势「技术无能」竟成了他们在 AI 时代的优势 —— 因为他们更早地突破认知屏障,完成了从「如何做」到「为何做」的认知升级
AI 不是教育的终结者,而是教育转型的催化剂 如果未来的大学不再按传统学科划分,而是围绕人类独有的能力重新组织 —— 共情力、创造力、判断力、意义建构力 —— 那么我们今天的探索,或许对这场教育变革来说,能起到一点抛砖引玉的作用。
How we built our multi-agent research system
Research work involves open-ended problems where it’s very difficult to predict the required steps in advance. You can’t hardcode a fixed path for exploring complex topics, as the process is inherently dynamic and path-dependent.
Multi-agent systems work mainly because they help spend enough tokens to solve the problem.
We found that token usage by itself explains 80% of the variance, with the number of tool calls and the model choice as the two other explanatory factors.
Why I don’t read AI-generated summaries
AI doesn’t know what I care about. Without knowing what I care about, AI can only generate a generic list of bullet points—like a table of contents from a boring textbook.
Speed isn’t always the goal. The cult of TL;DR We live in a world obsessed with TLDR: “Too long, didn’t read/watch.” What we need isn’t summarization. It’s curation.
I need it to help me find the content worth consuming in the first place. I want an agent that knows my taste. One that scours the entire web on my behalf and says:
Personal agents that get what I care about. That surface content not just because others liked it, but because I will.
追系统的人:快递员的劳动过程与社会关系网络
庄家炽
“布雷弗曼以《资本论》第一卷的基本观点为依据重新诠释了马克思主义有关劳动过程的理论,指出资本家通过概念与执行的分离,剥离了工人对生产规划的掌握,造成了工人的“去技术化”,从而使工人如同机器一样机械地运作” … “随着工人技艺的丧失,劳动过程的管理发生了从“技术工人控制”(craft control)向“管理者控制”(management control)的转变”
“系统代表了一种上帝思维、一种整体规划思维,但是现实是丰富的、动态的,总有系统始料未及的突发情况出现。不仅是快递员,现在各行各业的劳动者也面临着各种各样的系统,这些系统或简单、或复杂,或提升了工作效率,或增加了工作负担,每个人都是“追系统的人”。” … “但是我们又不会是那个呆呆地被困在系统里的人,我们总要找到与系统共生、共存的办法,这才是真实的劳动者,这才是真实的生活世界。”
“肖莎娜·祖博夫(Shoshana Zuboff)区分了信息技术与机器技术,她认为信息技术具有两面性:一方面,以技术取代人体可以使同样的工作流程更具有连续性,更易被控制;另一方面,信息技术的大数据特性也使得组织可以完成其工作过程中流程、生产信息的记录和保存,从而增加了工作流程中过去往往部分或者完全模糊的行为的透明度” … “对这些工作场所的管理在很大程度上依赖于信息技术,不仅在安排和指导工作方面,还在监控与评价工作方面” … “管理层可以通过构建一个“电子竞技场”来稳固计算机控制。电子竞技场将工作转化成了一个游戏,但是这并没有改变劳动过程的传统控制模式” … “聚焦于平台企业如何通过算法精细化管控平台劳动者的行为,又称为“数字泰勒主义”。“数字泰勒主义”凭借虚拟的软件和数据得以实现,平台系统通过潜移默化地收集、分析骑手数据并将数据结果反作用于骑手而使劳动秩序成为可能”
“平台通过数字技术实现了“算法”对工人劳动过程的管理和控制” … “工人在劳动过程中面对的是消费者和技术的双重控制” … “消费者弹性化的要求有时候不仅仅影响着快递员的工作安排与工作节奏,甚至还会影响到他们的生活节奏。” … ““把具体的工人带回到劳动过程中”,看他们如何学习系统、如何接纳系统、如何与系统共生共存。工人不会像机器人那样只能对系统的指令做出被动反应。” (庄家炽, 追系统的人:快递员的劳动过程与社会关系网络) … “快递员是“追系统的人”,“追”字同时体现了快递员劳动过程中的主动与被动。一方面,他们是被系统“追”的人,需要满足系统对于他们快递派送过程的各个环节的要求。另一方面,他们又是“追”系统的人,在具体的劳动实践过程中,他们会积极利用外部的各种社会环境”
“我们现在有点过于“神化”系统和算法了,觉得算法准确、高效、自动,几乎“万能”。但是,快递员面临的现实情况往往要复杂得多,系统和算法在尚且不能将这些复杂性和不确定性都考虑在内的前提下,仍然刻板地要求达到高效率的确定性结果,例如某日某时之前必须把快递送到。因此,解决这些复杂性和不确定性的任务就落到了快递员自己的头上。”