值得关注的模型和新技术
值得关注的开源项目
FineVision:Open Data Is All You Need
Parlant: LLM agents built for control. Designed for real-world use.
Claude Code Comprehensive Guide
Dayflow: Turns your screen activity into a clean timeline with AI summaries and distraction highlights.
值得关注的研究和论文
MIRAGE: Scaling Test-Time Inference with Parallel Graph-Retrieval-Augmented Reasoning Chains
arXiv:2508.18260
提出了**Parallel Multi-chain Inference,**将一个复杂问题分解成多个子问题,为每个子问题启动一个独立的、并行的推理链
提出了**Adaptive Graph-based Retrieval,**与一个结构化的医学知识图谱进行交互,在推理过程中,模型可以动态地通过邻居节点扩展、多跳路径遍历等方式探索知识图谱中的实体关系和层次结构
MIRAGE框架通过四个协同工作的组件实现其功能:

- Question Decomposer
- Evidence Retriever:为每个子问题启动一个并行的推理链,进行一种“边思考边搜索”的循环;检索分为两种模式:Anchor Mode(当查询涉及单个实体时,检索该实体在图谱中的局部邻居信息);Bridge Mode (当查询涉及两个实体时,在图谱中寻找连接这两个实体的关系路径)
- Answer Synthesizer:收集所有并行推理链生成的答案和证据,并交叉验证
- Coordinator:管理以上三个组件的执行流程
Why Language Models Hallucinate
提出了基于socio-technical视角来解释幻觉的持续存在。指出,问题的根源不仅仅在于模型或算法本身,更在于评估手段— 特别是主流的benchmark多采用非黑即白的二元评分,鼓励模型“赌一把”而不是如实承认 “不知道”。
On the Theoretical Limitations of Embedding-Based Retrieval
arXiv:2508.21038
基于single vector embedding的检索模型是否存在根本性的理论上限?
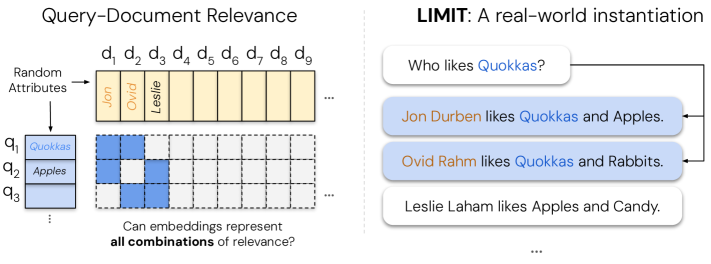
对于任何固定维度的嵌入模型,都存在一些它永远无法表示和检索的“相关文档组合”,这是由向量空间本身的几何特性决定的一个根本性限制
定义:
将检索问题形式化为一个m \times n的相关性矩阵 A(m个查询,n个文档)。嵌入模型的目标是学习一个得分矩阵B(由查询向量和文档向量的点积生成,m \times n),使得B中每一行的元素排序与A一致(即相关文档的得分高于不相关文档);
行序保持秩 rank_rop(A):让相关文档得分 > 不相关文档得分的最低嵌入维度 d
行级阈值秩 rank_rt(A): 对于每个查询 i,存在一个阈值 τ_i,能将相关和不相关文档的得分分开
全局阈值秩 rank_gt(A): 存在一个全局阈值 τ 对所有查询都有效
sign-rank rank_±(M) 定义: 给定一个矩阵M \in {-1, 1}^{m \times n}, \operatorname{rank}{\pm}(M) = \min { \operatorname{rank}(B) \mid B \in \mathbb{R}^{m \times n} \text{ 并且对于所有 } i, j, \text{ 我们有 } \operatorname{sign}(B{ij}) = M_{ij} }
先给出结论:由于存在sign-rank任意高的矩阵,因此对于任何给定的嵌入维度d,总会存在一个相关性矩阵(即一个检索任务)是它无法表示的
ParaThinker: Native Parallel Thinking as a New Paradigm to Scale LLM Test-time Compute
arXiv:2509.04475

并非思考越长越好
Tunnel Vision, 即模型在生成思考过程的最初几步,一旦犯了错或选择了一条并非最优的路径,就很容易被“锁定”在这条错误的轨道上,后续无论再花多少计算量进行思考和修正,都很难再回到正确的路径上; 因此主流的sequential-thinking,基于“深度”扩展(单一路径加长)策略存在缺陷
对此,提出了Native Parallel Thinking;
- 引入一组Specialized Tokens
<think i>在推理时显式地引导模型开启第i条独立的思考路径 - 为了在汇总阶段解决位置混淆问题,引入thought embedding
- 通过从教师模型采样多条解题路径来构建训练数据,同时,通过两阶段的注意力掩码,确保在“并行思考”阶段各路径相互独立,在“总结”阶段又能看到所有路径的信息
Parallel Reasoning Stage:
- 给定一个问题,模型输入被构造成
[问题] <think 1> <think 2> ... <think P>的形式 - 以batch方式,同时为
P个<think i>Token并行生成P条独立的推理路径 - 当任意一条路径生成EOS或达到预设的Token预算时,所有路径同时停止生成,以保证各路径长度大致均衡
Summarization Stage
上下文整合,直接复用了并行推理阶段生成的KV-Cache,无需re-prefilling。
SFT
使用教师模型,对一个问题多次采样,生成多条不同的解题思路,将这些思路整合成一个训练样本,格式为:[问题] <think 1>[思路1]</think 1> ... <think P>[思路P]</think P> <summary>[最终答案]</summary>。
在训练时,随机选择一部分特殊Token(如从6个可用路径中随机选4个)进行训练,这使得模型能够泛化,在推理时可以生成比训练时更多的并行路径
Reinforcement Learning with Rubric Anchors
arXiv:2508.12790
如何RL的应用范围,从有明确、可自动验证答案的任务,扩展到更广泛、更主观、没有唯一正确答案的开放式任务中
使用一套精心设计的、结构化的、可被模型理解的评分标准(Rubric),来为开放式任务的输出自动打分,并以此作为奖励信号来训练模型
Rubric System设计
首先设计评分准则。每个准则包含多个维度(如创意性、共情能力、逻辑性),每个维度都有明确的评价标准、评分等级和权重;
模型的输出会根据这些准则被打出一个多维度的分数向量;为了让奖励信号更有效,并非简单地加权求和,采用了更复杂的策略:
- 在一些关键维度上失败,则总分直接为零
- 避免模型在单一维度上过度优化而忽略其他维度
- 在高分区间放大分数差异,提供更精细的优化梯度
训练流程
- 在训练前,先用基础模型对候选数据生成回答,再用一个“批评家模型”根据准则打分,只保留得分适中的数据(去掉太简单和太难/低质量的),以提高训练效率
- 第一阶段:使用静态、可验证的准则,专注于训练模型遵循指令和约束的基础能力
- 第二阶段:使用更复杂的、甚至是针对每个样本动态生成的准则,专注于训练开放式、创意和社交等高级能力
如何避免reward-hacking: 专门设计“反作弊”的评分准则
Is In-Context Learning Learning?
arXiv:2509.10414
在传统的机器学习中,“学习”等同于“泛化”, In-Context Learning, ICL , 究竟算不算是一种真正的“学习”?
实验设计
- 测试了4个主流的LLM (GPT-4 Turbo、GPT-4o、Mixtral 8x7B、Phi-3.5 MoE)
- 设计了9个形式化的、基于合成数据的任务, 大致可分成:有限状态自动机可识别的任务(奇偶校验, 模式匹配等)和下推自动机可识别的任务(字符串反转,堆栈操作等)
- 所有任务的数据都是通过带概率的自动机生成的,可通过参数\delta 控制ID和OOD数据分布
- 对每个任务,测试了多种提示策略, 如Modus Ponens(只给范例,没有任务描述), Description(标准的任务描述+范例), CoT,APO(用一个元提示让模型自己优化任务描述),Word Salad / SoT (将Description和CoT中的自然语言文本替换为随机单词)
- eval metrics: Accuracy,并分析其随范例数量和OOD程度关系
一些发现
- 随着范例数量的增加,模型的平均准确率稳步提升,证明ICL确实在从范例中“学习”。然而,其泛化能力有限
- 在极限情况下,模型主要是在学习范例的结构和统计模式,而不是理解自然语言指令的语义
- CoT虽然能提升解决特定问题的能力,但它也让模型过度拟合了范例的分布和推理模式,导致其在OOD场景下的泛化能力变得更差
- ICL并非真正地编码数据内部的因果或逻辑关系。相反,它通过自回归的方式,对上下文中的统计特征进行一种 ad hoc encoding
推荐内容
Writing effective tools for agents — with agents
google:Startup technical guide AI agents
5-Day AI Agents Intensive Course with Google
影音记录
精选歌单
Live演出
09.05 downy |万代2F
09.19 mammal hands |blue notes
09.20 羊文学 |Vas est
09.21 ひとひら & その感激と记录|Vas
09.26 明日の叙景 |Vas
书&阅读摘录
深度|张小珺独家对话OpenAI姚顺雨:语言推理才是AGI主线,交互创新决定创业壁垒
我反而认为模型越强创业机会越大。真正的壁垒是 设计新的交互方式。… 反而如果你只是照搬聊天式助手,很容易被 ChatGPT 替代。
目前大多数公司还没有数据飞轮,只是依赖模型公司能力提升。要形成飞轮,必须具备:① 能够自己训练模型;② 有明确的 reward 去区分好坏数据;③ reward 与业务高度一致
社会网络既有资源集中度,也有边缘跃迁速度。未来可能同时中心化和多元化。
因为 AGI 需要智能、环境和用户 context 三者结合,后两者往往被忽视
最重要的是想清楚你要为用户创造什么价值。技术是工具,理解技术趋势固然重要,但更重要的是产品敏锐度(Product Sense)和第一性思考,找到痛点并提供解决方案
“If someone else can do it, then it’s OK to let them do it.” 这让我相信,如果别人已经在做某件事,我可以选择不去卷,而去探索更具潜力的边界,因为最终目标是为社会创造价值
中美 Agent 创业者闭门:一线创业者的教训、抉择与机会
隐性知识的获取是一个核心挑战,尤其在2B领域。大模型能力不再是主要瓶颈,但是Agent如何能够给到大模型足够的context来实际落地,依然面临几个方面的挑战。 一是默会知识 … 二是协作需要的共识性知识 … 三是企业内部在长期实践中形成的自定义规则
以前软件都是在做工具给人使用,因为工具直接解决问题的成本过高,问题由人来解决
Workflow or Agentic? … 一个实用的选择标准,是看客户的工作是否天然由工作流驱动。对于企业里可以用非常强规则描述的工作,用Workflow去做,会更高效、准确,成本更低,合规性也更好 … 需要多步骤、灵活操作的任务,则更适合交给自主编排Agent … RPA公司沉淀的RPA资产可以转化为MCP Server中的工具,企业原先接入的系统可以直接转化为Agent落地的基础设施优势。
对2B领域的Agent创业者而言,另一个重要决策是在客户选择上:先攻KA(大客户)还是SMB(中小客户)? … 但KA市场有几个不可忽视的挑战:实施成本高昂、决策链条冗长、各部门利益协调复杂。很多项目最终卡在"试点成功但无法推广"的尴尬境地。 … 用中小企业市场快速验证产品价值和商业模式,积累标准化场景,打磨"低实施成本加标准SOP加轻量集成"的产品形态;同时选择性地用能量化价值的案例敲开关键大客户的大门,建立标杆项目
但GUI操作的长期价值仍存在很大争议:GUI本质上是为人类认知优化的界面,对Agent来说并非最优路径。当Agent能直接调用API、操作服务器甚至编写代码时,绕开GUI似乎是更优解。在这种情况下,还有什么必要坚持GUI操作吗? … 我们有两点考虑:一是现实世界过去几十年积累了大量基于GUI的应用,短期内完全绕过并不现实 … 而更深层的原因,在于GUI承载的不仅仅是操作功能,还有丰富的上下文信息。
Writing effective tools for agents — with agents
We conclude with key principles for writing high-quality tools we’ve identified along the way: Choosing the right tools to implement (and not to implement)Namespacing tools to define clear boundaries in functionalityReturning meaningful context from tools back to agentsOptimizing tool responses for token efficiencyPrompt-engineering tool descriptions and specs
To build effective tools for agents, we need to re-orient our software development practices from predictable, deterministic patterns to non-deterministic ones.
Writing Code Is Easy. Reading It Isn’t.
But the hard part isn’t the writing. It’s the reading. It’s the time it takes to load the mental model of the system into your head. That’s where all the cost really is.
Reading code is harder than writing it. Much harder. Writing code is forward motion: you’re laying down fresh pavement. Reading code means retracing someone else’s steps, which usually means jumping between files, chasing function calls, inferring side effects, and deciphering intentions that aren’t written down.
Understanding one function often means looking at five other files. Only after all that do you have enough of a map to even begin.
Maybe it wasn’t the tech after all
The technology acted as a catalyst – a reason to look hard at how work gets done, to invest in skills, and to rethink decision-making.
What the evidence does show, overwhelmingly, is that technology adoption only succeeds when it comes hand-in-hand with organisational change.
Tech without organisational change delivers little benefit