值得关注的模型和新技术
Anthropic introduced Agent Skills
OCR-VL系列:
值得关注的开源项目
MineContext: MineContext is your proactive context-aware AI partner(Context-Engineering+ChatGPT Pulse)
DeepAnalyze: agentic LLM for autonomous data science.
PokeeResearch-7B Agent: Pokee Deep Research Model Open Source Repo
值得关注的研究和论文
ReasoningBank: Scaling Agent Self-Evolving with Reasoning Memory
arXiv:2509.25140
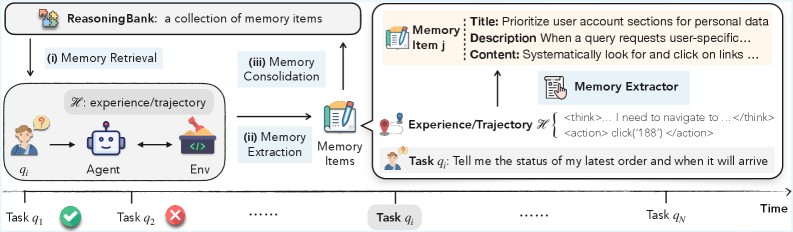
ReasoningBank: 从成功与失败经验中提炼可迁移推理策略的记忆框架
不再存储原始轨迹或仅成功流程,而是提取结构化、可复用的推理单元(title + description + content)
并提出Memory-aware Test-Time Scaling (MaTTS),Test-Time Scaling 与记忆系统结合,更多探索 → 更丰富对比信号 → 更高质量记忆 → 更好指导未来探索, 采用两种扩展方式:Parallel Scaling(多轨迹对比,提取稳定策略)和Sequential Scaling (单轨迹内自我修正)
具体实现
1. ReasoningBank
使用 LLM-as-a-Judge 自动判断轨迹是“成功”还是“失败”, 对成功轨迹:提取“成功策略”, 对失败轨迹:提取“失败教训”或“反面警示”, 输出结构化记忆项, 如:
Title: “使用搜索功能定位商品” Description: “当页面无直接链接时,优先使用搜索框” Content: “在购物网站中,若未找到目标商品,应使用顶部搜索栏输入关键词,而非盲目点击分类”
而后对当前任务embedding,通过语义检索召回相关top-k
将检索到的记忆项注入系统提示
每完成一个任务,自动提取新记忆项,直接追加到记忆库
- MaTTS 实现
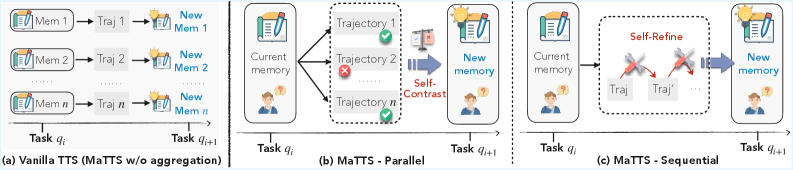
Parallel Scaling: 对同一任务生成 k 条轨迹, self-contrast识别哪些策略导致成功,哪些导致失败,提炼出更鲁棒、可迁移的记忆项
Sequential Scaling: 在单条轨迹内进行多次self-refinement, 每次修正后记录中间推理过程,作为记忆信号
ReSum: Unlocking Long-Horizon Search Intelligence via Context Summarization
arXiv:2509.13313
ReAct会将每一轮的“思考-动作-观察”全部追加到上下文中,导致随着搜索轮次增加,上下文迅速膨胀,最终超出模型的上下文长度限制
ReSum 的核心目标:通过周期性上下文压缩(摘要),让智能体在不丢失关键信息的前提下,突破上下文长度限制。
创新点:
- 在 ReAct 基础上,周期性调用摘要工具,将历史对话压缩为结构化摘要(包含已确认证据 + 信息缺口 + 下一步方向),用摘要 + 原始问题组成“压缩状态”,重启推理,从而绕过上下文长度限制
- 不是直接用通用大模型做摘要,而是专门训练一个30B参数的模型
- 专门设计 ReSum-GRPO算法:自动将长轨迹按摘要点分段,每段作为独立训练样本,将整个轨迹的最终奖励(是否答对)广播到所有分段
Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models
arXiv:2510.04618

在context adaptation中,无需微调权重、仅通过动态演化上下文即可自我改进的框架,即ACE(Agentic Context Engineering)
- Generator + Reflector + Curator: Generator(生成推理轨迹),Reflector(从成功/失败中提炼具体经验),以及Curator(将经验以结构化“增量条目”形式合并进上下文,避免整体重写)
- 上下文不是整体重写,而是以bullet points形式局部更新,每个条目包含元数据和内容
- Grow-and-Refine: 新条目追加,旧条目可更新(如增加计数),并定期通过语义嵌入去重,保持上下文精炼、无冗余,同时支持长期扩展
Mem-α: Learning Memory Construction via Reinforcement Learning
arXiv:2509.25911
如何让 LLM 代理自主学会高效、结构化地构建和管理复杂记忆系统
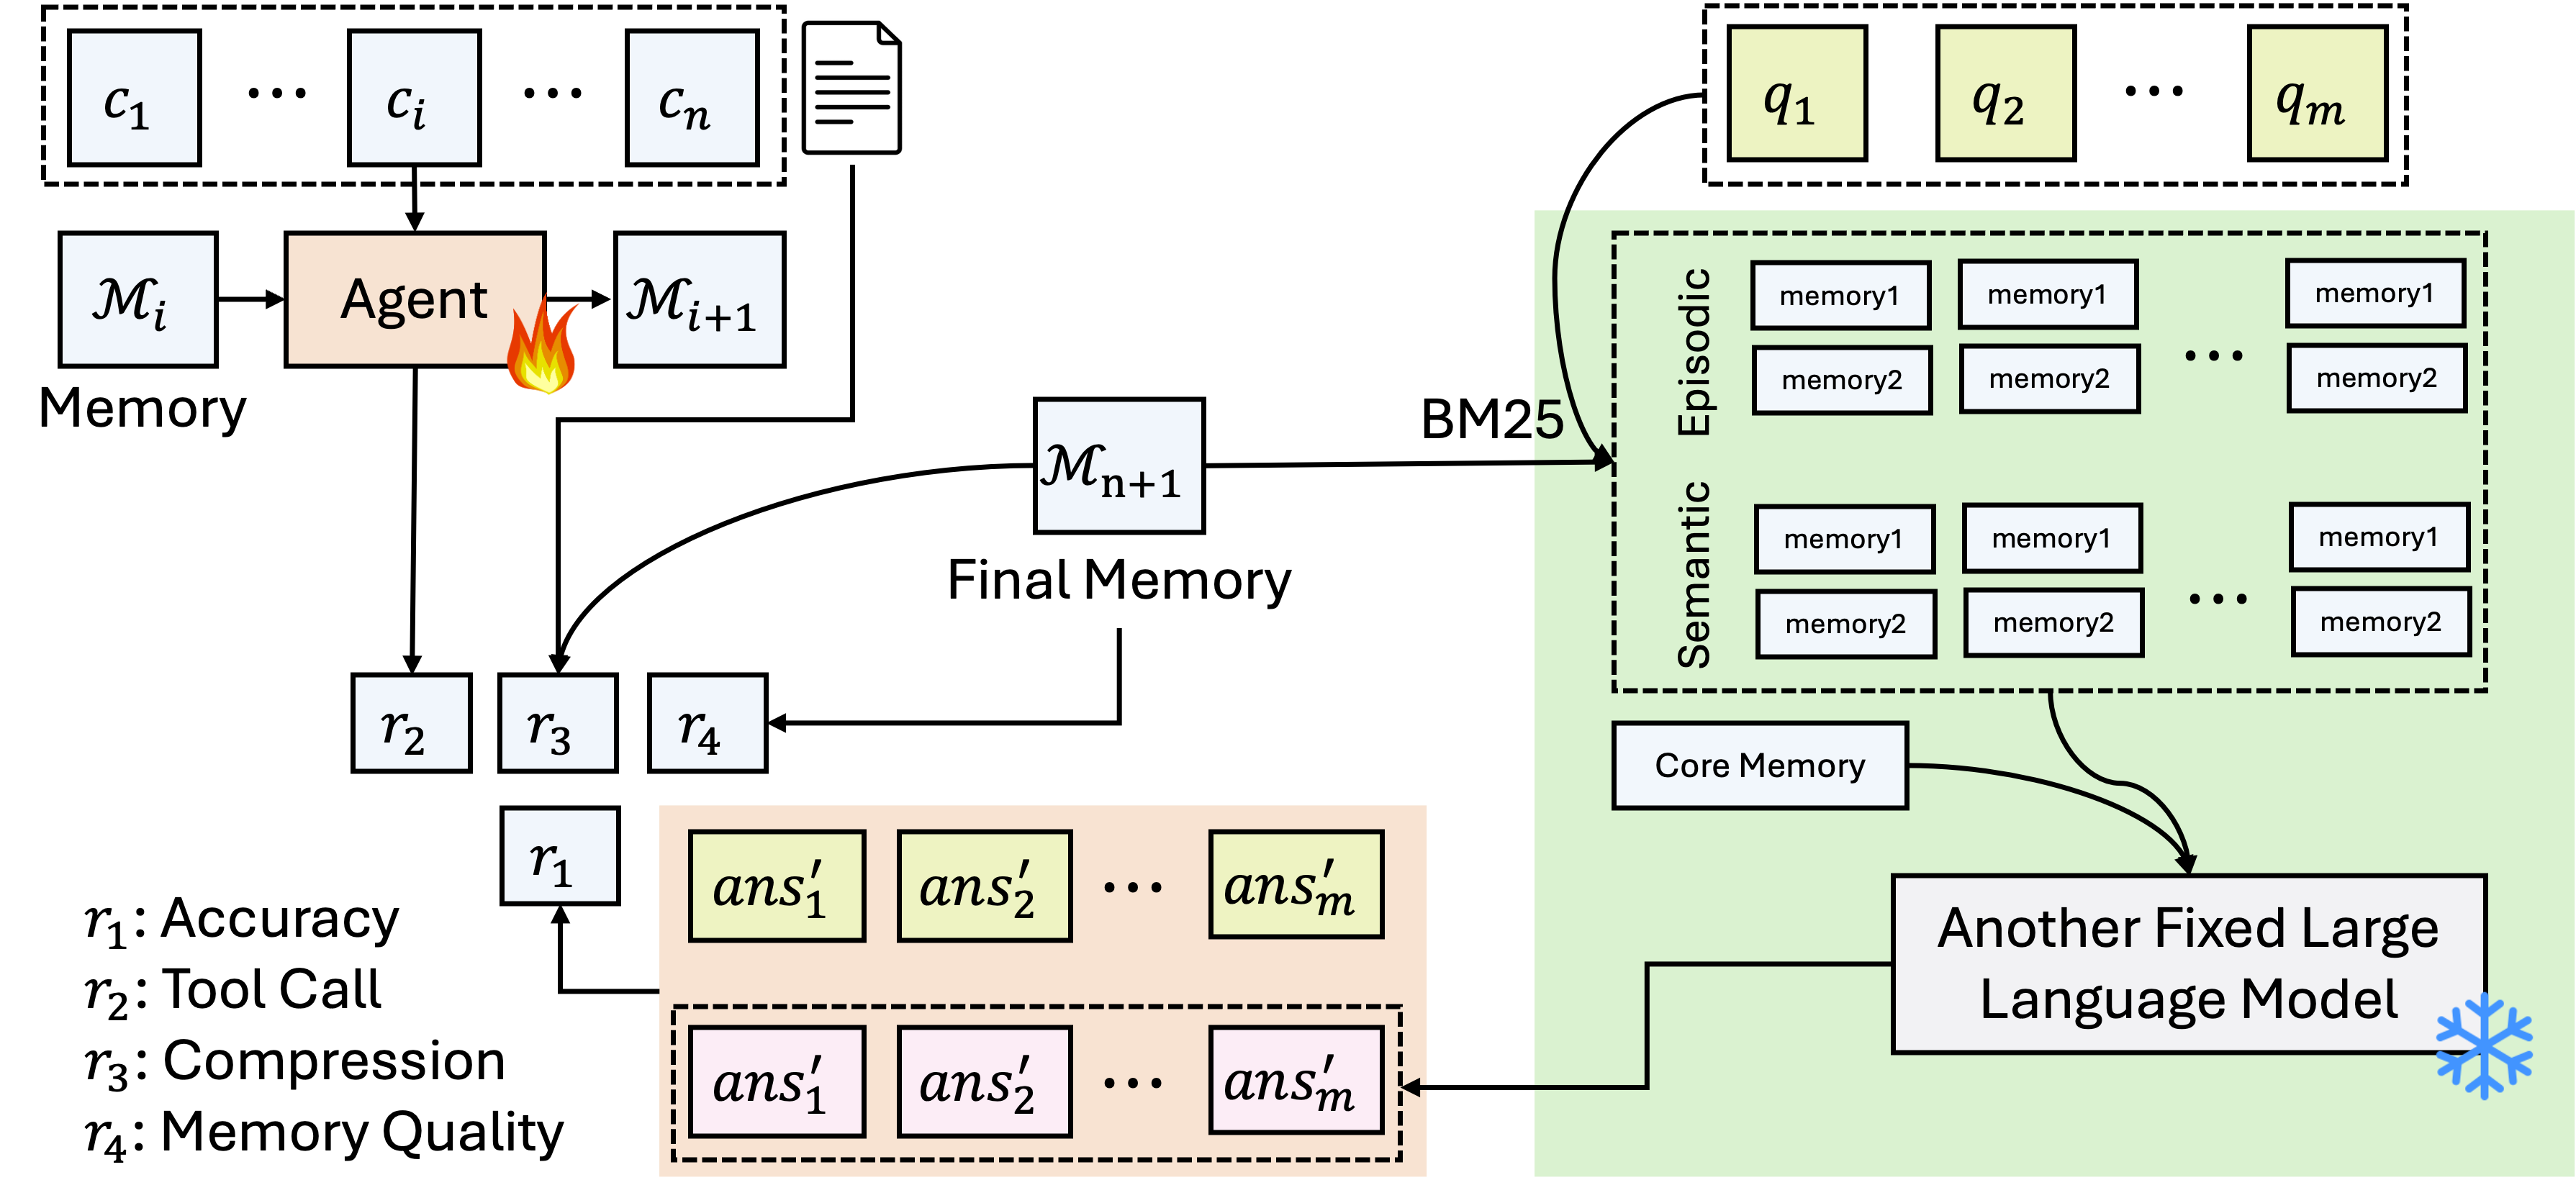
提出基于RL的记忆构建框架 Mem-α,不再依赖预设指令,而是通过**与环境交互 + 奖励反馈,**奖励信号直接来自下游任务表现
记忆架构:
- 核心记忆(Core):512 token 的摘要,始终在上下文中,只支持 update,强制保持摘要简洁。
- 语义记忆(Semantic):存储事实性知识,支持增删改。
- 情节记忆(Episodic):按时间戳存储事件,支持时序推理。
- 每个组件配备专用操作工具(insert/update/delete)
所有操作通过结构化函数调用完成:
memory_insert(memory_type='semantic', content='用户喜欢安静的环境')
RL设计:
- 状态:当前记忆状态 ℳₜ₋₁ + 当前输入块 cₜ
- 动作:在每一步 t,模型可执行多个记忆操作(如 insert/update/delete),每个操作是结构化函数调用
- 奖励:
- r₁(正确性):用 RAG 从最终记忆中回答问题,根据准确率打分。
- r₂(工具格式):检查函数调用是否符合规范(如参数类型、格式)。
- r₃(压缩率):鼓励记忆长度远小于原始输入长度(1 - lₘ/l꜀)。
- r₄(语义有效性):用 Qwen3-32B 作为“裁判”判断操作是否语义合理
- 优化算法: GRPO
DeepSeek-OCR: Contexts Optical Compression
https://github.com/deepseek-ai/DeepSeek-OCR/blob/main/DeepSeek_OCR_paper.pdf
通过Contexts Optical Compression将将文本信息“压缩”到视觉信息中。
用比原始数字文本少得多的vision tokens来表示,从而实现信息压缩率。
视觉编码器DeepEncoder
- 将以Window Attention为主的SAM模型和以Global Attention为主的CLIP串联起来
- 在两者之间加入一个2层卷积层,以实现16倍下采样
Decoder
DeepSeek-3B-MoE
数据集
- OCR 1.0数据:包含3000万页多语言文档(粗略/精细标注)和场景文字图像,用于训练基础的文字识别能力。
- OCR 2.0数据:包含图表、化学分子式、平面几何图形等复杂结构化图像的解析数据,提升模型的深度解析能力。
- 通用视觉数据:用于保留模型对自然图像的理解能力,如图像描述、目标检测等。
- 纯文本数据:用于维持和增强模型的语言能力
采用两阶段训练:
- 第一阶段:单独训练DeepEncoder,使其学会从图像中提取有效的特征。
- 第二阶段:将训练好的DeepEncoder与DeepSeek-3B-MoE解码器连接起来,进行端到端的联合训练。训练时,编码器的部分参数被冻结,以稳定训练过程。
推荐内容
Hello-Agents: 从零开始的智能体原理与实践教程
deeplearningAI: agentic-ai-course
Huggingface: The Smol Training Playbook
影音记录
精选歌单
Live演出
10.17 Valentina Lisitsa钢琴独奏|东艺
书&阅读摘录
Not Another Workflow Builder
An LLM agent runs tools in a loop to achieve a goal.
There’s two main reasons people are interested in this:
- Many companies are more resource constrained on engineering talent than others
- Non-technical users are the ones who know what agents to build / what they should do
The issue with visual workflow builders: 1.Visual workflow builders are not “low” barrier to entry. 2.Complex tasks quickly get too complicated to manage in a visual builder.
I think agents (prompt + tools) should be strictly easier to create in a no-code way than workflows.
关于 AI Infra 的一切
算法人只有两年的保质期,两年后 Ta 把自己的聪明才智发挥完了,就会陷入思维定势,反而跟不上后面的新东西了。
所以这里可以给从业者一个建议,就是不要做夹在模型和硬件中间的那个人。
这正是我认为需要被纠正的观念。前面提到过,Infra 实际上是可以对模型效果有正向影响的,而不仅仅是只能降本。
模型其实由算法、Infra 和数据这个铁三角决定。三者缺一不可,必须协同。
所以实际上比较合理的组织架构是,让 Infra 人去设计模型结构,因为 Infra 人最知道该怎么提高效率、节省成本,让数据的人去负责刷模型的点数和 benchmark 分数,因为他们最懂怎么喂模型,而算法人应该主要负责训练的范式革新。
Building in the AI Era: The HeyGen Way
We move fast AND be the absolute best… moving fast allows us to build better quality… our success metric: the average video quality any user can achieve.
Why 2 months? This aligns with model upgrade cycles… 2-month roadmap… 6-12 month strategic bets… Daily shipping
Day 1: Define hypothesis… Day 2: Build MVP… Days 3-5: Ship… Week 2: Analyze… Failure with learning = victory
Speed Is Everything… Embrace the Technology Wave… Disagree and Commit… When in doubt, ship an experiment
Growth teams are built for a different game… In the AI era, code is cheap. Impact is valuable
AI落地为什么这么难?
千万别,不要向老板卖降本的方案。 降本是个陷阱。 老板说要降本, 其实要的是利润。
AI to B 落地,往往会遇到三方博弈:老板要利润,但说不清路径。 中层要业绩,不敢碰组织。 员工要饭碗,会软抵抗。
但还有第三条路:找一个“无主之地”。不是取代现有岗位, 是做现在没人做的事,做增收,或者能帮采用部门,扩大预算或者人头的事。听起来好像跟老板原来降本的需求南辕北辙。但却是真实发生的案例。
AI落地的关键, 不是证明 AI 比人强。是让人觉得: 我用了 AI,我更强。
别动存量,找增量。
别替代人, 武装人。
对李想的第二次3小时访谈:智慧是我们和万物的关系
人类并不擅长处理特别复杂的信息——人类要做“熵减”,而不是“熵增”。人类之所以发明方法论、创造工具,本质是为了减少能量消耗——因为大脑运作需要能量。
今天的人工智能,处理通用信息表现不错,但一旦进入专业领域,往往不如人。这是因为,这些领域需要更高质量的数据和更专业的CoT
今天Chatbot,或者Reasoning,做更长链条思考和推理任务时,也能看到一系列严重的问题——几乎所有人,还是把它当成“信息工具”
还是要站在用户价值的角度,如果大家拼命使用AI,为AI投资,但我的工作时长没减少,结果也没变好,问题到底在哪? 今天通过对话(Chatbot),无论文本多么长,它都是“信息工具”,对大家是参考作用。 什么时候真正改善工作成果和减少工作时长?它必须变成“生产工具”。
另外当我Action做完以后,我还会做一个Diffusion(扩散)预测,下边会发生什么样的时长的一个场景。这个主要根据性能,会做出4到8秒Diffusion的轨迹和环境预测
五年内没有通用Agent, 但会有Agent OS
先做好公司内部的Agent,因为公司内部需要有很多Agent——客服Agent、编程Agent
搭建出一个有效的Agent OS,让每个专业的人在上面开发自己所在领域的Agent
你不可能让智能商业团队做客服Agent,应该是客服团队借助这个Agent OS,开发出自己专业的客服Agent
汽车会从智能终端变成人工智能终端。这是我们要做的。
今天,工厂也面临这样的机会。很多人想的是,造一个人形机器人进工厂替代人,但我认为有两个问题: 工厂里人的成本占比并没有大家想象的那么高,替代起来并不划算; 这些就业岗位长期来看还是必要的
只关注替代人,我认为是狭隘的。
我们没有把握住用户的需求,我们会消失; 我们没有掌握最好的产品和技术,我们会消失; 我们的组织能力方面出现了巨大的问题,我们也会消失
这些所有的讨论、争执、吵架,背后有一个更重要的一点——是能量。
当人和人之间的能量始终存在的时候,这些争执、讨论、吵架就是一个更完善的大脑。 当这些能量消失的时候,这些争执、讨论、不同想法就会变成内耗。