写在开头
本文是对于Mem0的论文解读和使用记录;
Mem0 是一款面向LLM应用的memory layer框架,同时是开源的。虽然它最早在 2024 年中旬亮相,起初的框架设计并没有太多亮眼之处,不过在最近,发布了一次比较重大的更新(基本上是重构了)采用了基于 AI-agent 的对话记忆提取、更新和查询等机制,实际体验下来,算是目前为止比较好用的了。
Paper笔记
创新点
-
Mem0架构:提出了一种可扩展的、以记忆为中心的AI代理架构,能够动态地从对话中抽取、整合和检索关键信息,实现长期、跨会话的记忆
-
Mem0g(图记忆扩展):在基础架构上进一步引入“图结构记忆”,用有向标注图(节点为实体,边为关系)来捕捉对话中复杂的实体关系和事件顺序,提升多跳推理和时序推理能力
Mem0实现
-
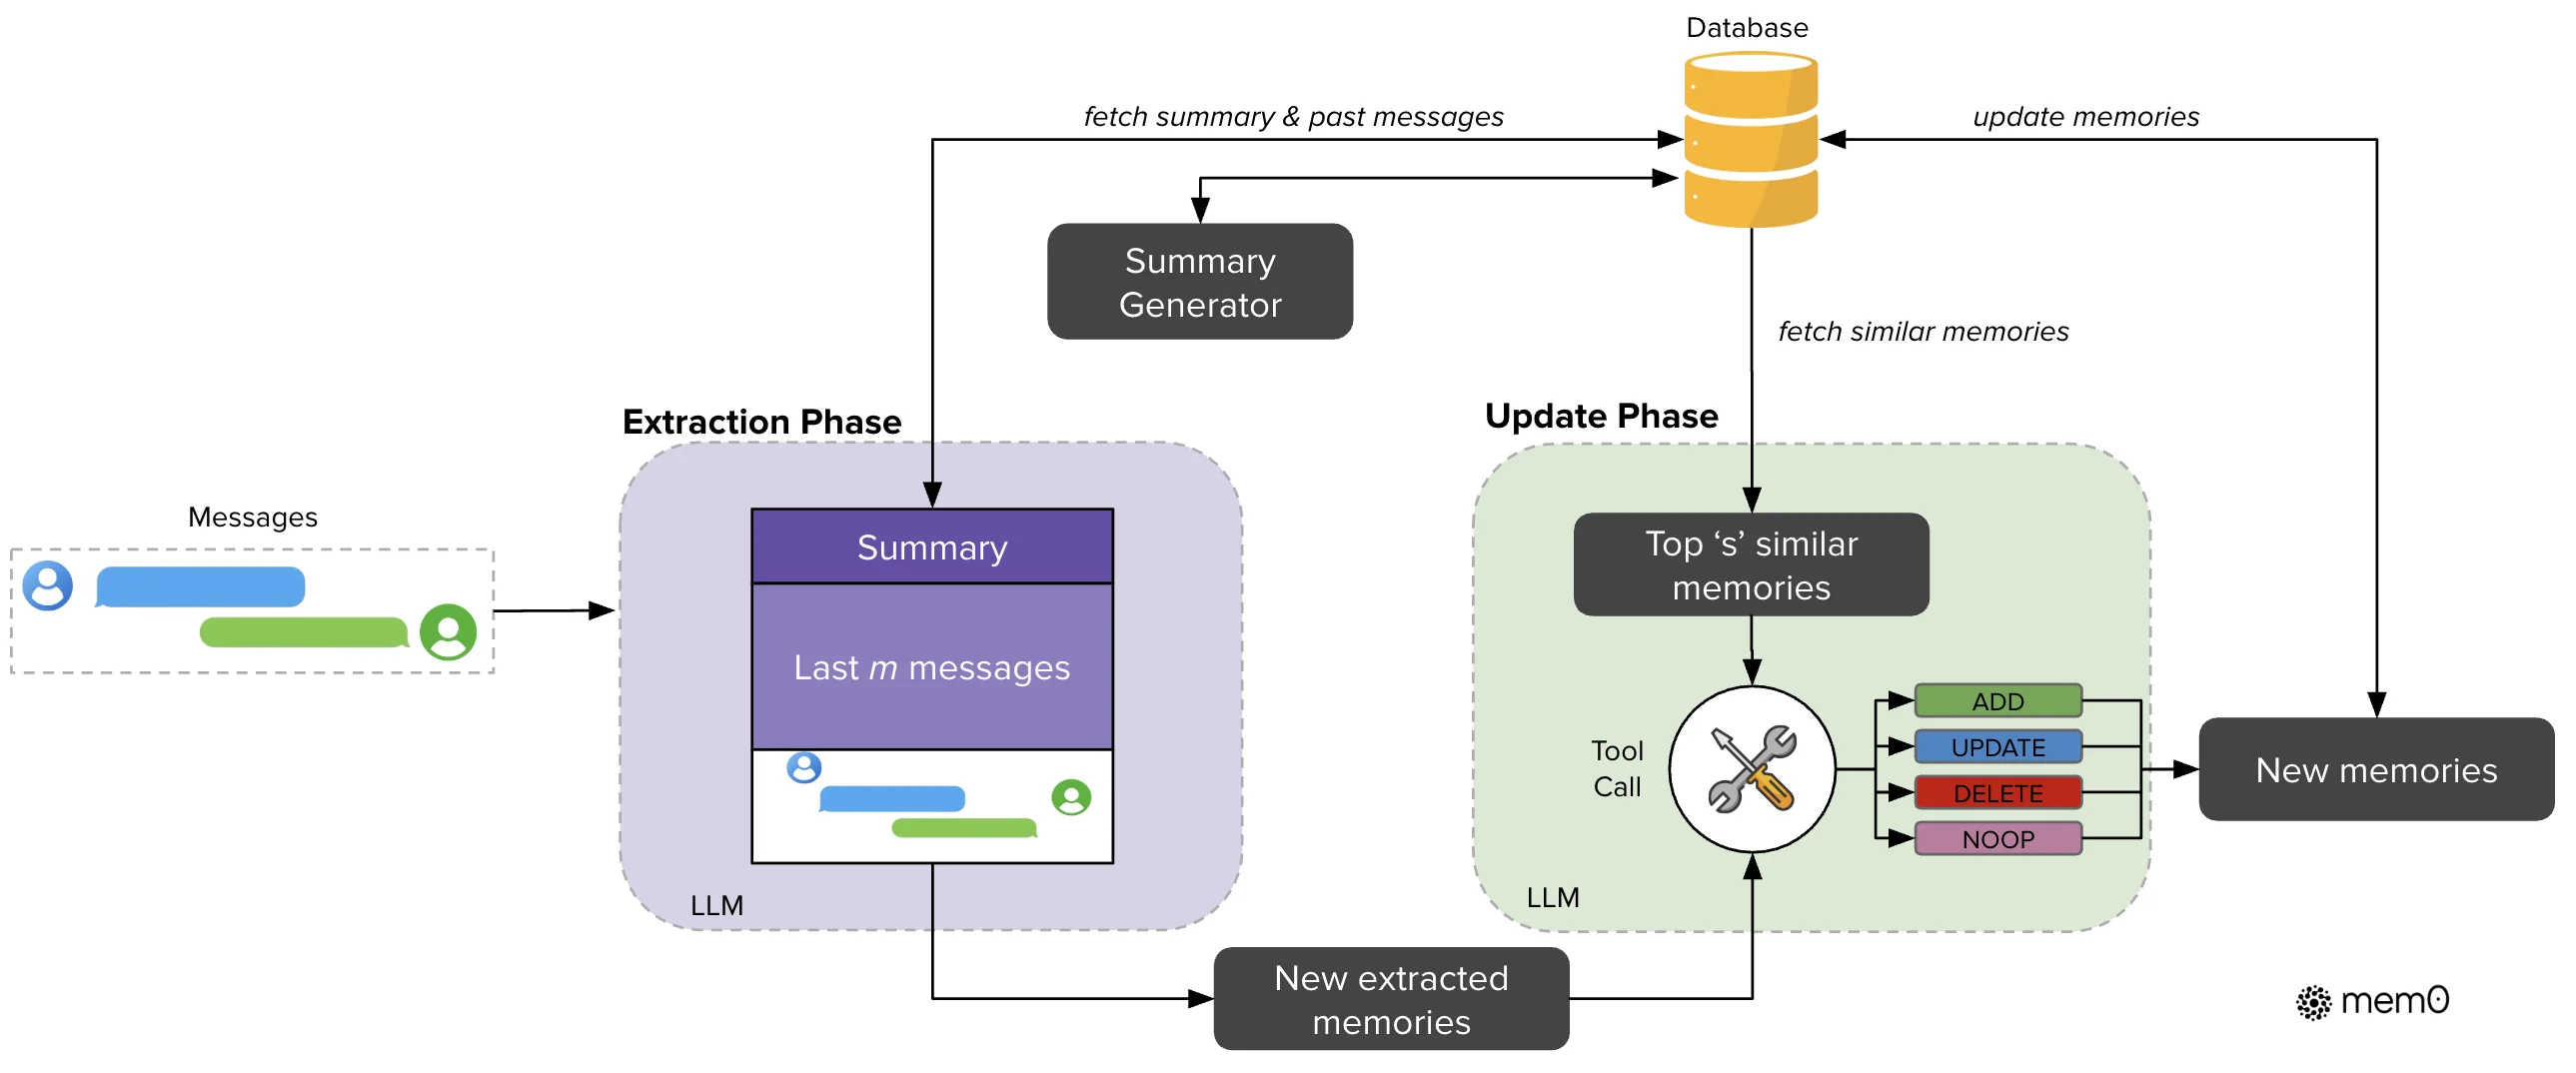
extraction phase:
-
每当有一对新的消息$(m_{t},m_{t−1})$进入系统时,系统会启动记忆抽取流程
-
系统会同时参考两类上下文信息: 全局对话摘要(S)和 最近的消息序列${m_{t−m}, …, m_{t−2}}$
-
组合成一个完整的提示(prompt)P,输入给LLM实现的抽取函数ϕ。LLM会基于这些信息,抽取出本轮对话中值得记忆的关键信息($Ω = (ω_1,…,ω_n )$),作为候选事实,准备加入知识库
-
为保障S始终是最新的,使用异步摘要生成模块,定期刷新摘要内容
-
-
update phase:
-
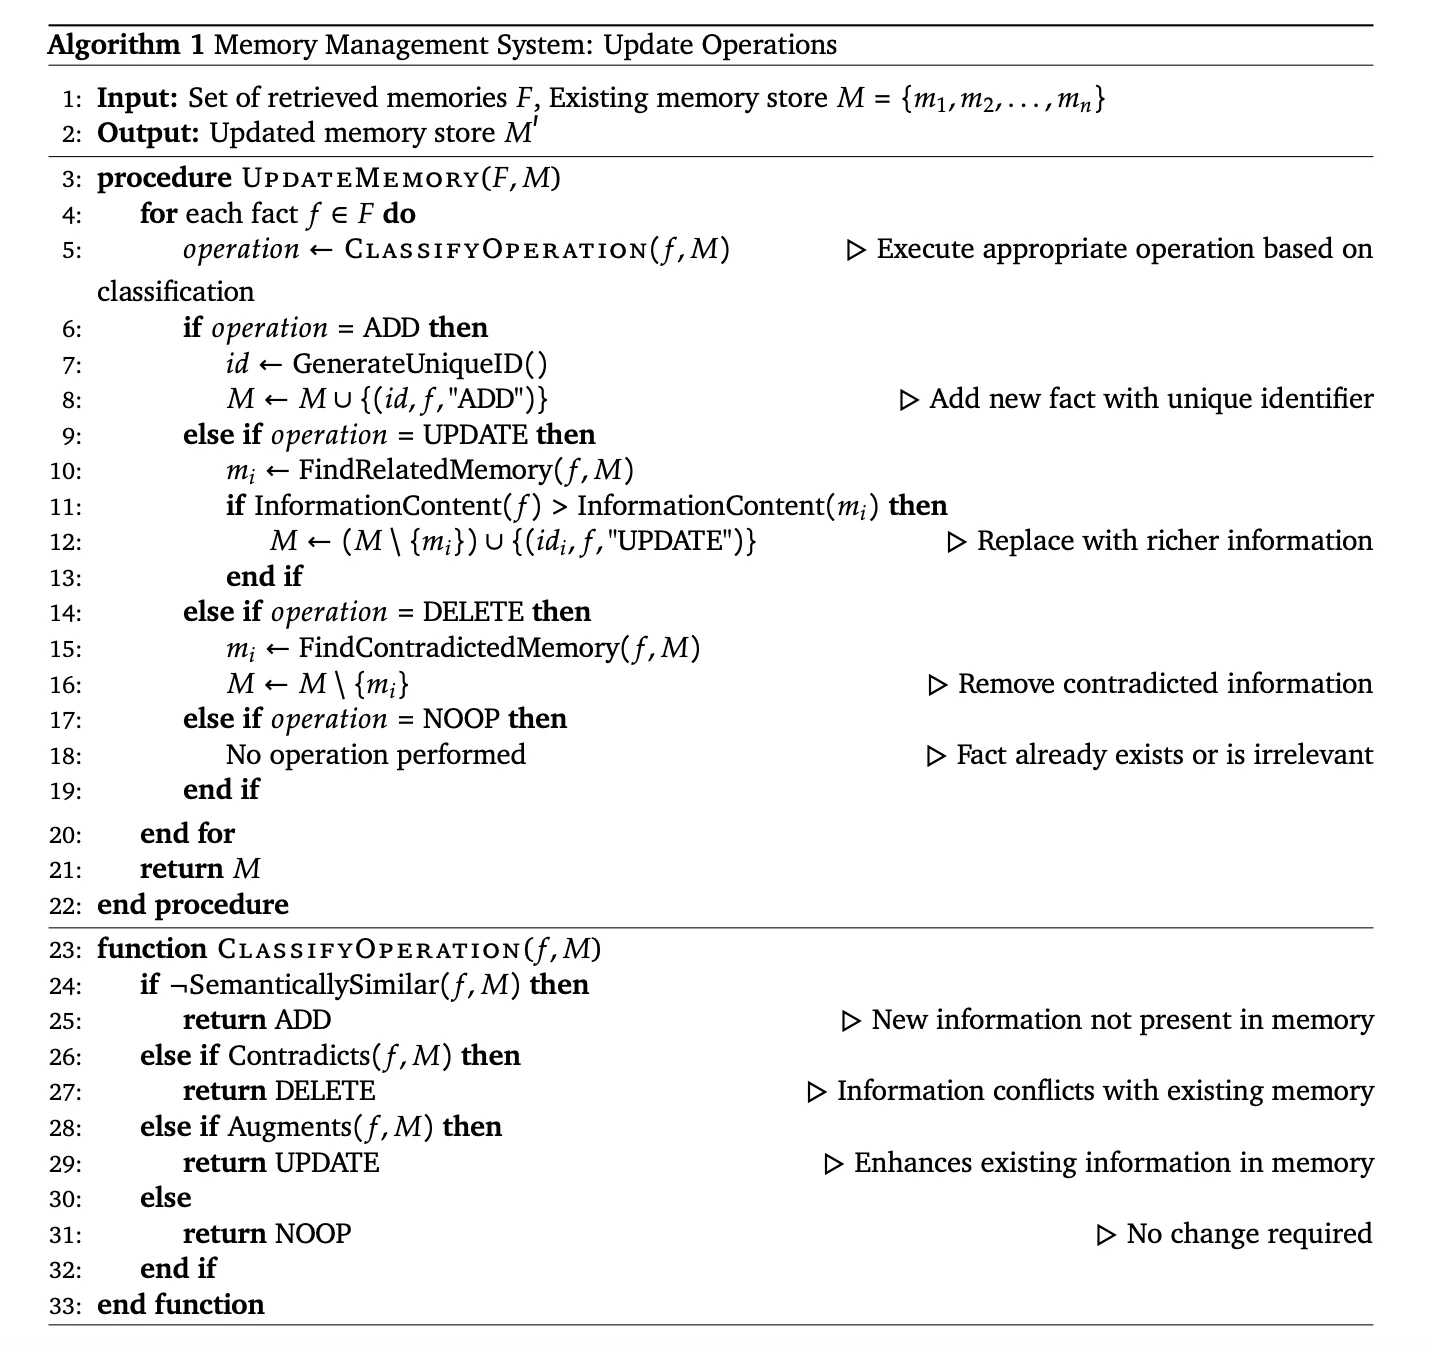
核心任务:检查这些新事实和已有记忆之间的关系和证知识库的内容既不重复,也不矛盾,始终保持一致和精简
-
对每一个新抽取的事实($ω_i$),系统会检索数据库中与之最相似的s条已有记忆(用向量嵌入做语义相似度检索), 将$ω_i$ 和相似记忆一起交给LLM,由LLM从以下4种工具选择并执行(tool-using):
-
ADD
-
UPDATE
-
DELETE
-
NOOP (什么也不做)
-
-
具体算法
Mem0g实现
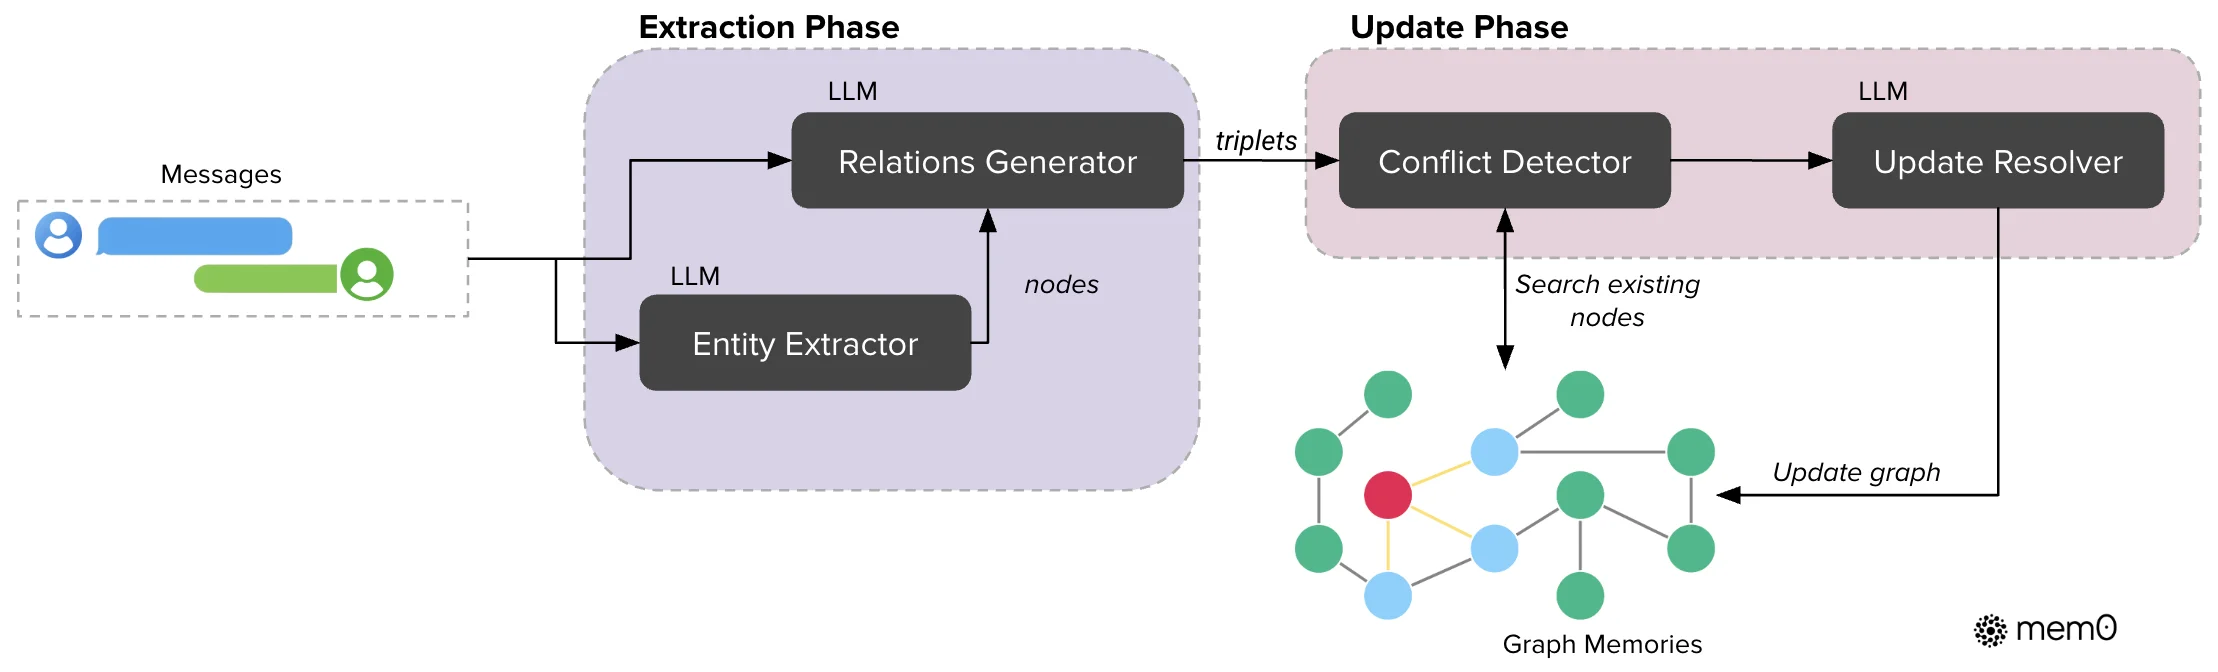
以图$G = ( V , E , L )$ 建模记忆,(实体、关系、和语义label)
每个entity(node)包含三部分信息:
-
entity type classification:用于标记这个实体属于哪一类
-
embedding vector:实体语义含义的向量表示,便于后续做语义相似度检索和推理
-
metadata: 主要包括创建时间戳(creation timestamp),用于记录这个实体被加入知识图谱的时间,有助于时序推理
relationships 用triplet的表示:
-
$v_s$:关系的起点实体(source node)
-
$r$: 关系的类型(labeled edge)
-
$v_d$: 关系的终点实体(destination node)
整个信息抽取过程分为两步,均由LLM驱动:
-
实体抽取(entity extraction)
首先,系统会用LLM分析输入文本,识别出其中所有值得被记忆的“实体”及其类型。-
这些实体可以是人、地点、物品、概念、事件、属性等。
-
判断标准包括:语义重要性、独特性、持久性(即是否值得长期记忆)。
-
-
关系抽取(relationship extraction)接着,系统会识别这些实体之间的语义关系,生成三元组,构建出结构化的知识图谱
实验
-
数据集:LOCOMO (Maharana et al., 2024),包含 10 个长对话,每个对话约 600 轮、26000 tokens,跨多次会话。每个对话后有约 200 个问题及标准答案,问题类型包括 single-hop、multi-hop、temporal、open-domain
-
baseline 选择:已有的 memory-augmented 系统(如 LoCoMo、ReadAgent、MemoryBank、MemGPT、A-Mem),RAG,Full-context,LangMem,OpenAI memory 和 Zep
-
evaluation metrics:
-
Performance Metrics:F1 Score (F1),传统的词级重叠指标;BLEU-1 (B1),单词级 BLEU 分数; LLM-as-a-Judge (J),综合评估回答的事实准确性、相关性、完整性和上下文适应性,整个数据集上独立运行 10 次,报告均值和标准差
-
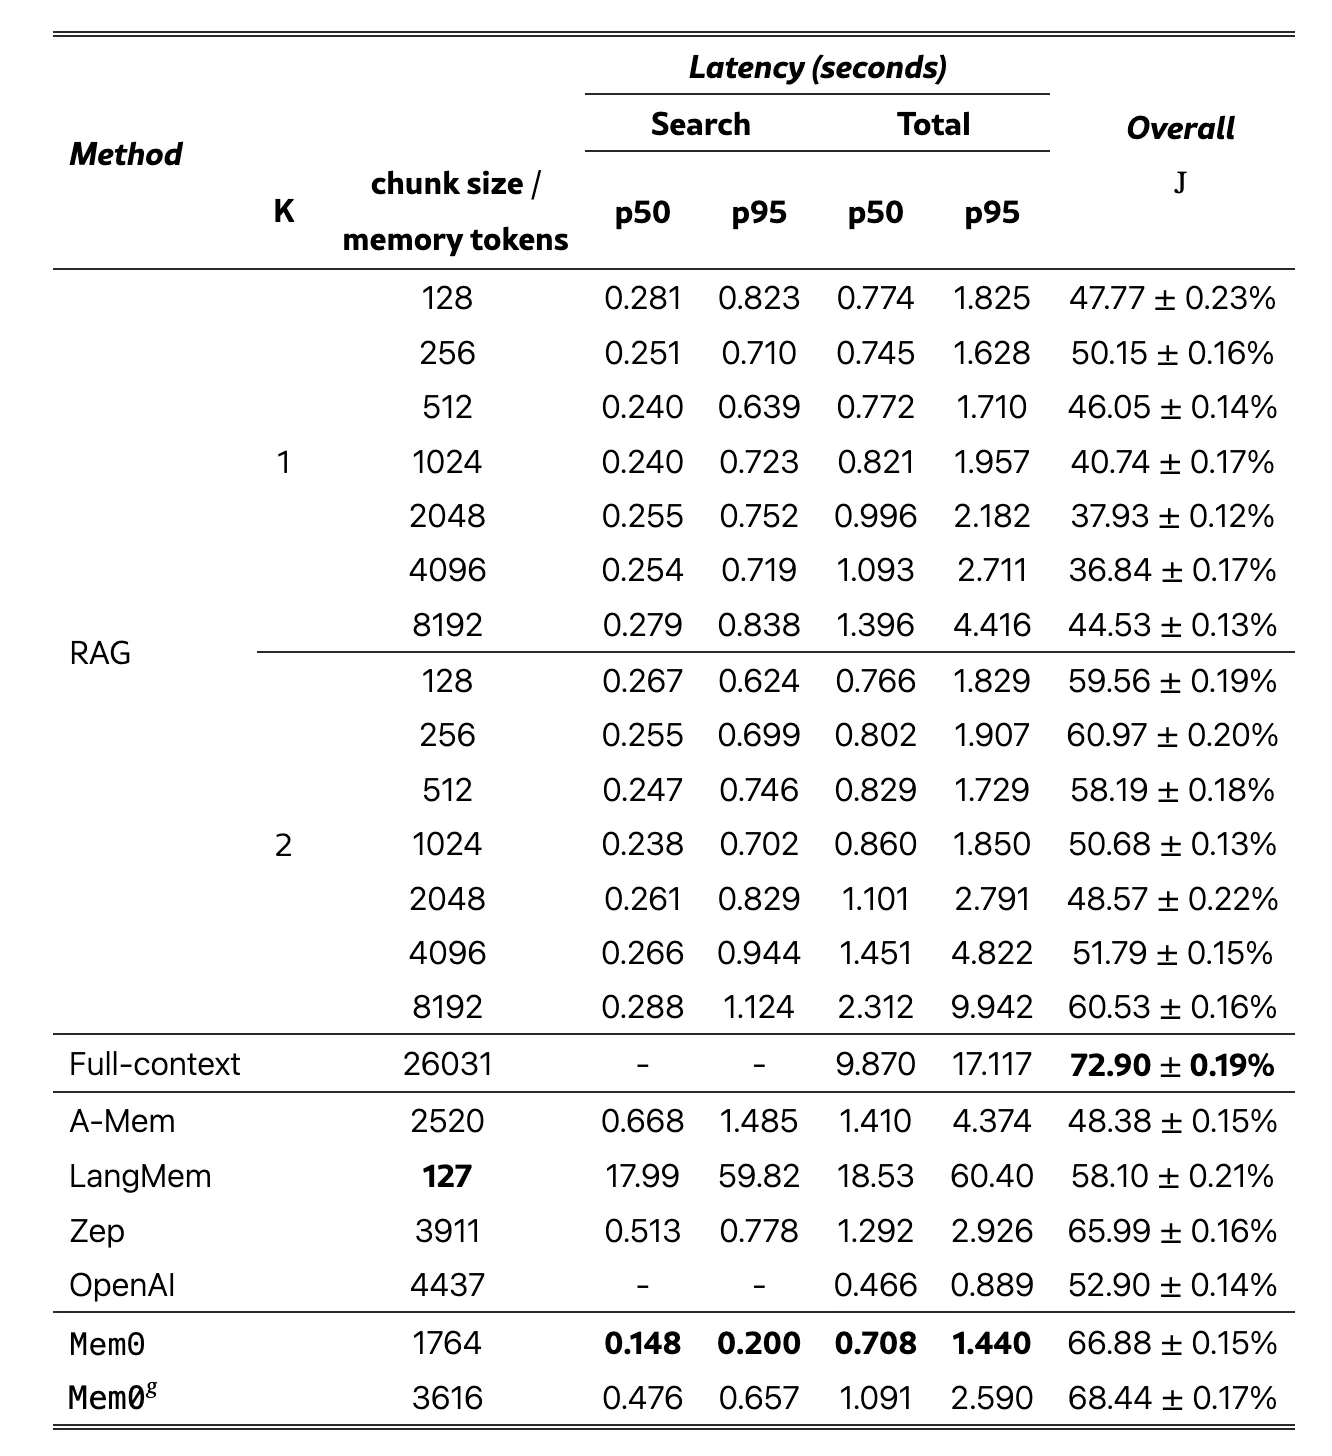
Deployment Metrics:Token Consumption(检索到的 context token 数量,反映系统的计算和成本效率);Latency,测量Search Latency和Total Latency
-
-
实验结果
-
在测试集上SOTA
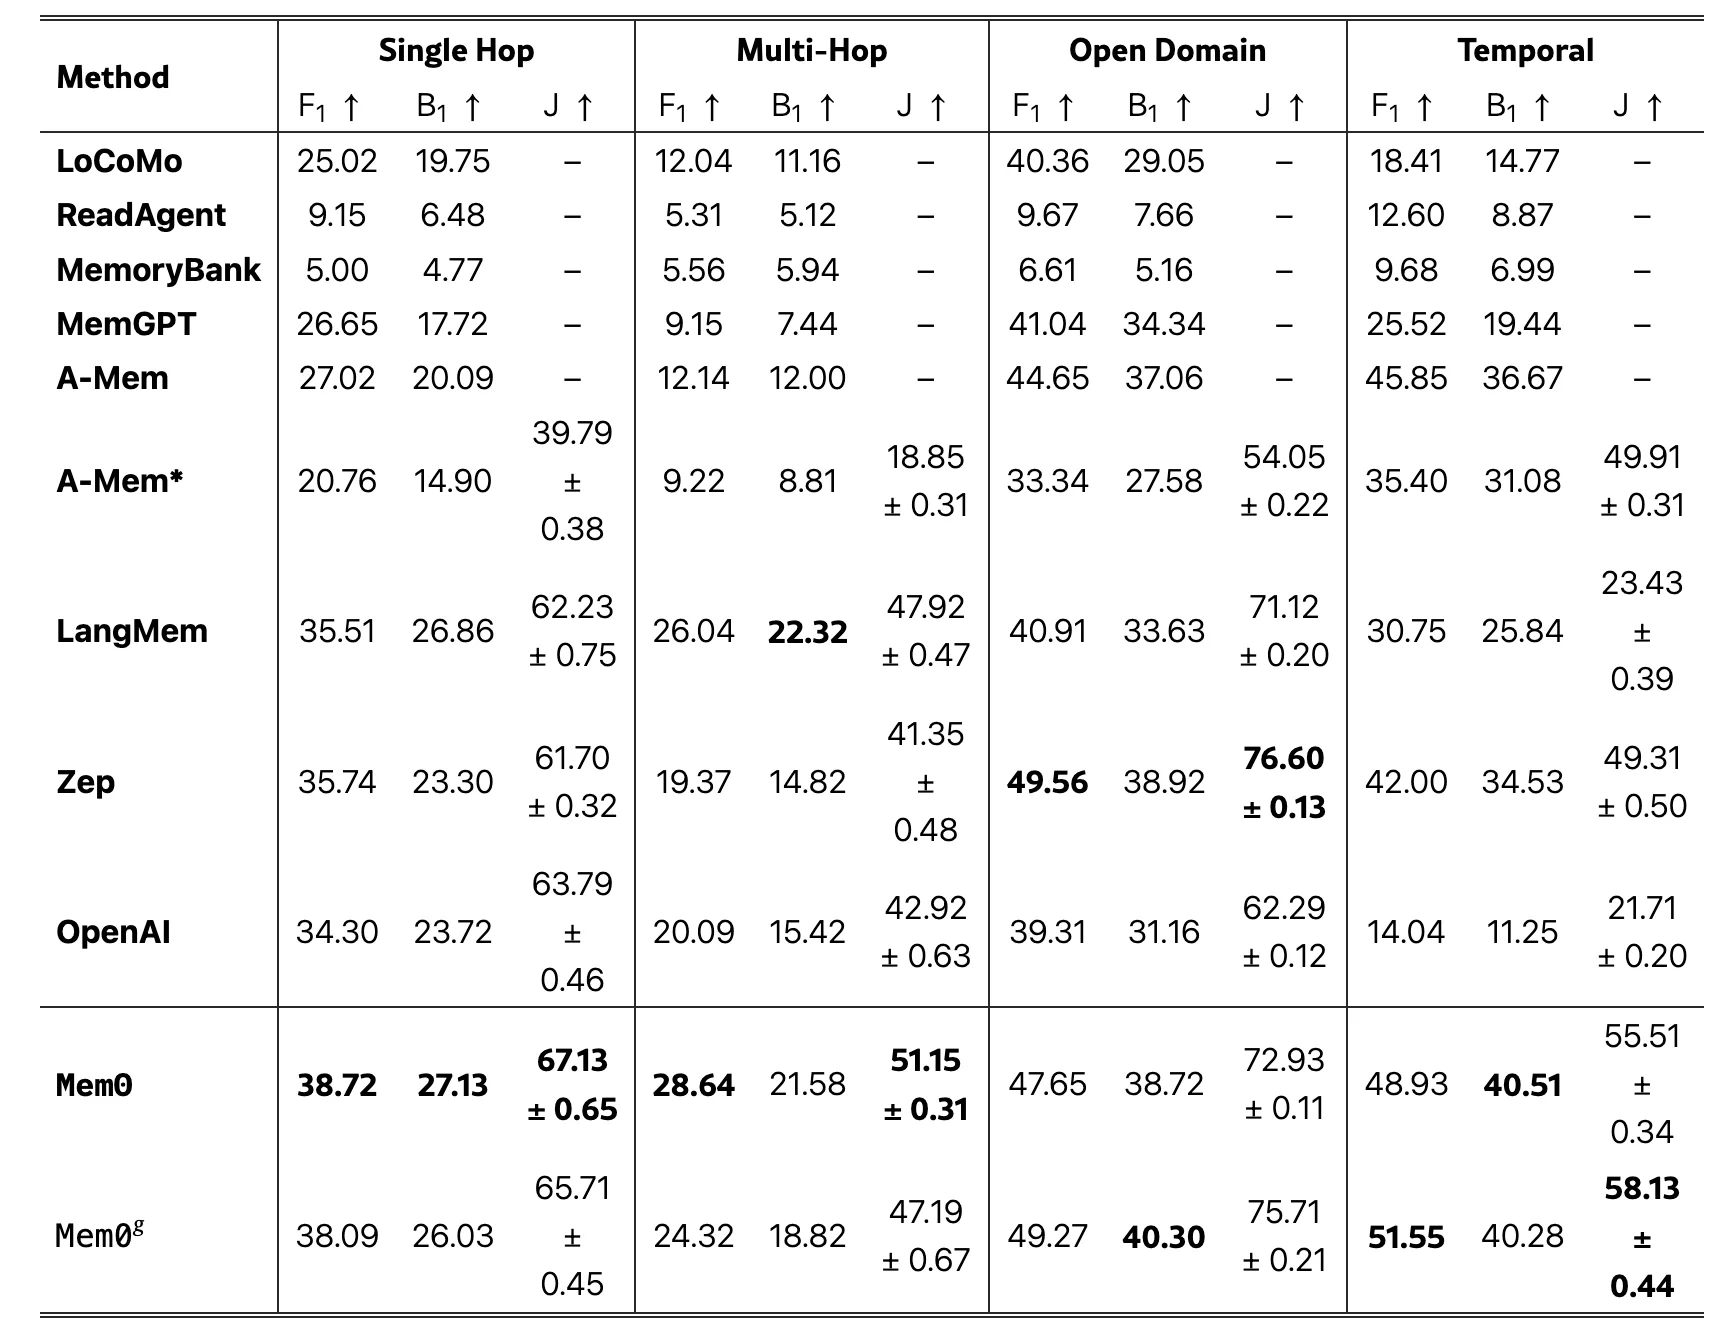
- Graph-based 方法似乎涨点不多,仅在temporal和open-domain上有明显效果
-
延迟和token消耗
-
Mem0 使用指南
依赖安装
! pip install mem0ai langchain_openai
由于需要使用到LLM 和emebdding 模型, 这里采用siliconflow的API作为演示,利用langchain作为模型提供
模型信息:
from langchain_openai import OpenAIEmbeddings,ChatOpenAI

openai_embeddings = OpenAIEmbeddings(
    model="BAAI/bge-m3",
    openai_api_base="https://api.siliconflow.cn/v1",
    openai_api_key=API_KEY,
    dimensions=1024
)
llm = ChatOpenAI(
    base_url="https://api.siliconflow.cn/v1",
    api_key=API_KEY,
    model="Qwen/Qwen3-14B"
)
使用docker方式,在本地启动向量库服务qdrant
docker pull qdrant/qdrant

docker run -p 6333:6333 -p 6334:6334 \
    -v $(pwd)/qdrant_storage:/qdrant/storage:z \
    qdrant/qdrant
修改对应的配置config信息:
config = {
   "llm": {
       "provider": "langchain",
       "config": {
           "model": llm,
       }
   },
    "embedder": {
        "provider": "langchain",
        "config": {
            "model": openai_embeddings
        }
    },
    "vector_store": {
        "provider": "qdrant",
        "config": {
            "host": "localhost",
            "port": 6333,
            "embedding_model_dims":1024
        }
    },
}
mem0使用:
from mem0 import Memory
m = Memory.from_config(config)
messages = [
    {"role": "user", "content": "I'm planning to watch a movie tonight. Any recommendations?"},
    {"role": "assistant", "content": "How about a thriller movies? They can be quite engaging."},
    {"role": "user", "content": "I’m not a big fan of thriller movies but I love sci-fi movies."},
    {"role": "assistant", "content": "Got it! I'll avoid thriller recommendations and suggest sci-fi movies in the future."}
]

# 插入:
m.add(messages, user_id="alice", metadata={"category": "movies"})

# Get all memories
all_memories = m.get_all(user_id="alice")

# Get a single memory by ID
specific_memory = m.get("MEMORY-ID")

# Search Memories
related_memories = m.search(query="What do you know about me?", user_id="alice")


# Delete a memory by id
m.delete(memory_id="MEMORY-ID")
# Delete all memories for a user
m.delete_all(user_id="alice")

m.reset() # Reset all memories
支持自定义Fact Extraction Prompt:
custom_fact_extraction_prompt = """
Please only extract entities containing customer support information, order details, and user information.
Here are some few shot examples:

Input: Hi.
Output: {{"facts" : []}}

Input: The weather is nice today.
Output: {{"facts" : []}}

Input: My order #12345 hasn't arrived yet.
Output: {{"facts" : ["Order #12345 not received"]}}

Input: I'm John Doe, and I'd like to return the shoes I bought last week.
Output: {{"facts" : ["Customer name: John Doe", "Wants to return shoes", "Purchase made last week"]}}

Input: I ordered a red shirt, size medium, but received a blue one instead.
Output: {{"facts" : ["Ordered red shirt, size medium", "Received blue shirt instead"]}}

Return the facts and customer information in a json format as shown above.
"""

config = {
  ...,
    "custom_fact_extraction_prompt": custom_fact_extraction_prompt,
}
同时也可自定义修改Update Memory Prompt,具体参考:Custom Update Memory Prompt
OpenMemory MCP
于此同时Mem0也提供了本地化的MCP-server
依照官方文档操作,能够启动3个docker-container,分别是openmemory主程序,openmemory的前端UI和向量库;
如果要自定义config,需要自行修改openmemory/api/app/mcp_server.py中的内容;
体验
和理想中记忆的设计还是有一定差距的,但至少是当下比较成型的记忆框架,同时还是开源的,那还要什么自行车呢?
鉴于其延迟性,放在online对话上多少有些影响体验,但用作offline的信息提取又有何不可呢
总体而言,agent 化的 memory 设计方向是值得肯定的
参考
Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory