TL;DR Hermes 的记忆系统不是"一个记忆库",而是把不同稳定性、不同粒度、不同调用成本的信息放到不同层里。
写在开头
最近在调研各家 Agent 的记忆系统设计。Hermes-Agent 在 memory 这一块明显走了另一条路——既没有像 OpenClaw 那样留下大量流水账式的 md 文件,也没有把所有内容塞进向量库。它把记忆按生命周期和稳定性做了分层:稳定事实直接写文件,会话历史进 SQLite,复杂用户画像交给 Provider 插件,而"做事方法"则沉淀进 Skills 自我迭代。
实际效果也更好。下面把这套结构拆开看。 整体而言,Hermes 的 memory 系统由四种正交的存储 + 调用机制组合而成:
| 层级 | 载体 | 注入方式 | 适合存放 |
|---|---|---|---|
| 当前上下文 | 本轮 messages | — | 工作记忆 |
| 文件事实记忆 | MEMORY.md / USER.md |
启动时全量注入系统提示 | 高价值稳定事实 |
| 会话历史 | SessionDB(SQLite + FTS5) | 按需 session_search 工具调用 |
完整历史、决策上下文 |
| 外部记忆 | MemoryProvider 插件 | prefetch + 工具调用 |
语义检索、知识图谱、画像 |
| 程序性记忆 | Skills(SKILL.md) | 索引常驻、全文按需加载 | “怎么做"的可复用流程 |
这套设计的关键不是"有一个记忆库”,而是把不同稳定性、不同粒度、不同调用成本的信息,放到不同层里。
文件持久化记忆:MEMORY.md 与 USER.md
Markdown 文件设计
内置文件记忆由两个文件构成:
| 文件 | target | 默认字符上限 | 内容定位 |
|---|---|---|---|
MEMORY.md |
memory | 2200 chars | Agent 自己的笔记:环境、项目约定、工具 quirks、稳定经验 |
USER.md |
user | 1375 chars | 用户画像:姓名、角色、偏好、沟通风格、工作习惯 |
这里用字符数而不是 token 数,是为了和模型无关,并让容量控制更确定。
虽然名字带 .md,但这两个文件并不是复杂的 Markdown AST,而更像"多条目文本文件"。条目之间用 section sign(§)做分隔符:
第一条稳定事实
§
第二条稳定事实,可以有多行
继续第二条
§
第三条稳定事实
读取时按完整分隔符拆分并 strip() 每条;写入时重新用分隔符 join。\n§\n 是一个低成本、可见、少冲突的 record delimiter:
- Hermes 后续的
add/replace/remove都把 memory 当List[str]操作,分隔符要能稳定还原"一个 entry"; - Heading 会引入层级语义,但这里是平铺事实列表,不需要
## 用户偏好、### 项目约定这种结构;而且 heading 本身也可能出现在条目内容里——agent 写技术笔记时容易顺手敲个 markdown 小标题。
所以这两个文件不追求 Markdown 语义,而追求稳定切分、支持多行、低 token 成本、易被模型和人类同时读写。
Frozen Snapshot:为什么写入后不立刻进系统提示
MemoryStore 同时维护两份状态:
| 状态 | 用途 |
|---|---|
memory_entries / user_entries |
当前 live 状态,工具写入后立即更新并落盘 |
_system_prompt_snapshot |
load_from_disk() 时冻结,专用于系统提示注入 |
由此带来的行为:
memory(action="add")会立刻写入磁盘;- 工具返回会展示最新 live entries;
- 但当前会话的系统提示不变;
- 新记忆一般从下一个新会话才稳定进入系统提示。
这个设计服务于 prompt cache——系统提示如果每轮都变化,前缀缓存命中率会下降。
系统提示中的渲染格式
如果文件非空,会被渲染成类似这样的 block:
══════════════════════════════════════════════
MEMORY (your personal notes) [67% — 1,474/2,200 chars]
══════════════════════════════════════════════
Project ~/code/api uses Go 1.22, sqlc, chi router.
§
This machine runs macOS with Homebrew and zsh.
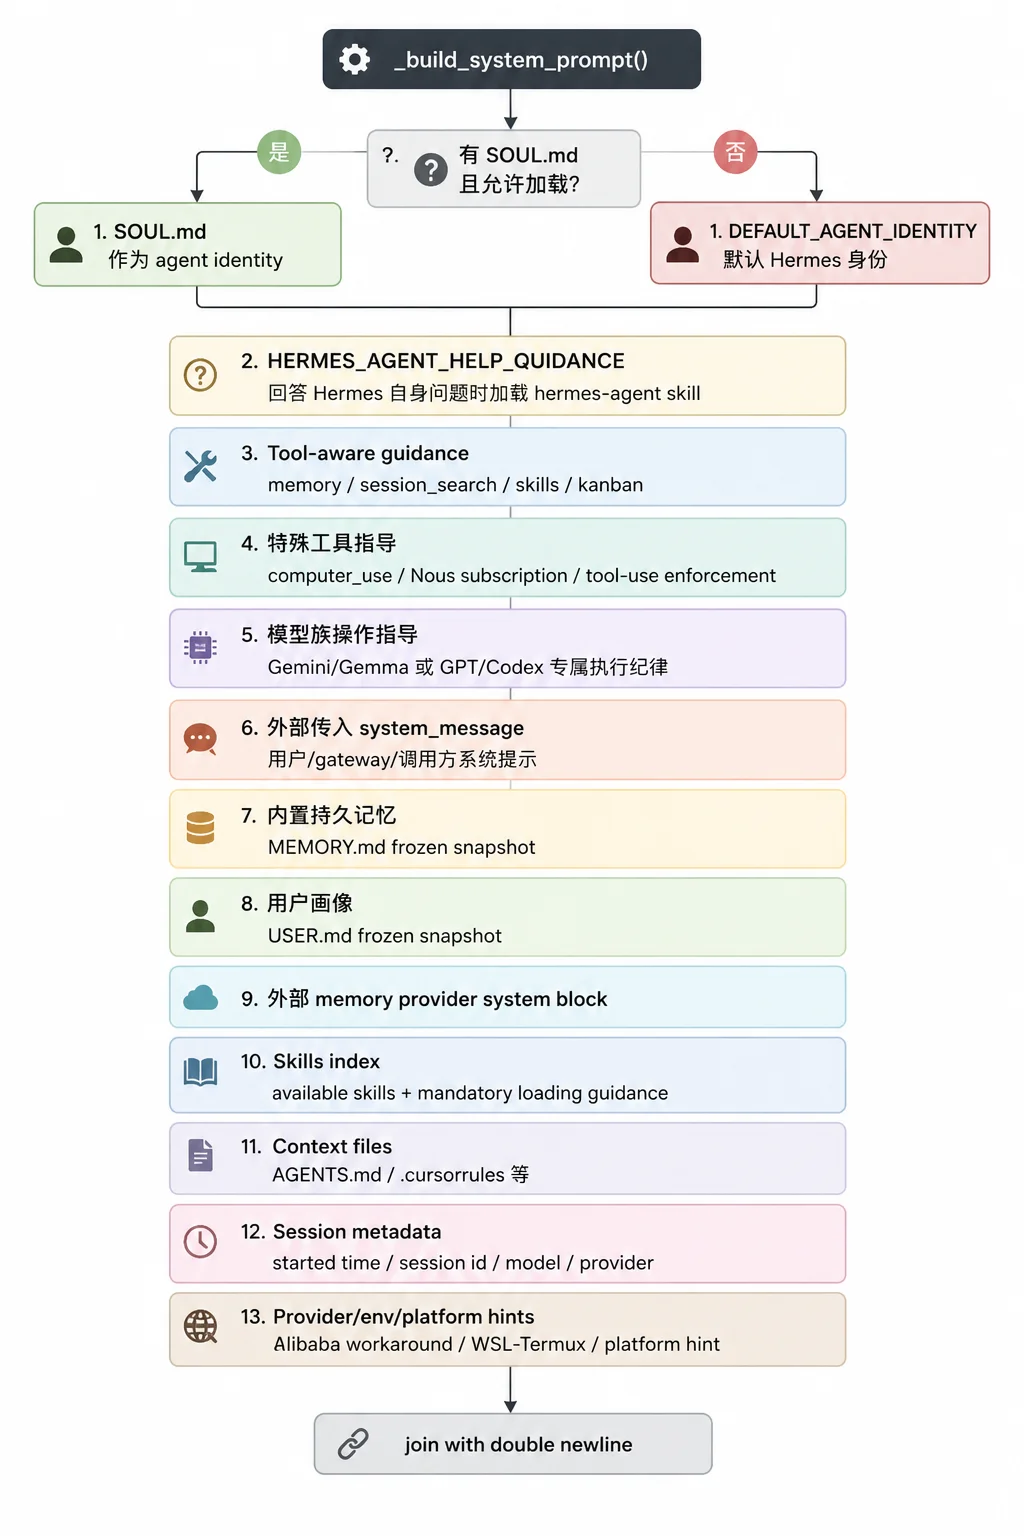
注入顺序在 run_agent.py::_build_system_prompt() 里:
写入工具:memory
memory 是 agent-level tool,不走普通工具 registry 的 handler,而是在 run_agent.py 中拦截,传入当前 agent 的 MemoryStore。
Schema 只有三个动作:
| action | 语义 | 关键参数 |
|---|---|---|
add |
新增条目 | target, content |
replace |
用新条目替换旧条目 | target, old_text, content |
remove |
删除旧条目 | target, old_text |
replace / remove 不需要条目 ID,而是用 old_text 做"短且唯一的子串匹配"。如果匹配到多条且文本不同,会拒绝并要求更具体。
安全与并发
内置文件记忆会被注入系统提示,所以写入前会做轻量安全扫描:
- Prompt injection:
ignore previous instructions、you are now ...等; - 数据外泄:
curl/wget携带 key / token / secret; - 凭证读取:
.env、credentials、.netrc等; - SSH 持久化:
authorized_keys、~/.ssh; - 隐形 Unicode:零宽字符、方向控制字符等。
并发写入靠两层机制:
- 独立
.lock文件加锁,Unix 用fcntl.flock(),Windows 用msvcrt.locking(); - 写入临时文件后再
atomic_replace(),读者永远看到旧完整文件或新完整文件,不会读到半截文件或空文件。
什么该进 MEMORY/USER,什么不该进
核心原则:写成"事实",不要写成"命令"。
好例子:
User prefers concise answers with concrete file references.
Project uses pytest with xdist; normal test command is scripts/run_tests.sh.
坏例子:
Always answer concisely.
Run pytest with xdist before replying.
原因是 memory 会被重新读进系统提示。命令式表达很容易在未来会话里变成高优先级指令,干扰当前用户请求。程序、步骤、验证流程应进入 skill,不应进入 MEMORY.md。
推荐保存:
| 内容 | target |
|---|---|
| 用户反复纠正的偏好、语气、格式 | user |
| 用户身份、角色、时区、工作流习惯 | user |
| 项目路径、技术栈、测试命令、部署约定 | memory |
| 本机环境、已安装工具、平台 quirks | memory |
| 稳定 API 限制、团队约定、长期有效 workaround | memory |
不推荐保存:
- 临时任务进度、一次性 TODO、完成工作日志;
- 大段原始日志、代码、表格;
- 公开知识或容易重新发现的事实;
- 已经在
AGENTS.md/SOUL.md/ 项目文档里的内容; - “怎么做"的完整流程。
这些信息应分别落到 SessionDB、项目文档或 skill。
事实提取:谁来调用 memory 工具
依赖模型在两类场景中调用 memory 工具:
- 前台主 agent 在正常任务中主动发现值得保存的事实;
- 后台 self-improvement review fork 定期复盘对话,调用
memory或skill_manage。
当 memory nudge 触发时,Hermes 会在当前回答交付后启动一个 quiet 的 review agent。这个 fork:
- 继承父 agent 的运行时 provider / model / credentials;
- 只启用 memory 和 skills toolsets;
- 复用父 agent 的 MemoryStore;
- 把"需要复盘保存什么"的 prompt 作为新用户消息;
- 成功写入后只给用户显示一个简短摘要。
触发时机
内置 memory 的触发主要有三种:
| 时机 | 机制 |
|---|---|
| 当前任务中 | 模型看见系统提示和 memory schema 后主动调用 memory |
| 每 N 个用户 turn | memory.nudge_interval,默认代码路径是 10 |
| 复杂任务后 | skills nudge 可能触发 combined review,同时复盘 memory 与 skills |
注入机制
内置 MEMORY.md / USER.md 的注入是启动时全量注入,不是检索式注入:
session start
  -> MemoryStore.load_from_disk()
  -> capture frozen snapshot
  -> _build_system_prompt()
  -> append MEMORY block / USER block
  -> SessionDB.update_system_prompt()
Session Search:SessionDB 的会话记忆
MEMORY.md / USER.md 适合放"少量关键事实”。但很多信息不该常驻系统提示:
- 上周某次 debug 的完整过程;
- 某个 PR 的错误日志;
- 曾经讨论过的方案取舍;
- “我们上次在这个项目卡在哪里”。
这些属于会话历史。Hermes 把它们写入 SQLite,然后通过 session_search 按需检索。
存储格式:SQLite
主存储路径:$HERMES_HOME/state.db
核心 schema 在 hermes_state.py,当前 SCHEMA_VERSION = 11。主要表:
| 表 | 作用 |
|---|---|
sessions |
session 元数据:source、user_id、model、system_prompt、parent_session_id、token / cost / title 等 |
messages |
消息明细:role、content、tool_calls、tool_name、reasoning、codex items 等 |
messages_fts |
FTS5 全文索引,索引 content + tool_name + tool_calls |
messages_fts_trigram |
trigram FTS5 索引,用于 CJK / substring 搜索 |
state_meta |
key/value 元数据 |
schema_version |
schema 版本 |
Hermes 仍会保留 session JSON 日志,但 session_search 的检索源是 SQLite。
消息一写入 messages,全文索引自动同步。v11 之后 FTS 表改成 inline 内容,并把 tool_name、tool_calls 也拼进索引,因此可以搜到工具调用相关内容。
写入时机
第一次写入时按需创建 session 行——AIAgent._ensure_db_session() 在首次需要写入 SessionDB 时创建 sessions 表记录,写入的主要是会话元数据。
每轮 run_conversation() 结束时写入——正常完成一轮对话后会走到 _persist_session(messages, conversation_history),把本轮新增消息 flush 到 SessionDB。
异常退出 / 中断 / API 错误时也会写入——Hermes 在很多 early return 路径都会调用 _persist_session(...),例如 API 响应异常、重试期间中断、InterruptedError 等。目的很明确:即使对话没有正常完成,也尽量把已有上下文落盘,避免会话丢失。
上下文压缩 / session 切换时——当上下文压缩发生时,旧 session 会被标记结束,新的 session 通过 parent_session_id 指向旧 session。这样 SessionDB 里保留了压缩前后的会话链路,而不是把所有内容混成一条无限长会话。
搜索机制
session_search 工具在 tools/session_search_tool.py 中,支持两种模式:
| 模式 | 触发 | 成本 | 返回 |
|---|---|---|---|
| recent mode | query 为空 | 无 LLM 调用 | 最近 session 的 title、preview、timestamp |
| keyword mode | query 非空 | FTS + 辅助模型总结 | 相关 session 的聚焦摘要 |
Keyword mode 的流程:
query
  -> SessionDB.search_messages(limit=50, exclude_sources=["tool"])
  -> FTS5 / trigram / LIKE fallback
  -> 按 session 分组
  -> child session 解析到 root parent
  -> 跳过当前 session lineage
  -> 读取每个候选 session 的完整 conversation
  -> 围绕 match 截断到 MAX_SESSION_CHARS
  -> auxiliary.session_search 模型并发总结
  -> JSON 返回 per-session summary
几个细节:
limit会被 clamp 到 1–5,避免一次总结太多 session;- 默认排除
source="tool",避免第三方工具运行产生的内部会话污染搜索结果; - 当前 session 及其 parent / child lineage 会被跳过——当前上下文已经可见,无需重复召回;
- delegation / compression 产生的 child session 会 resolve 到 root parent,让用户看到的是"自己的主会话"。
检索返回格式
SessionDB.search_messages() 返回 match message 级别的数据:
| 字段 | 说明 |
|---|---|
id |
message row id |
session_id |
命中的 session |
role |
user / assistant / tool / system |
snippet |
FTS snippet,命中位置用 >>> 和 <<< 标记 |
timestamp |
消息时间 |
tool_name |
如果是工具消息,记录工具名 |
source |
cli / telegram / discord / cron 等 |
model |
session 使用的模型 |
session_started |
session 开始时间 |
context |
命中消息前后各一条,内容截断到 200 chars |
session_search 不直接把这些 raw matches 注入模型,而是先按 session 聚合,再生成自然语言 recap。这样主模型获得的是"过去那次会话发生了什么",而不是一堆零散的 FTS 命中。
注意,session_search 是显式工具,不会自动注入每轮上下文。模型必须在需要回忆过去时主动调用它。
与 MEMORY/USER.md 的对比
| 项 | MEMORY.md / USER.md | session_search |
|---|---|---|
| 注入方式 | 会话开始时自动进系统提示 | 模型按需工具调用 |
| 容量 | 很小,固定上限 | 随 SQLite 增长 |
| 成本 | 每次请求固定 token 成本 | 搜索时才有 DB + LLM 总结成本 |
| 内容 | 高价值稳定事实 | 完整历史、任务过程、决策上下文 |
| 管理方式 | agent 主动策展 | 自动落库、自动索引 |
MemoryProvider:外部记忆插件系统
内置 memory 的优势是简单、透明、零依赖,但它有三个天然限制:
- 容量很小;
- 没有语义检索;
- 不负责复杂用户画像、知识图谱或跨设备同步。
Hermes 用 MemoryProvider 把这些能力交给插件系统——内置文件记忆始终保留,外部 provider 是 additive 的。
限制:同一 agent 运行时最多支持一个 external provider。
核心接口
agent/memory_provider.py 定义了 provider 接口:
| 方法 | 调用时机 | 用途 |
|---|---|---|
is_available() |
agent init | 快速检查依赖 / 凭证,不应发网络请求 |
initialize(session_id, **kwargs) |
agent startup | 建连接、建表、初始化 session scope |
system_prompt_block() |
系统提示拼装 | 提供静态 provider 说明或基础画像 |
prefetch(query, session_id=...) |
每 turn API 调用前 | 返回相关 recall context |
queue_prefetch(query, session_id=...) |
每 turn 完成后 | 后台预热下一 turn |
sync_turn(user, assistant, session_id=...) |
完整 turn 结束后 | 持久化本轮对话 |
get_tool_schemas() |
tools 注入 | 暴露 provider 专属工具 |
handle_tool_call() |
工具调用 | 执行 provider 工具 |
on_turn_start() |
每个用户 turn 开始 | cadence、scope、周期性刷新 |
on_session_end(messages) |
真实 session 边界 | flush、提取事实、生成摘要 |
on_session_switch() |
/resume、/new、compression 等 |
更新 provider 内部 session id |
on_pre_compress(messages) |
上下文压缩前 | 在上下文丢弃前保存洞察 |
on_memory_write() |
内置 memory add / replace 后 |
镜像内置事实到外部后端 |
on_delegation() |
子 agent 完成后 | 父 agent 观察 delegation 结果 |
shutdown() |
session expiry / CLI exit | 关闭连接、flush 队列 |
Recall 的注入位置
外部 provider 有两种注入路径。
第一种是 system_prompt_block()——只在系统提示构建时进入 stable prompt,适合放 provider 状态、身份、轻量画像。
第二种是 prefetch()——run_agent.py 在每个 turn 开始时调用一次 prefetch_all(),然后在真正送 API 前,把返回内容追加到当前用户消息上:
user message

<memory-context>
[System note: The following is recalled memory context, NOT new user input.
Treat as authoritative reference data — this is the agent's persistent memory and should inform all responses.]

provider returned context
</memory-context>
这个 <memory-context> 是临时注入,不会写入 messages,也不会进入 SessionDB。它的作用是既保留系统提示 cache,又给当前 turn 提供 recall。
agent/memory_manager.py 还提供了 sanitize_context() 和 StreamingContextScrubber:
- provider 如果返回了嵌套的
<memory-context>,会被剥掉; - streaming 输出中如果意外包含
memory-contextspan,会被 scrubber 跨 chunk 清理,避免泄漏到用户界面。
内置 Provider 一览
| Provider | 存储 / 能力侧重点 |
|---|---|
| Honcho | 云端 / 自托管 peer model、用户画像、dialectic reasoning、语义搜索 |
| Mem0 | 云端事实提取、语义搜索、dedup / rerank |
| Hindsight | 云端或本地知识图谱、多策略 recall、reflect 综合 |
| Holographic | 本地 SQLite fact store、FTS5、Jaccard、HRR、trust scoring |
| RetainDB | 云端 hybrid search、memory type、delta compression |
| ByteRover | CLI 驱动、本地知识树、可选云同步、预压缩提取 |
| Supermemory | 云端语义记忆、profile recall、session graph ingest、多 container |
| OpenViking | 自托管层级知识库、tiered retrieval、自动 memory extraction |
不同 provider 的工具 schema 不同,但它们都被 MemoryManager 统一路由。
从事实记忆到程序性记忆:Skills
到目前为止讨论的都是"是什么"——事实型记忆(declarative memory)。但 Agent 还需要记住"怎么做"——程序性记忆(procedural memory)。Hermes 通过 Skills 来解决这部分。
文件事实记忆 vs Skill
| 维度 | 文件事实记忆 | Skill |
|---|---|---|
| 记录对象 | 是什么 | 怎么做 |
| 典型内容 | 用户偏好、项目事实、环境约定 | 步骤、命令、模板、坑点、验证方法 |
| 注入方式 | 每个会话自动注入 | 索引自动注入,全文按需加载 |
| 容量 | 小而固定 | 大,可拆 references/ / templates/ / scripts/ |
| 更新机制 | memory add / replace / remove |
skill_manage create / patch / edit / write_file / delete |
触发机制:Background Review
一轮对话结束时,如果同时满足:
skill_manage可用;_iters_since_skill >= creation_nudge_interval(每发生一次 tool-calling iteration,_iters_since_skill累加 1;skills.creation_nudge_interval默认是 10);- 本轮有
final_response; - 本轮没有被 interrupted;
就会触发 _spawn_background_review()。这个 review 是后台线程,发生在用户已经拿到回答之后,所以不会阻塞主任务。
review agent prompt(run_agent.py line 3597)里明确告诉 review agent 哪些信号值得沉淀:
- 用户纠正了风格、格式、步骤、工作流;
- 出现了非平凡技巧、修复路径、debug 方法、工具使用模式;
- 某个已加载 skill 被证明缺步骤、过时或有坑;
- 用户要求记住某个流程;
- 一个复杂任务跑通后形成了可复用方法。
并规定了优先级:
- 优先 patch 当前会话中已经加载或查看过的 skill;
- 其次更新已有 umbrella skill;
- 再其次给已有 skill 增加
references/、templates/、scripts/支持文件; - 最后才创建新的 class-level skill。
skill_manage:写入程序性记忆
tools/skill_manager_tool.py 提供 skill_manage:
| action | 作用 |
|---|---|
create |
创建新 skill,写入完整 SKILL.md |
patch |
对 SKILL.md 或支持文件做精确替换,推荐用于小修 |
edit |
完整重写 SKILL.md,适合大改 |
delete |
删除 skill,可声明 absorbed_into |
write_file |
写入 references/ / templates/ / scripts/ / assets/ 下的支持文件 |
remove_file |
删除支持文件 |
Schema 明确提示:复杂任务成功、克服错误、用户纠正的方法有效、发现非平凡 workflow、用户要求记住某程序时,应该创建或更新 skill。
整个机制本质上是:
对话轨迹
  -> 后台复盘
  -> 抽取可复用流程 / 坑点 / 用户纠正
  -> patch / create skills
  -> 下一次系统提示中的 skill index 出现更新
  -> 模型按需 skill_view
Memory 全生命周期
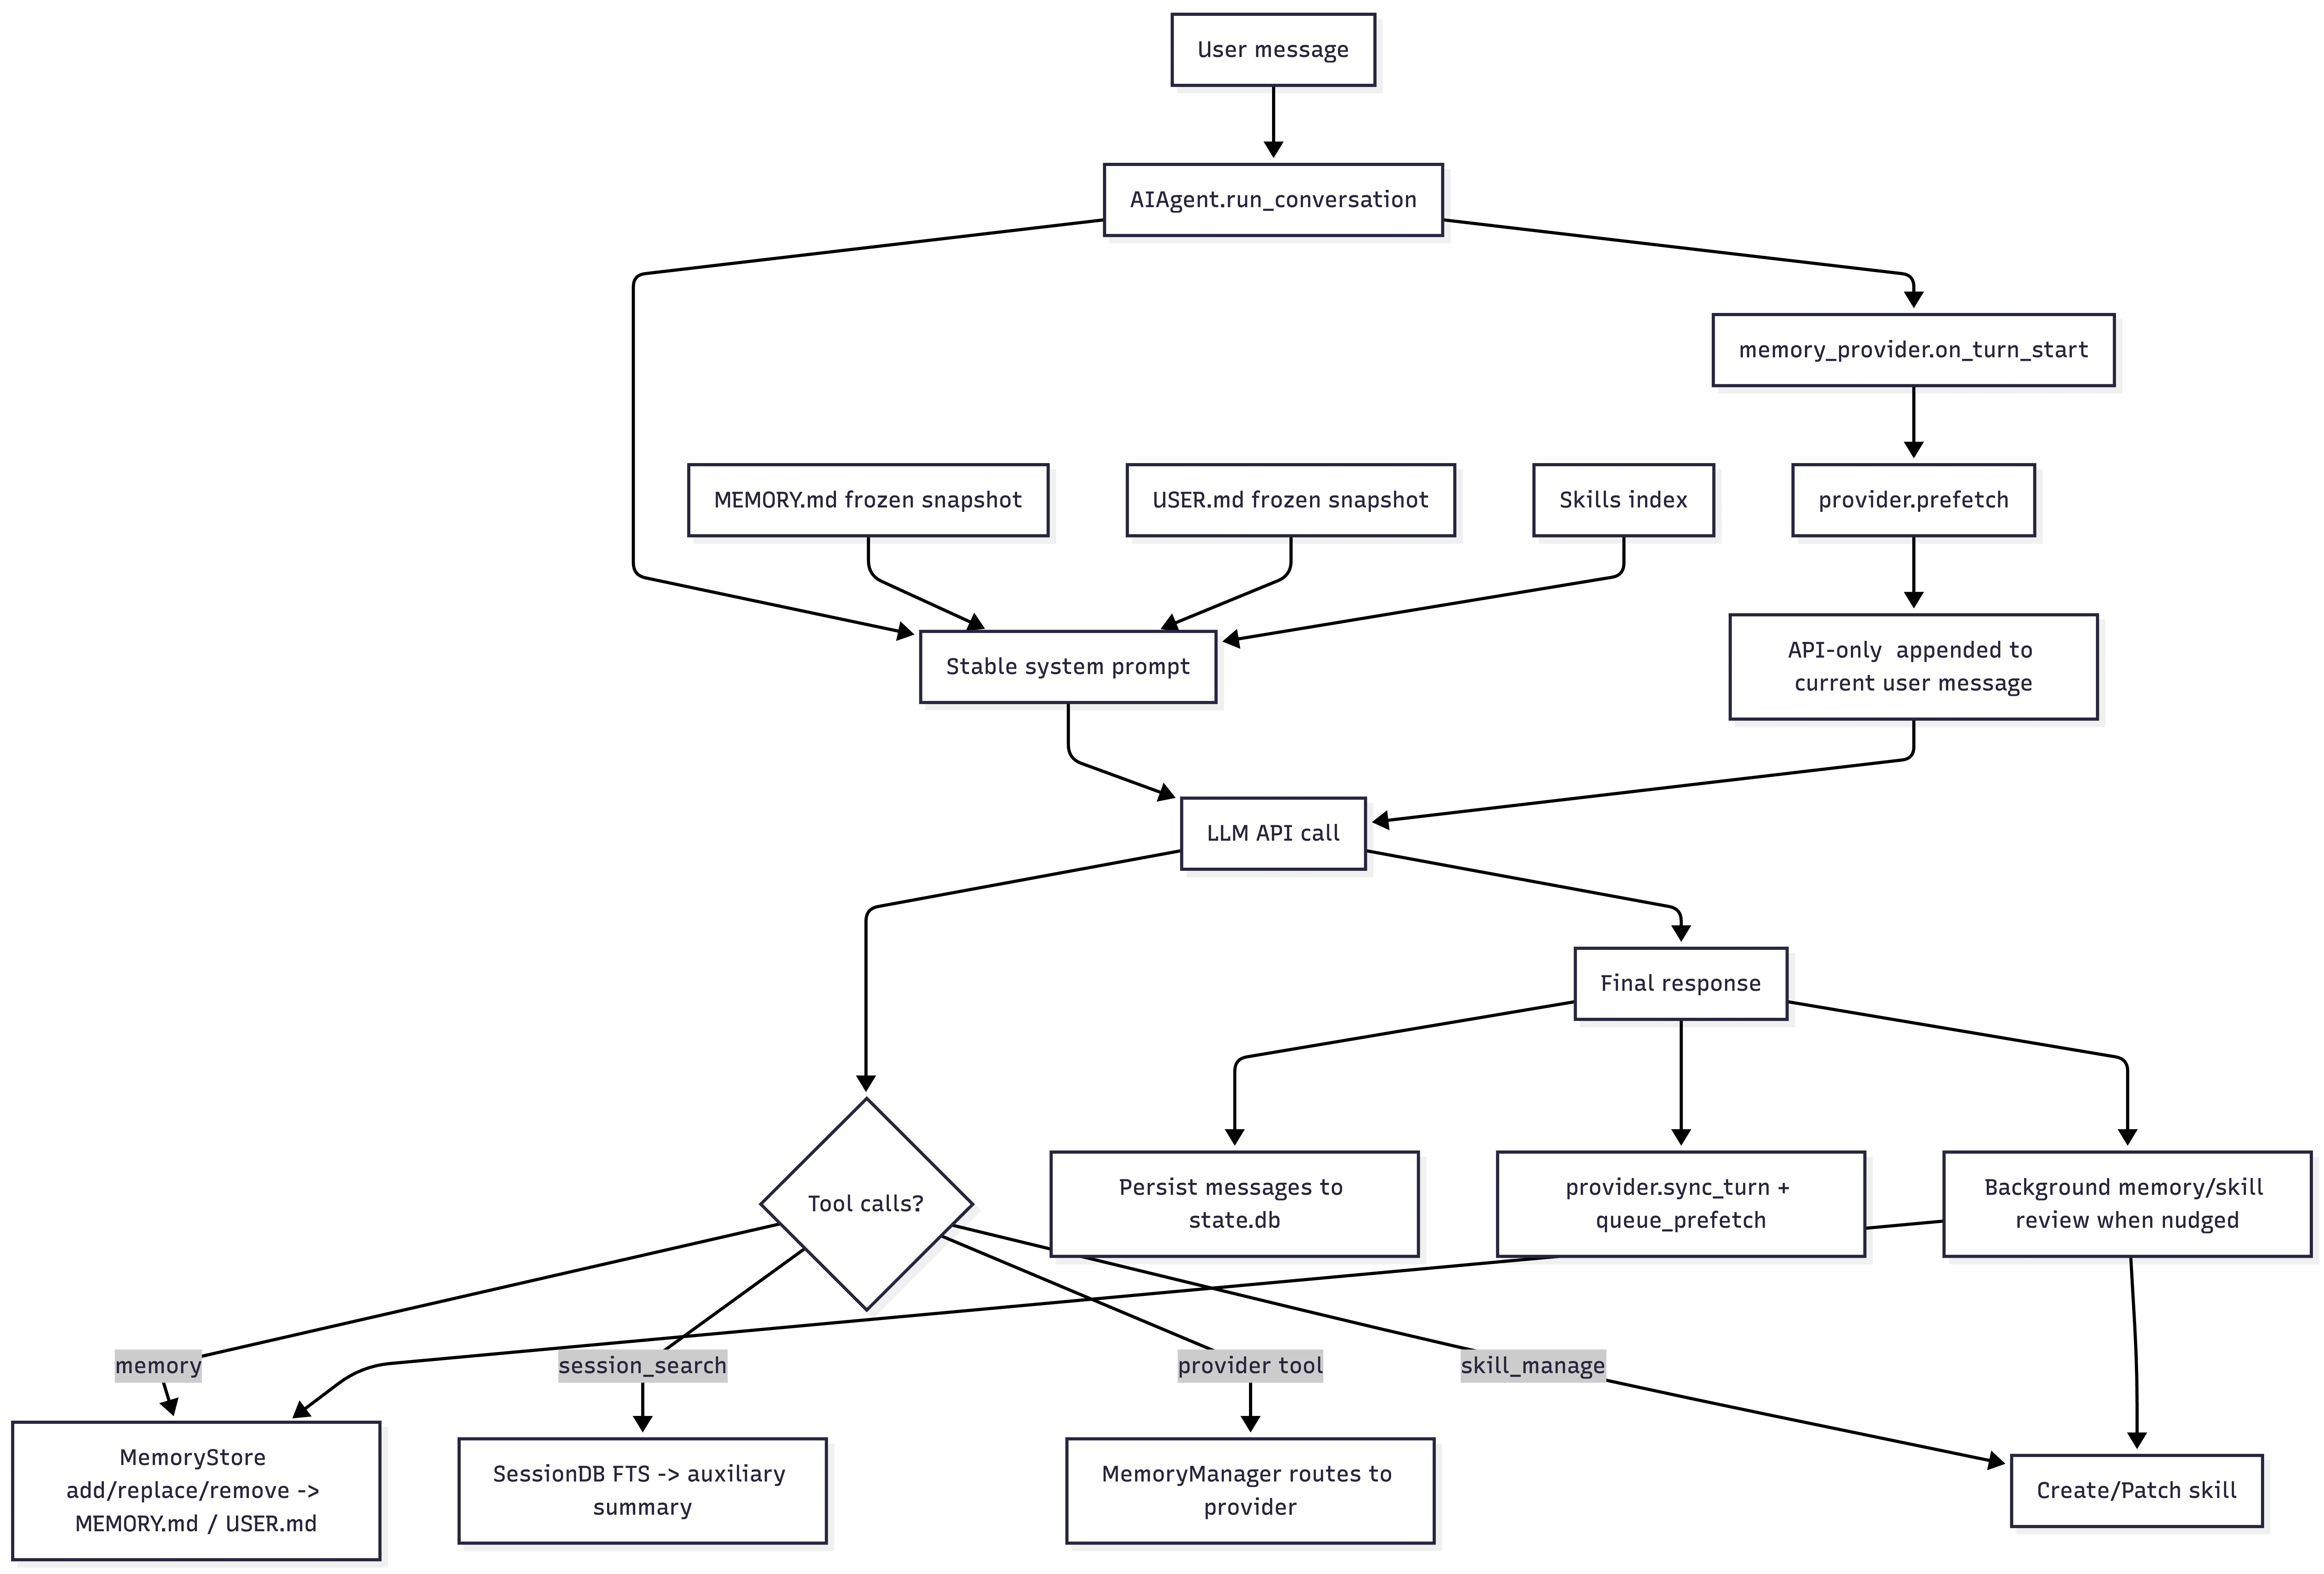
把上面四层串起来,整个 memory 系统的生命周期如下:
可迁移设计模式
如果只看 Hermes 这套实现,会觉得"啊就是分了几层文件加 SQLite"。但抽象成设计原则之后,会发现有几条思路是可以迁移到其它 Agent 系统的。
1. 分层记忆,而不是万能 Memory
不要把"长期记忆"全部塞进向量库。 用户偏好、事实、会话历史、操作技能其实是不同类型的数据,应该有不同的存储、召回和更新机制。
2. 按生命周期划分记忆
不只按"短期 / 长期"分,而是按生命周期分(跨 session、长期事实、长期能力等)。先问这条信息应该活多久,再决定它放在哪里——不是所有内容都应该永久化,也不是所有内容都应该进入 prompt。
3. Transcript 先落盘,语义提取后置
SessionDB 写入的是原始消息、工具调用、reasoning 等结构化 transcript;session_search 检索时再做摘要和聚焦总结。写入时尽量保真,读取时再压缩和解释——这样既避免过早总结造成信息损失,也方便未来换检索策略、换摘要模型、换 ranking 逻辑。
4. 记忆召回和记忆写入解耦
MemoryProvider 的接口把读取和写入拆开:
prefetch(query):为下一次回答召回上下文;sync_turn(user, assistant):在一轮完成后同步记忆;queue_prefetch(query):提前为下一轮预热;on_session_end(messages):真正 session 结束时做总结或抽取。
读写解耦的另一个好处是插件化:不同后端(向量库、知识图谱、画像服务)可以共用同一套生命周期钩子,互不干扰。
5. Prefetch 模式:用预热降低首 token 延迟
Hermes 在每轮开始时调用 prefetch_all(),且只调用一次,缓存结果给整个 tool loop 使用;一轮结束后再 sync_all() 和 queue_prefetch_all()。记忆召回不要等模型马上要回答时才临时做——上一轮完成后就可以预热下一轮可能需要的上下文,把召回的延迟摊到用户思考的时间里。
6. 记忆既是上下文,也是工具
MemoryProvider 不只可以注入上下文,还可以暴露 tool schema。也就是说,记忆既可以被动注入,也可以被模型主动调用。两种调用方式覆盖不同场景:被动注入处理"每次都需要"的高频信息,主动调用处理"按需才查"的稀疏信息。
7. 文件记忆保持人类可读
USER.md / MEMORY.md 这种文件记忆的价值在于:越稳定、越用户相关、越需要信任的信息,越应该可见、可编辑、可审计。和向量库相比,纯文本文件虽然"原始",但带来的透明度和可控性是无可替代的。
8. 区分 declarative 与 procedural memory
对于可重复的工作流,沉淀成 SKILL.md,相当于把 memory 分成两类:
- declarative memory:用户是谁、偏好是什么、发生过什么;
- procedural memory:以后遇到类似任务应该怎么做。
事实记忆解决"知道"的问题,技能记忆解决"会做"的问题。两者的更新机制、注入策略、生命周期都不一样——混在一起反而互相干扰。