引言
首先,从最简单的RAG(Retrieval-Augmented Generation)谈起。
RAG结合了信息检索与生成模型,先通过用户的原始问题query 在知识库中检索与相关的文档,再利用生成模型(如ChatGPT)生成回答。最简单的RAG版本通常被称为Naive-RAG,虽然Naive-RAG能够处理一些简单的问题,但在真实场景下,用户提出的问题往往更加复杂多样,远远超出系统最初设计的预期范围。
在用户与RAG系统交互时,往往会遇到以下几种常见问题:
-
表达模糊不清:用户在描述问题时,往往难以精准表达自己的需求。他们可能仅使用几个词组或片段,导致系统难以理解用户的真实意图。
-
依赖上下文:用户的问题经常依赖之前的对话或背景信息,而系统只接收到当前的孤立问题,缺少关键的上下文支持,无法给出准确的答案。
-
复杂多层次问题:某些问题本身复杂,包含多个子问题或需要推理、逻辑分析。Naive-RAG依赖简单的关键词匹配或语义匹配,无法很好地处理这类复杂的需求。
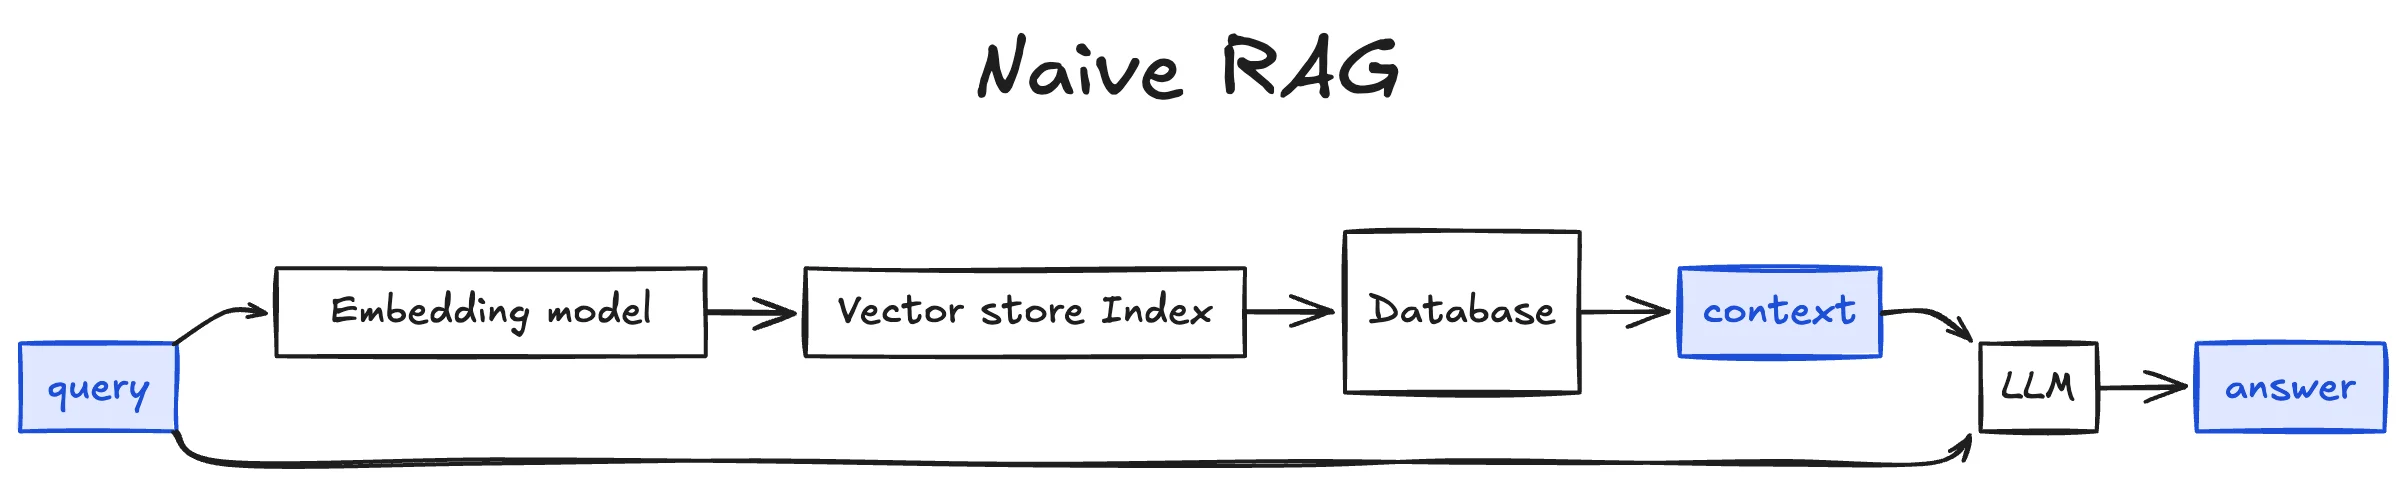
面对这些挑战,Naive-RAG的局限性变得明显:仅仅依靠用户的原始query无法应对多样化的提问场景。那么,如何提升RAG系统的检索能力,增强对复杂问题的处理呢?这时就需要引入Query-Enhancement技术。
Query-Enhancement,顾名思义,是对用户的原始query进行增强处理。它的核心思想是:不要直接使用用户的原始query进行相关文档的检索,而是通过某种技术手段对query进行改写、扩展或优化,从而生成一个更适合检索的query。这种技术在不同场景下有不同的命名,如query rewrite或query reformulation,但核心目标都是一致的——根据用户的初始输入,生成一个更符合检索需求、更能提升查询准确性的新query。
通过Query-Enhancement,可以解决许多Naive-RAG无法处理的问题。例如,针对模糊或简短的提问,增强后的query可以通过添加上下文或关键词来丰富信息内容;对于复杂的多层次问题,增强后的query可以拆解为多个子问题,逐步进行检索与推理。
本文将深入探讨不同的Query-Enhancement技术方案,并分析这些技术如何根据原始query生成更高效的查询,帮助RAG系统在复杂场景下提供更精确的答案。
Query Rewrite
Because the original query can not be always optimal to retrieve for the LLM, especially in the real world… we first prompt an LLM to rewrite the queries, then conduct retrieval-augmented reading.
Query Rewrite的目的是将用户模糊、不明确或不完整的查询转换为更适合检索的形式,以提升检索效率和准确性。
仅使用原始query的缺点:
-
查询常常模糊、不具体或不完整,导致难以找到有效的检索结果。
-
缺乏明确术语,无法有效从大型数据集中提取相关信息。
-
对话上下文中的查询含义因对话历史而异,同样的表达在不同的上下文中可能有不同的意图。
输入文本与真正需要检索的知识之间不可避免地存在差距。这种差距限制了检索性能,增加了对检索能力增强和提示工程的依赖。
为了解决这些问题,检索器之前增加了一步对输入进行改写的过程,填补给定输入与检索需求之间的差距。这一步利用了LLM本身的能力对原始查询进行有针对性的改写。
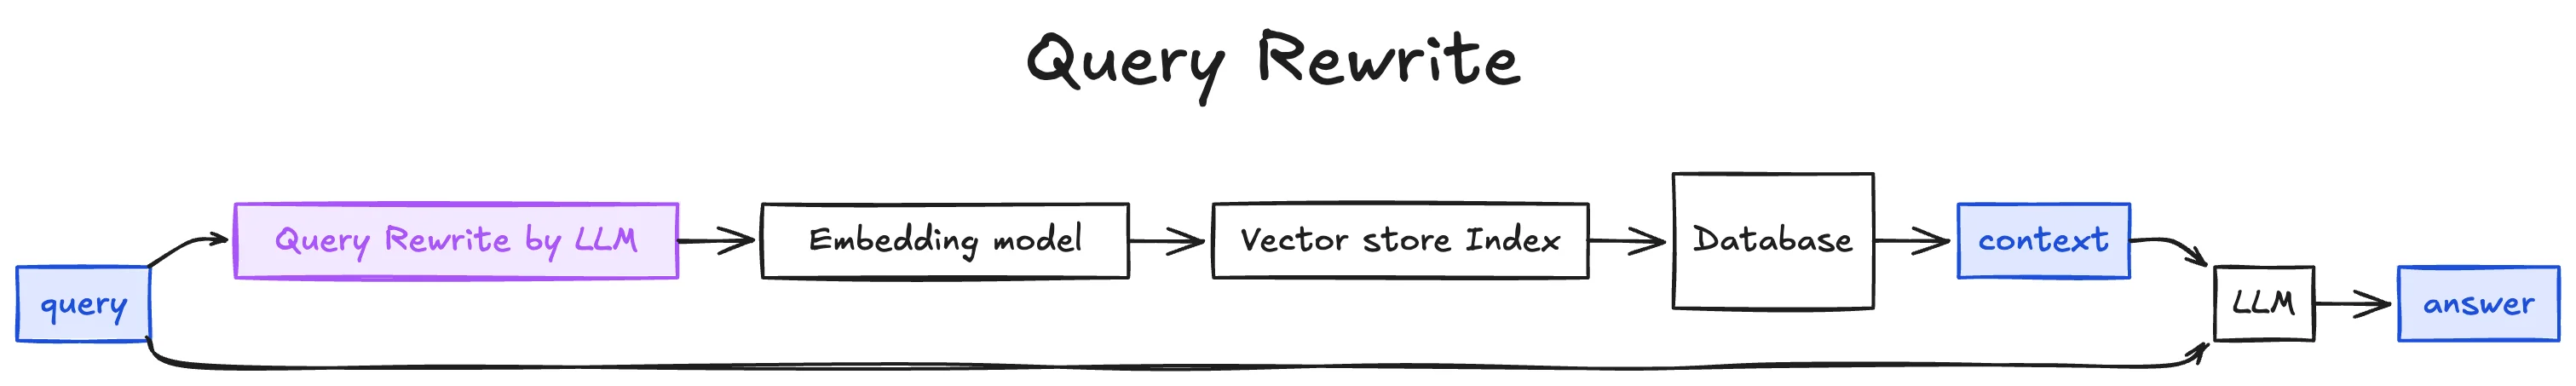
比如,来自RAG_Techniques 的这段prompt:
query_rewrite_template = """You are an AI assistant tasked with reformulating user queries to improve retrieval in a RAG system.
        Given the original query, rewrite it to be more specific, detailed, and likely to retrieve relevant information.

        Original query: {original_query}

        Rewritten query:"""
使LLM可以更加系统地将用户的原始查询改写为更符合检索需求的形式。
此外, 改写过程可以同时考虑用户的初始输入和对话历史,从而生成经过优化的查询。这种上下文感知的查询改写确保了搜索过程与用户的真实意图保持一致。例如,用户在对话过程中间询问“昨天的会议怎么样?”这样的查询本身是不足以进行有效检索的,因为它缺乏具体的上下文信息。为了使其更加有效,LLM可以将其改写为更详细的版本,例如:“9月14日预算会议的主要决策是什么?”。
此时只需要在prompt中加入原始查询和一段上下文对话内容即可。
当然,在使用query-rewrite方法时,可能会出现问题,尤其是当用户询问的是特定垂直领域的问题,而LLM对该领域缺乏理解,容易将问题改写成无关的内容。例如,用户提问“最近DR的表现怎么样?有些数据吗?”,这里的“DR”指“数据恢复”(Data Recovery),用户关注的是该领域的数据。然而,LLM将其误解为“Diabetes Research”(糖尿病研究),改写成“最近糖尿病的表现怎么样?有最新的统计数据吗?”,从而偏离了用户的需求,生成了与领域无关的回答。这种误解可能导致答非所问,影响用户体验。
此外, 使用LLM进行query-rewrite还将面临着更大的延迟和成本。
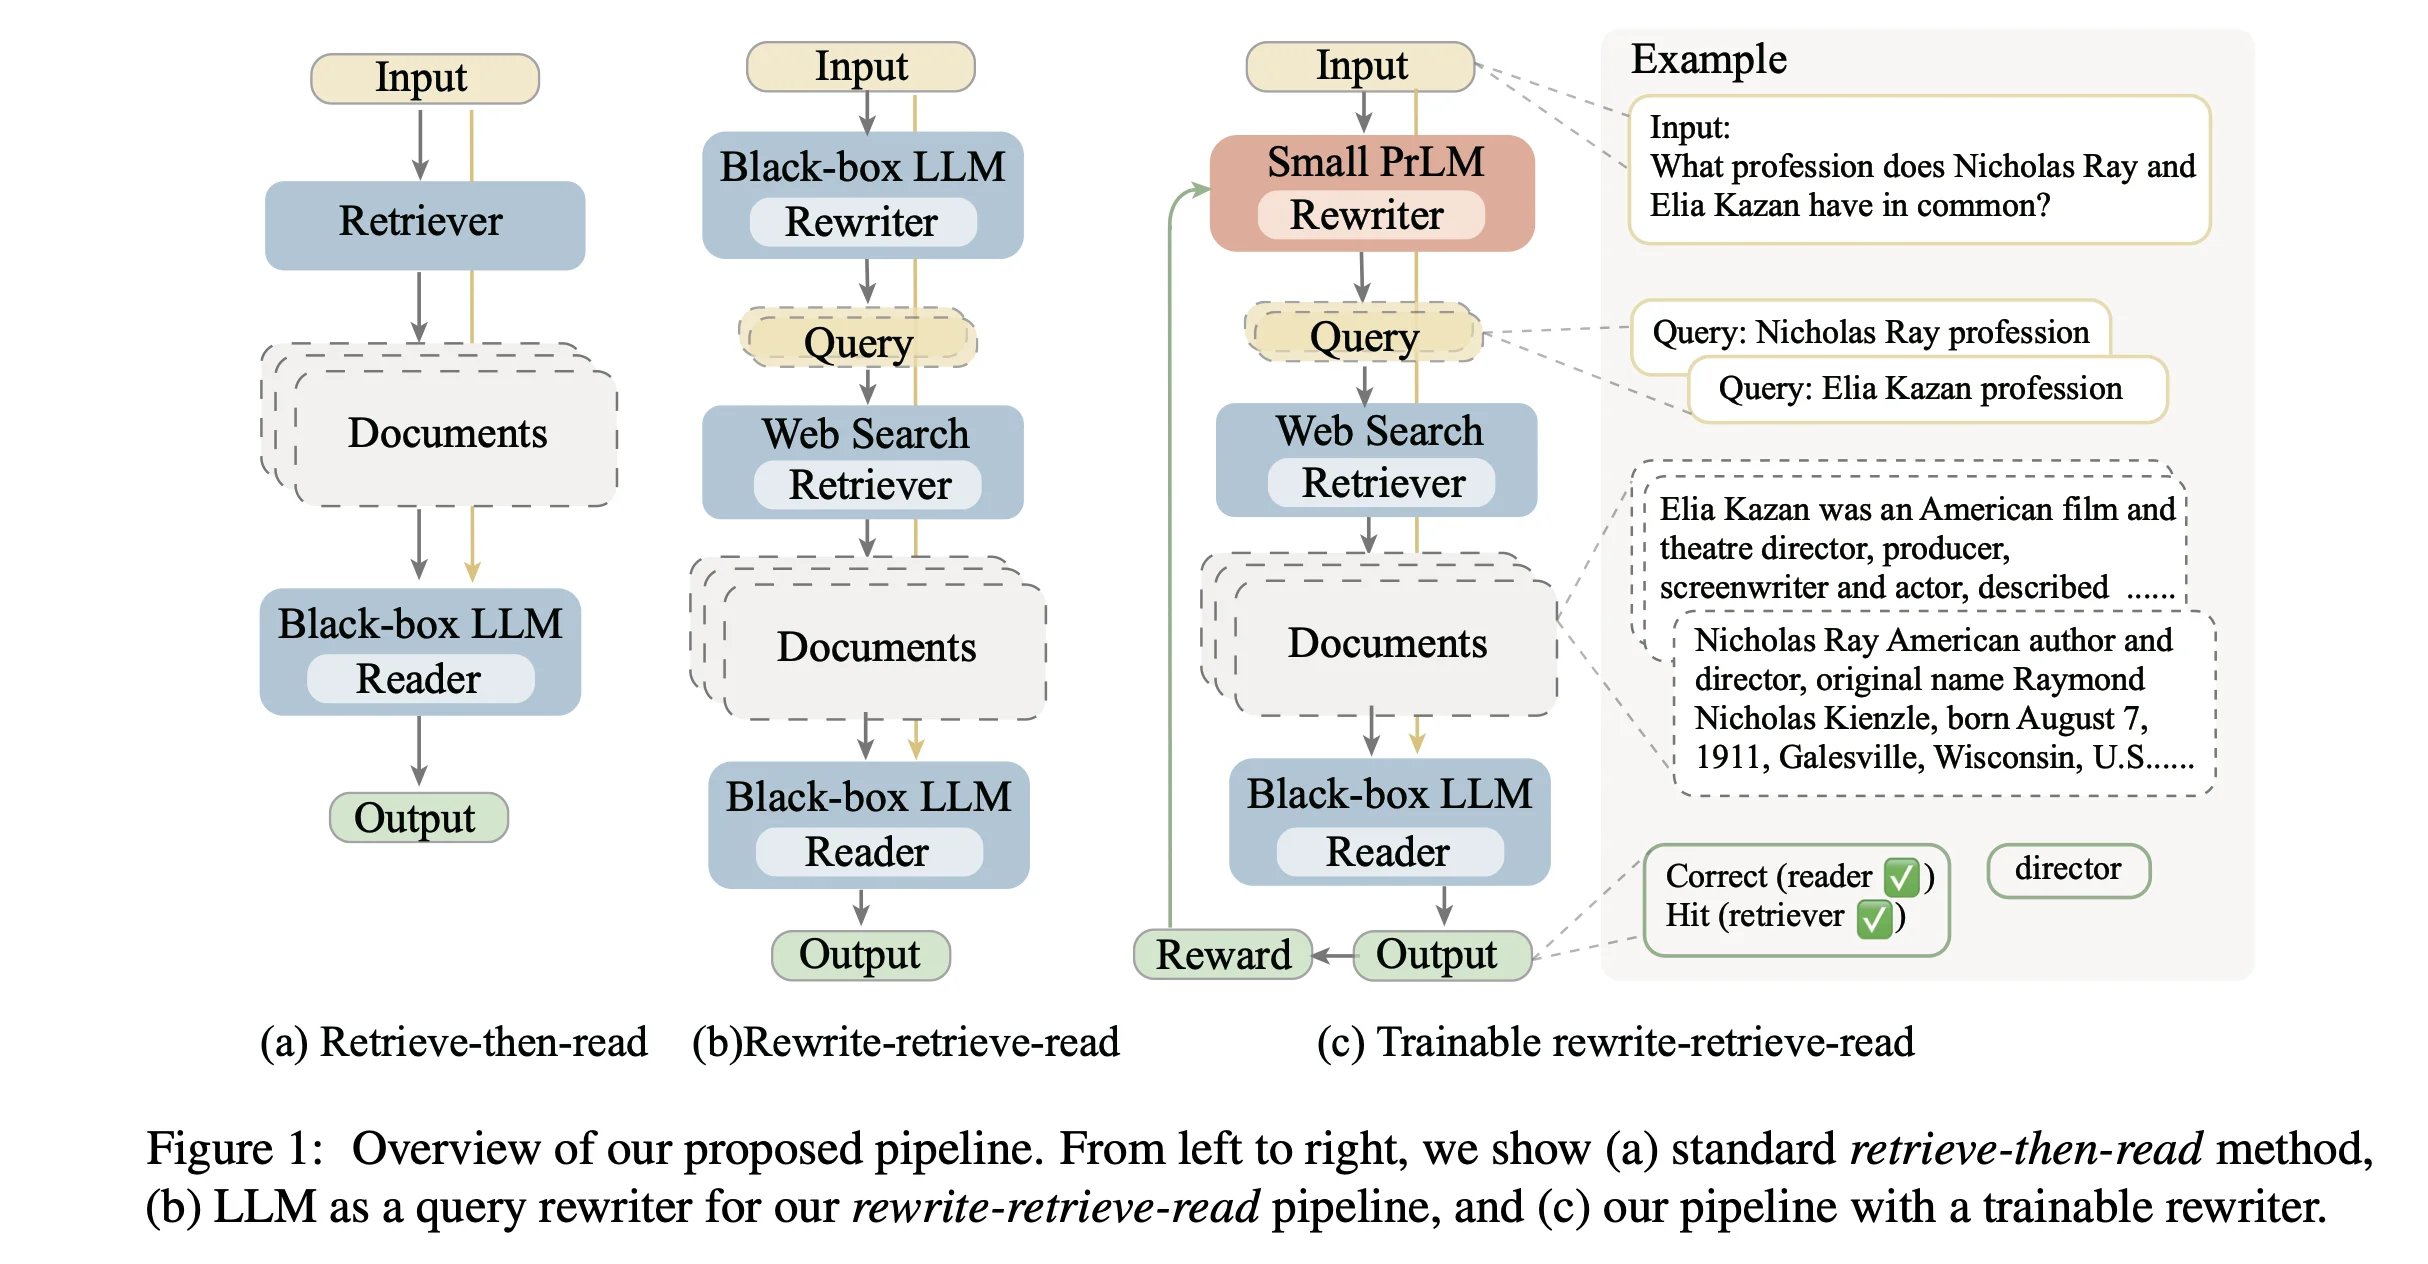
在 Query Rewriting for Retrieval-Augmented Large Language Models 这篇工作中, 作者还提出了 Trainable rewrite-retrieve-read的方法。即使用一个小的、可训练的语言模型(如T5)作为重写器,通过强化学习对其进行训练,具体来说, 先通过一定数量的伪数据集对重写器进行微调(warm-up),而后,在强化学习阶段,通过PPO(Proximal Policy Optimization)的方式,模型在每次生成新的查询后都会获得一个基于最终回答质量的奖励分数,从而强化那些能够提升最终回答质量的查询生成策略。
参考
Query Rewriting for Retrieval-Augmented Large Language Models
++all_rag_techniques_runnable_scripts++
Query Decomposition
对于复杂的问题无法单次查询获得有效结果,可以将原始问题分解成多个子问题,在经过多个子问题查询后, 根据所有子问题的查询结果,汇总并作出最后回答。
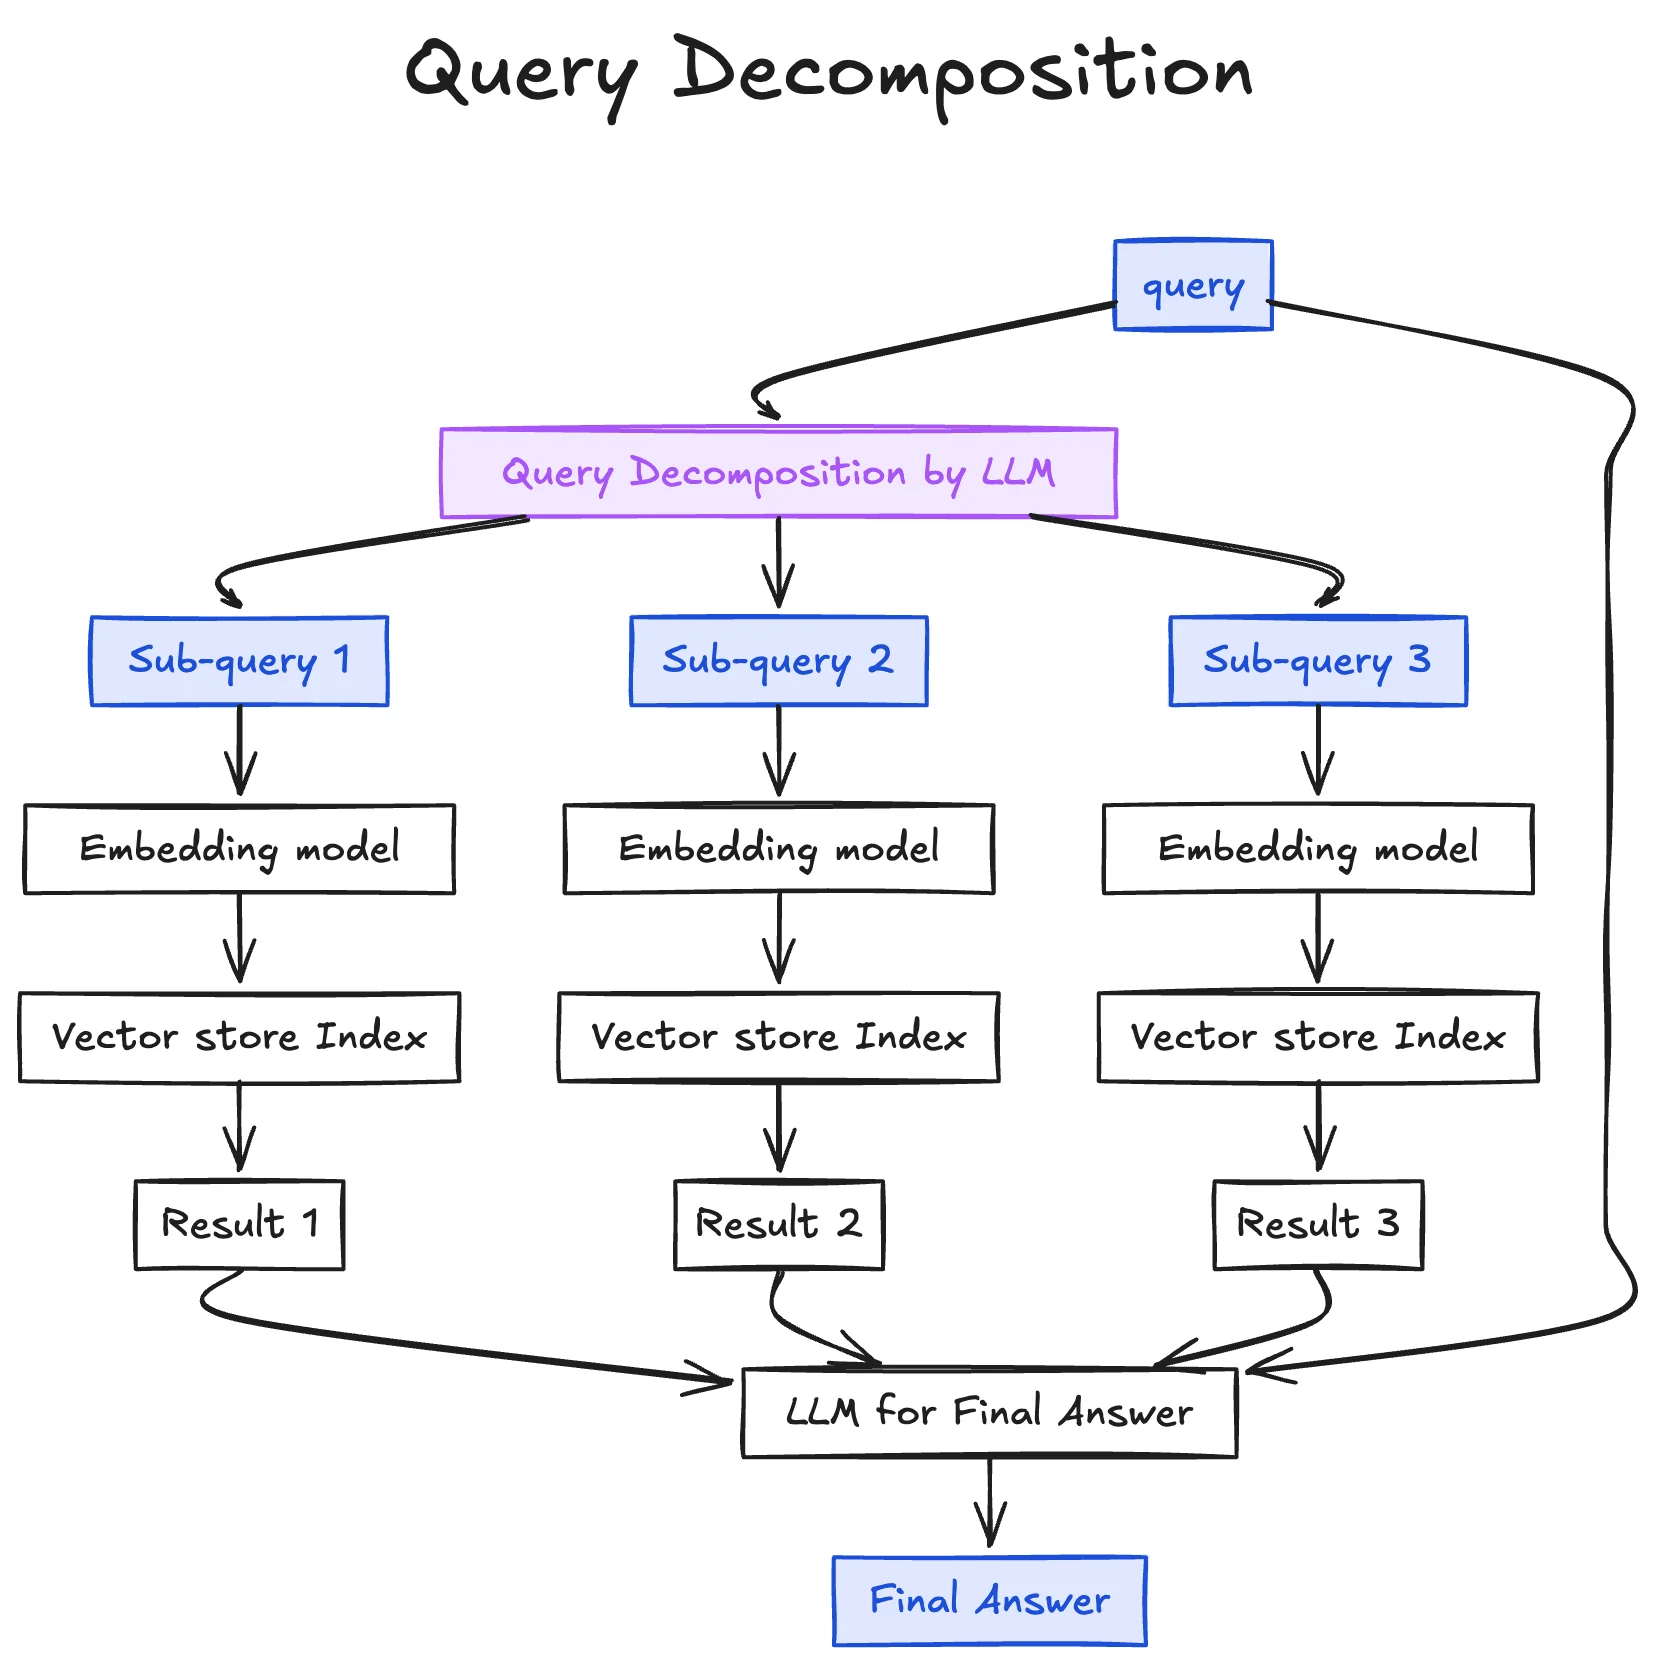
为了更有效地回答问题,我们需要将其拆分为不同的子问题,分别检索每个子问题的结果,并将这些发现整合,以形成一个更完整的答案。
prompt:
subquery_decomposition_template = """You are an AI assistant tasked with breaking down complex queries into simpler sub-queries for a RAG system.
        Given the original query, decompose it into 2-4 simpler sub-queries that, when answered together, would provide a comprehensive response to the original query.

        Original query: {original_query}

        example: What are the impacts of climate change on the environment?

        Sub-queries:
        1. What are the impacts of climate change on biodiversity?
        2. How does climate change affect the oceans?
        3. What are the effects of climate change on agriculture?
        4. What are the impacts of climate change on human health?"""
以原始查询 “ “比较太阳能和风能作为可再生能源的优缺点” 为例, 这是一个比较宽泛,需要横向对比,指出各自的优缺点,分解后的子查询:
- 太阳能发电的主要优点是什么?

- 太阳能发电面临哪些主要挑战?

- 风能发电有哪些优势?

- 风能发电的主要缺点是什么?
可以通过分解查询从各个角度分析两者的特性。
然而,这种Query Decomposition方法的局限性在于,它依赖于LLM的能力来合理分解问题,而人类的逻辑推理和问题分解依赖于经验积累和对问题的深入理解。因此,LLM在合理分解复杂问题方面仍存在一定差距,尤其在复杂性较高的领域中。此外,子问题的分解也可能导致查询延迟和成本的增加,这在实际应用中需要平衡效率与效果。
参考
llamaIndex:Multi-Step Query Engine
all_rag_techniques_runnable_scripts
Step Back Prompting
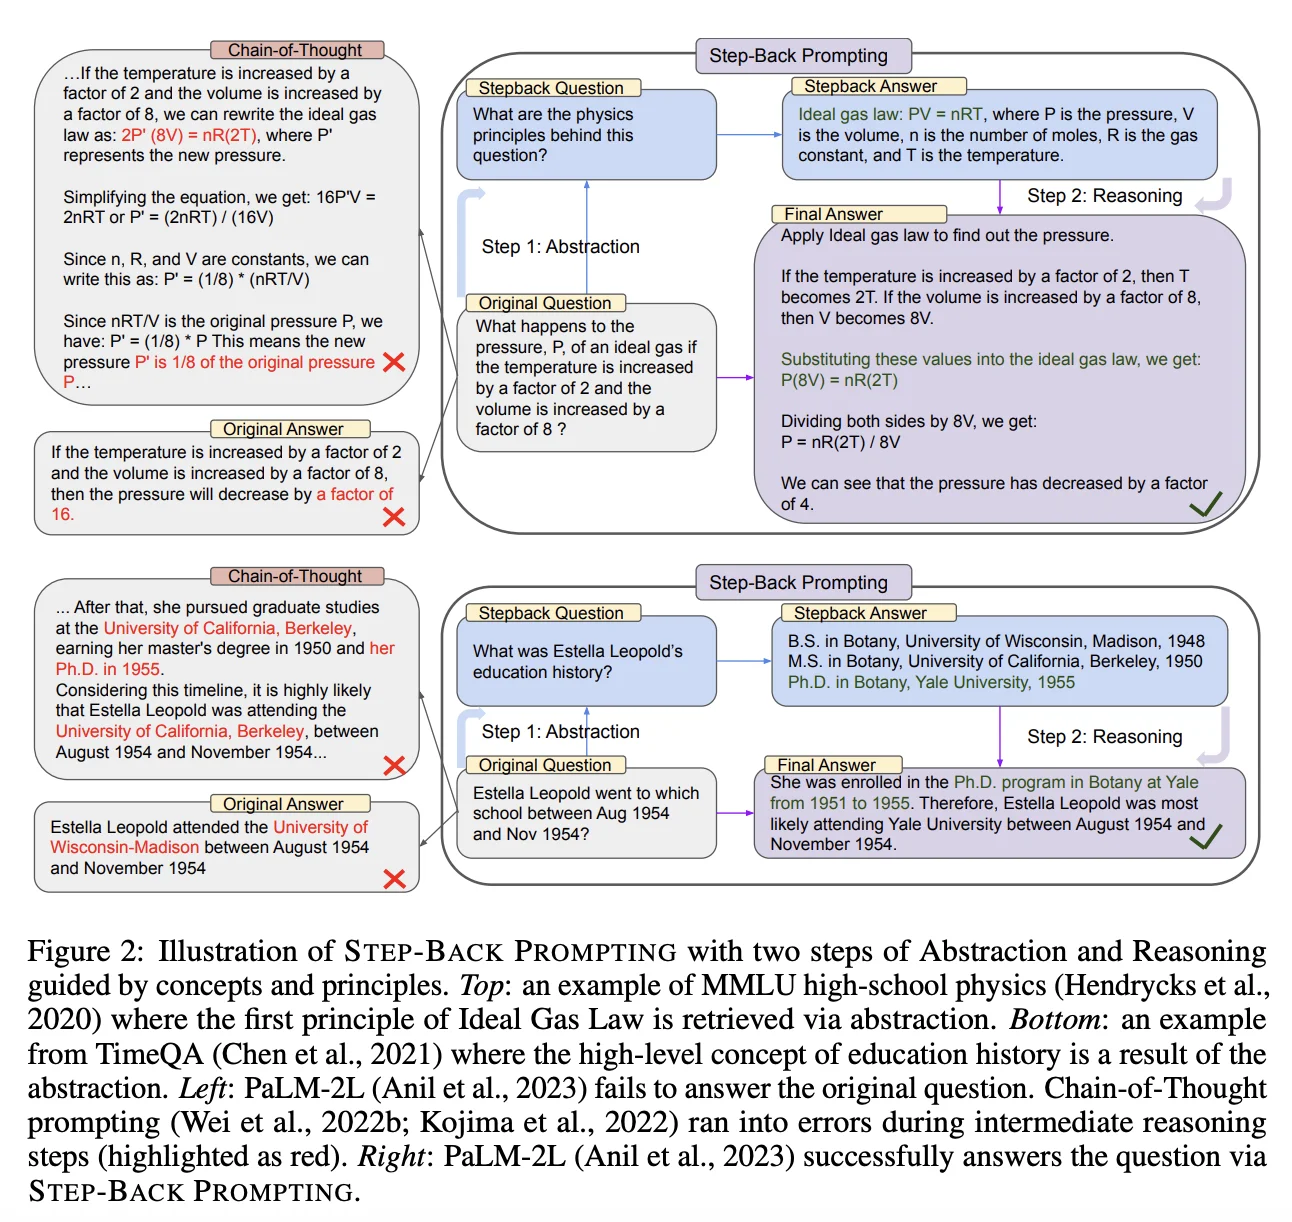
用户在提问时常常会涉及大量的隐性细节,但这些内容并没有显性提供给LLM,LLM在处理这类任务时可能会遇到难以准确检索相关知识,和无法准确回答问题。
Step-Back Prompting 正是基于这样一个观察,其灵感来自人类在面对复杂任务或问题时的习惯——我们通常会暂停片刻,从更高层次的概念或原则入手,以更清晰地思考下一步。例如,当需要计算一个三角形的边长时,我们可能会先回忆起勾股定理,这样有助于确定合适的解题方法。
在实际使用中,回溯提示法尤其适合处理科学、技术、工程和数学(STEM)类问题。这类问题通常包含复杂的显性和隐性细节,直接回答会让模型容易遗漏关键知识点。通过先抽象再推理的分步方法,模型能够更准确地检索、理解并整合背景知识,从而提供更精确的回答。
Step-Back Prompting 的核心流程包括两个步骤:抽象和推理。
抽象(Abstraction):在直接回答主要问题前,先让模型回答一个更高层次的问题,即与主要问题密切相关的概念性问题。
推理(Reasoning):一旦模型掌握了相关背景知识,就可以基于这些信息进行详细的推理过程,来解答主要问题。以此种方式分步思考,有助于模型准确地构建逻辑链条,并在回答中表现出更强的推理能力。
prompt:
step_back_template = """You are an AI assistant tasked with generating broader, more general queries to improve context retrieval in a RAG system.
        Given the original query, generate a step-back query that is more general and can help retrieve relevant background information.

        Original query: {original_query}

        Step-back query:"""
step_back_answer_template = """"""You are an expert of world knowledge. I am going to ask you a question. Your response should be comprehensive and not contradicted with the following context if they are relevant. Otherwise, ignore them if they are not relevant.

{normal_context}
{step_back_context}

Original Question: {question}
Answer:
"""
参考
A Step Forward with Step-Back Prompting
Hypothetical questions (HyDE)
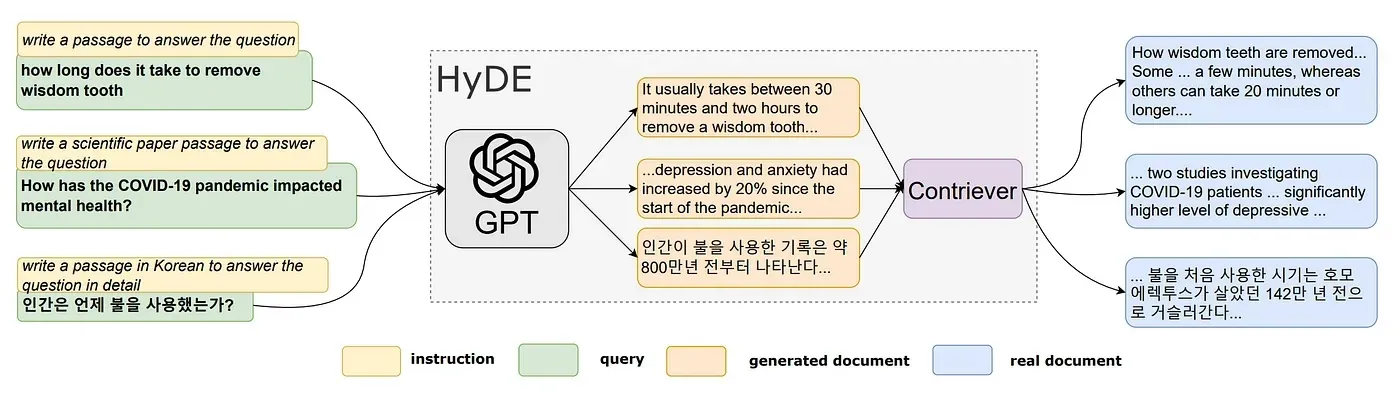
HyDE(Hypothetical Document Embeddings,假设性文档嵌入),通过生成假设性的答案并对这些生成的文档进行嵌入,而非嵌入原始文本。这种方法特别适用于用户问题简短且与需要查找的原始文本在语义上相似度不高的情况。
当用户的问题与知识库中的原始文本在语义上相差较大时,传统的文档检索方法可能无法有效地匹配到相关内容。HyDE通过使用大型语言模型(LLMs)根据用户问题生成格式上类似于知识库中文本的假设性答案,从而提升匹配的准确率。
尽管HyDE可以提升检索的准确性,但这种方法也会一定程度上增加检索的耗时。
参考
hypothetical_document_embeddings
HyDE (Hypothetical Document Embeddings)
Feedback-Based Query Refinement
人类在使用搜索引擎等工具进行信息查询时,通常并非一次就能找到答案,而是需要根据初始的结果不断调整和优化查询词。这样的过程是迭代式的,基于反馈不断精进,从而更贴近我们想要的目标。
严格来说,这部分内容可以归类到agent的范畴中,但将其归入RAG也未尝不可。RAG和agent并不应是彼此独立的体系,于是乎有“RAG的尽头是agent”的说法。
在agent的工具调用中,采用ReAct机制可以使得LLM根据查询结果动态修改查询,从而进行进一步的探究,而不只是简单地进行一次查询。相比于简单的RAG系统,借鉴了agent系统中的查询规划、记忆模块和路由机制之后,RAG可以变得更加强大。通过这种方式,系统能够更好地调整查询策略,不再仅依赖一次性的检索,而是可以进行智能的多轮交互。
在我自己的工作中,我将RAG中的检索部分独立出来,作为一个搜索引擎模块,也是为了后续能更好地接入到agent系统中。不过,本章的重点仍然是探讨RAG的改进方法,而不涉及过多关于agent系统的内容。
基于反馈与迭代的查询改写并不完全仅限于agent中的思路,更确切地说,这本身是符合人类在思考和解决问题时的方式。通过不断获取信息、修正查询,有助于在复杂问题上逐步接近正确的答案。
不少研究工作基于这一思路,其中一些值得深入探讨。
在RA-ISF这篇工作中,研究者通过迭代的方式处理问题,将任务分解,并使用三个子模块来增强模型的解决能力:自我知识模块(Self-Knowledge Module,SKM)、段落相关性模块(Passage Relevance Module,PRM)和问题分解模块(Question Decomposition Module,QDM)。
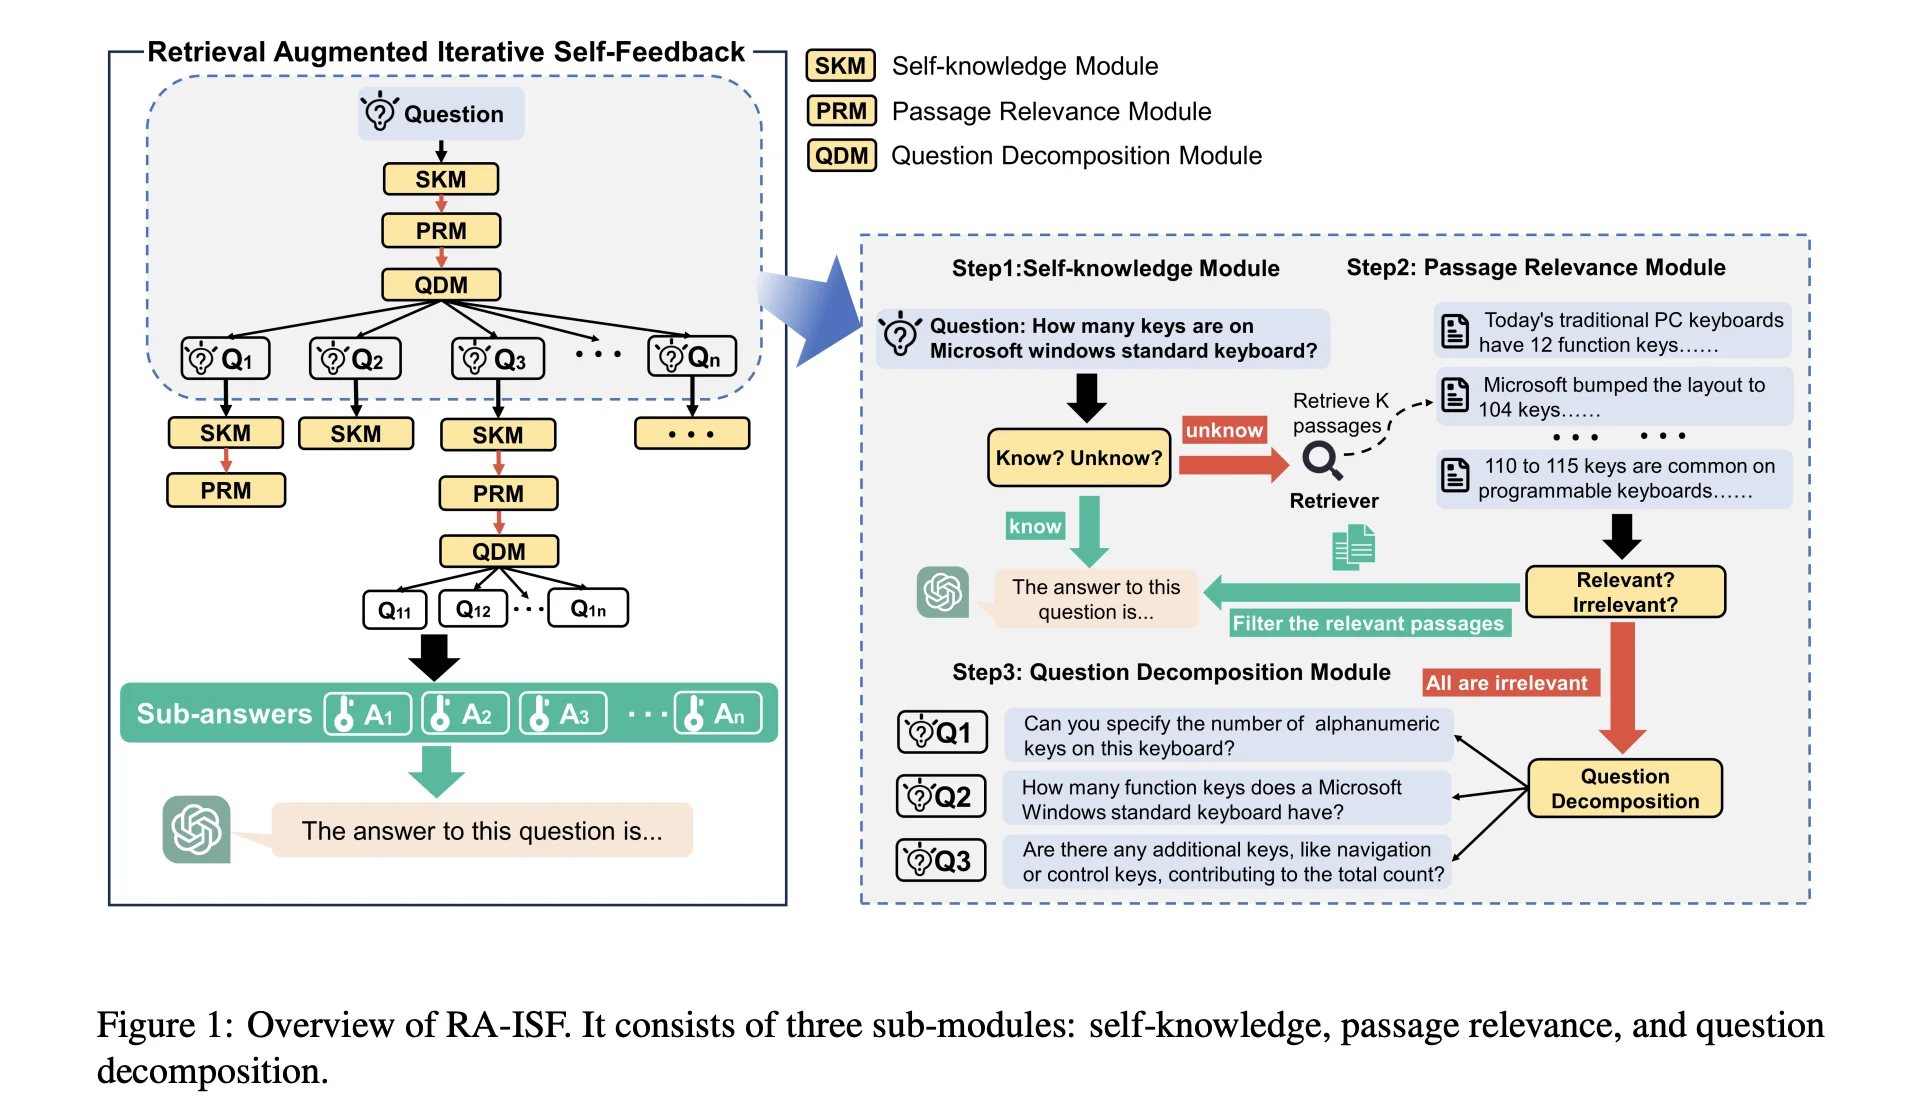
首先,使用SKM模块判断当前问题是否可以依靠模型的内部知识直接解答;然后将检索到的文本与问题结合,输入到PRM模块中,评估它们的相关性。如果相关,系统基于这些段落生成答案;如果所有检索到的文本都无关,则进入QDM模块,将问题分解为子问题,并对这些子问题进行逐步处理。对于每一个子问题,系统会依次进入SKM、PRM和QDM模块,直到最终将所有子问题的答案整合,生成对原始问题的完整解答。
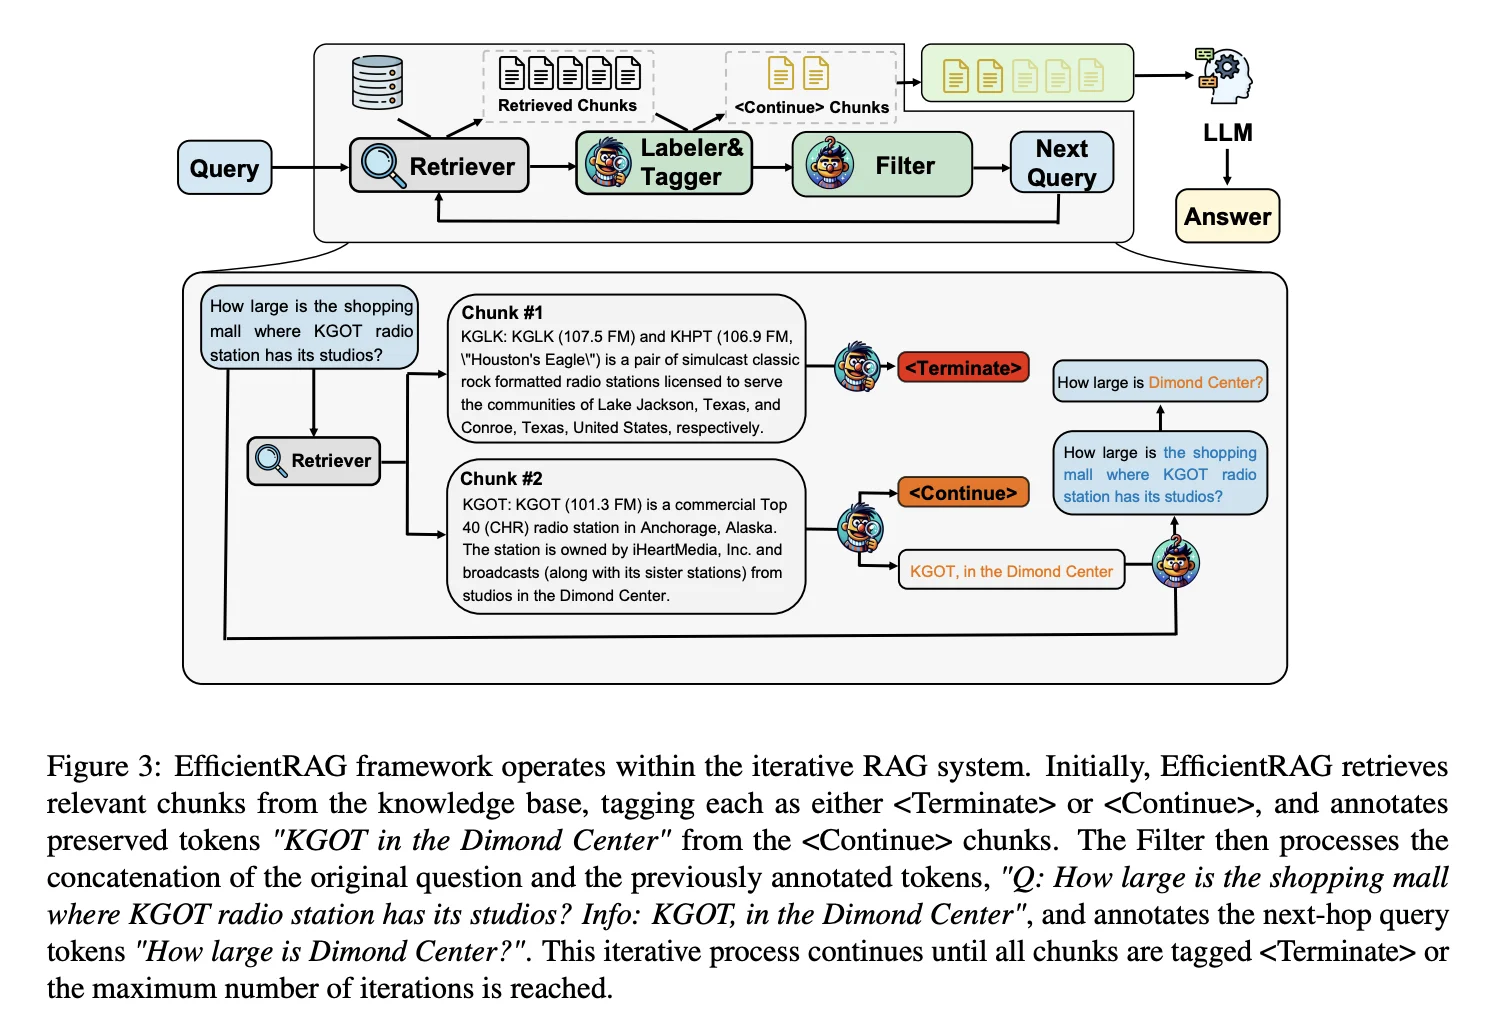
在EfficientRAG这项研究中,针对多跳问题的解答,提出了一种新的方法,通过迭代生成新查询并过滤掉不相关信息,从而提高检索效率,而非重复调用LLM进行查询改写。在EfficientRAG中,包含两个轻量级组件:Labeler & Tagger和Filter。Filter组件在chunk级别筛选最相关的检索信息,而Labeler & Tagger组件在token级别识别和标记有用的信息。通过迭代地检索、标记和过滤,直到收集到足够的信息来回答问题,从而提高整个系统的效率。
ITER-RETGEN是通过迭代结合检索(Retrieval)和生成(Generation)来增强RAG模型性能的另一种方案。
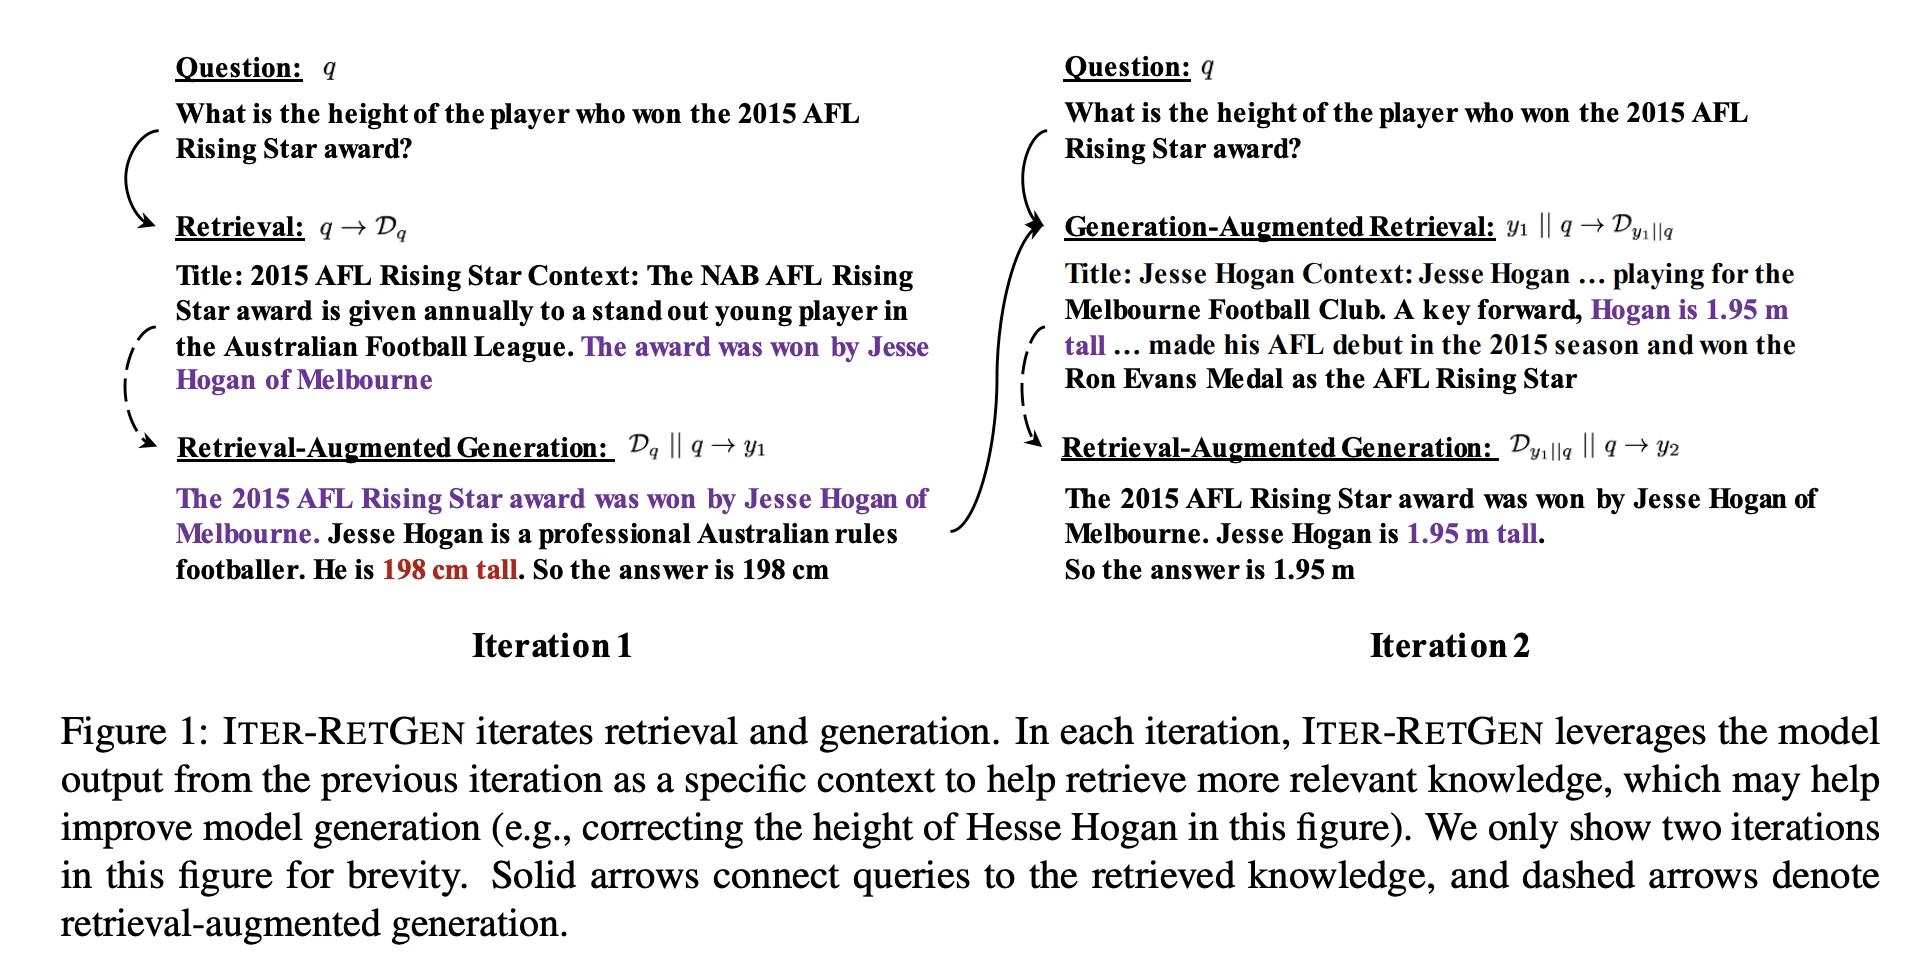
给定一个问题$q$和一个包含段落的文档集$D$,ITER-RETGEN会在T次迭代中反复进行“检索-生成”操作。在第$t$次迭代时,它使用上次生成的答案$y_{t-1}$和问题$q$组合,从文档集中检索出前k个相关段落,再利用大语言模型$M$基于这些段落和问题生成新的答案$y_t$。每次迭代的过程可以表示为:
$$ y_t = M\left(y_t \mid \text{prompt}(D_{y_{t-1}} , || , q, q)\right), \quad \forall 1 \leq t \leq T $$
最终,经过T次迭代,得到的最后一个输出$y_T$就是对原始问题的最终答案。通过这种迭代方式,系统能够有效地从复杂信息中逐步逼近正确答案。
参考
RA-ISF: Learning to Answer and Understand from Retrieval
EfficientRAG: Efficient Retriever for Multi-Hop Question Answering