If you want to make a good RAG tool that uses your documentation, you should start by making a search engine over those documents that would be good enough for a human to use themselves. This is likely something your organization has considered before, and if it doesn’t exist it’s because building a good search engine has traditionally been a significant undertaking.
— from Build a search engine, not a vector DB
一个优秀的RAG背后, 一定有一个优秀的搜索引擎;
很多时候,在针对通用场景下, 如果能够调用常见的搜索引擎,如google 或者bing, RAG的效果一般不会太差;
但,当考虑到一些垂直场景, 我们需要构造属于自己的“搜索引擎”,而往往根据特定的场景,在索引构建上会有特殊处理;可以参考devv,在针对代码场景下, 对RAG的检索部份也做了不少的工作和设计;
很显然, 检索不是仅仅使用向量匹配和向量库就能搞定的事情;
考虑到前LLM时代的NLP检索(甚至是图像检索),或者是推荐系统, 其实会发现, 这些东西并没有什么太大的变化,思路和技术依旧是可以复用的。
vector-search is not all you need
纯粹基于向量匹配实现起来很简单,但不是万能的
其问题来源有:
embedding模型一般在通用预料上做训练, 在特定领域下, 其效果并不会太好,很多时候需要在特定领域语料上再做微调;
语义匹配不见得是万能的,对于一些特定场景,其局限性尤为明显。例如,当用户询问一个具体的名词时,就会发现单纯使用向量匹配只能匹配到大致的相似度,对于具体的关键词是无能为力的。 这种情况下,语义匹配往往难以捕捉到用户提问中的精确细节。例如,用户可能询问特定型号的苹果电脑(如“MacBook Pro 2021”),但语义匹配算法可能会返回类似类型或年份的苹果电脑,而不是确切的型号。此时语义匹配的效果并不会太好。
embedding模型计算的是输入的两个文本(A和B)的相似度。然而,在实际应用中,输入的是一个问句(query),需要匹配的是一段文字。在这种情况下,我们关注的重点是文本之间的相关性而非简单的相似性。因此,通常在使用embedding模型后,还需要一个reranking模型,根据相关性对结果进行排序,以确保返回最相关的答案。
对于组合的问题无效;如果query是一些复杂的需要一些推理的问题(如多跳),使用vector- search显然不是好办法;这类问题通常涉及多个子问题,每个子问题的答案都是解答下一个问题的基础, 举例来说,回答“谁是发明电话的人的孙子在2020年的职业是什么?”需要知道发明电话的人是谁,接着找出他的孙子,然后查询这个孙子的职业。面对需要多步推理的复杂问题时,向量搜索的能力有限,原因在于它不可能进行复杂的逻辑推理和多步信息整合。在这样的场景下,需要的是Agent将query进行分解,然后分别调用工具(搜索引擎);
其实我们可能过于迷信向量搜索。事实上,对于一些简单的场景,基于倒排索引的关键词匹配效果更好、更加简单且成本更低。倒排索引是一种高效的文本检索方法,通过建立关键词到文档的映射,可以快速找到包含特定关键词的文档。对于不需要复杂推理的简单查询,倒排索引可以提供快速且准确的搜索结果。
不止只有向量检索
稀疏向量(Sparse)和稠密向量(Dense)是通过不同的算法计算的。稀疏向量主要由零值组成,只有少数几个非零值,而稠密向量则主要包含非零值。稀疏嵌入由算法如BM25和SPLADE生成,而稠密嵌入则由机器学习模型如GloVe和Transformers生成。
TF-IDF(Term-Frequency Inverse-Document Frequency)是一种用于评估文本中一个词对一个文档的重要程度的统计方法。其原理基于两个指标:词频(TF)和逆文档频率(IDF)。
词频(TF):表示某个词在文档中出现的频率,计算公式为:
$$ \text{TF}(t,d) = \frac{\text{词t在文档d中出现的次数}}{\text{文档d中的总词数}} $$
逆文档频率(IDF):衡量某词在整个文档集合中重要性的指标。公式为:
$$ \text{IDF}(t) = \log\left(\frac{\text{总文档数}}{\text{包含词t的文档数} + 1}\right) $$
TF-IDF值通过将词频和逆文档频率相乘计算得到:
$$ \text{TF-IDF}(t,d) = \text{TF}(t,d) \times \text{IDF}(t) $$
BM25(Best Matching 25)是一种基于概率模型的文本检索算法,它在TF-IDF(词频-逆文档频率)的基础上进行改进。BM25通过引入二元独立模型,并添加归一化惩罚来计算文档长度相对于数据库中所有文档平均长度的权重。
BM25的核心公式如下:
$$ \text{BM25}(q, D) = \sum_{i=1}^{n} \text{IDF}(q_i) \cdot \frac{f(q_i, D) \cdot (k_1 + 1)}{f(q_i, D) + k_1 \cdot (1 - b + b \cdot \frac{|D|}{\text{avgdl}})} $$
其中:
-
q 代表查询
-
D 代表文档
-
$q_i$ 是查询中的第i个词
-
$f(q_i, D)$ 是词 ($q_i$) 在文档 (D) 中的词频
-
|D| 是文档 (D) 的长度(以词计)
-
$\text{avgdl}$ 是集合中所有文档的平均长度
-
$k_1$ 和 b 是调节参数,通常 $k_1$ 在1.2到2之间,b 取0.75
-
$\text{IDF}(q_i)$是词 $q_i$ 的逆文档频率
Dense vector 使用稠密向量表示存储在数据库中的信息,包括文本、图像和其他类型的数据,。这些嵌入由机器学习模型生成,将数据转换为向量。也就是最近两年大家常说的向量检索。
如何提升检索效果:
自然而然的想法,不再使用单一的向量检索, 而是采用多种检索方式混合的方式,不论是混合不同的embedding模型的检索还是Sparse-vector和Dense-vector混合使用以获得二者的优势。通常来说,稠密向量擅长理解查询的上下文,而稀疏向量则擅长关键词匹配。
那么需要将二者合并,but how?
Reciprocal Rank Fusion (RRF) 其核心思想是通过计算每个文档在不同排名列表中的倒数排名之和来确定最终排名。这样,排名较高的文档会得到更高的分数,而排名较低的文档会受到惩罚。
RRF的计算公式如下:
$$ \text{RRF}(d) = \sum{i=1}^{N} \frac{1}{k + r_{i}(d)} $$
其中:
-
(d) 代表文档
-
(N) 是排名列表的数量
-
(k) 是一个常数,用于平滑处理,通常取值为60
-
($r_{i}(d)$) 是文档 (d) 在第 (i) 个排名列表中的排名
通过这个公式,每个文档的最终RRF分数是其在所有排名列表中的倒数排名之和,分数越高,排名越靠前。
在langchain **ensemble-retriever**的源码中可以看到其具体的思想逻辑:
def weighted_reciprocal_rank(
        self, doc_lists: List[List[Document]]
    ) -> List[Document]:
        """
        Perform weighted Reciprocal Rank Fusion on multiple rank lists.
        You can find more details about RRF here:
        https://plg.uwaterloo.ca/~gvcormac/cormacksigir09-rrf.pdf

        Args:
            doc_lists: A list of rank lists, where each rank list contains unique items.

        Returns:
            list: The final aggregated list of items sorted by their weighted RRF
                    scores in descending order.
        """
        if len(doc_lists) != len(self.weights):
            raise ValueError(
                "Number of rank lists must be equal to the number of weights."
            )

        # Associate each doc's content with its RRF score for later sorting by it
        # Duplicated contents across retrievers are collapsed & scored cumulatively
        rrf_score: Dict[str, float] = defaultdict(float)
        for doc_list, weight in zip(doc_lists, self.weights):
            for rank, doc in enumerate(doc_list, start=1):
                rrf_score[
                    doc.page_content
                    if self.id_key is None
                    else doc.metadata[self.id_key]
                ] += weight / (rank + self.c)

        # Docs are deduplicated by their contents then sorted by their scores
        all_docs = chain.from_iterable(doc_lists)
        sorted_docs = sorted(
            unique_by_key(
                all_docs,
                lambda doc: doc.page_content
                if self.id_key is None
                else doc.metadata[self.id_key],
            ),
            reverse=True,
            key=lambda doc: rrf_score[
                doc.page_content if self.id_key is None else doc.metadata[self.id_key]
            ],
        )
        return sorted_docs
排序模型

在信息检索和问答系统中,处理用户查询通常分为两个步骤:召回(retrieval)和重排序(reranking)。
召回的目标是用非常短的时间在海量数据中找到一定范围的备选项。这一过程的精度可能不会特别高,但可以将候选项从千万量级压缩到百量级。(这一过程涉及ANN也就是Approximate Nearest Neighbor, 在本文的后段会提及)
重排序阶段,需要从召回阶段的备选项中选择符合需要的选项。由于候选项数量已经大幅减少,可以采用精度较高但相对计算时间较长的算法对这些备选项进行重新排序,以提高最终结果的准确性。
重排序阶段场景的模型如`BAAI/bge 系列,从其huggingface仓库中的config.json可以发现:
"_name_or_path": "BAAI/bge-m3",
  "architectures": [
    "XLMRobertaForSequenceClassification"
  ],
其本质是基于**XLM-RoBERTa**的序列分类模型。在下游任务中,对于序列分类任务,XLMRobertaForSequenceClassification 在 XLM-RoBERTa 的基础上添加了一个分类层(一个全连接层)来进行分类;简单来说,对于信息检索或问答系统中,输入用户问题(query),和匹配到的doc,通过合并query和doc形成一个sequence([CLS]query[SEP]doc[SEP]),通过XLMRobertaForSequenceClassification
可以计算出二者的相关性分数,遍历候选集中的doc(一般在百数量级左右),即可得到query同候选集相关性分数。
一些新的工作
Matryoshka Representation Learning(MRL)
来源于OpenAI 的embedding 技术:New embedding models and API updates
和NeurIPS 2022发表的论文:Matryoshka Representation Learning
Motivation:现有的深度学习模型通常学习固定维度的表示,无法灵活适应任务需求;表示维度的难以确定;表示维度缺乏粗到细(coarse-to-fine)的粒度;
MRL旨在学习具有不同粒度的表示,允许单个embedding适应下游任务的计算约束。其设计思想是为了在不同的embedding维度上使用损失函数,从而训练一个模型,使其在不同的embedding维度上都能保持良好的性能
训练过程:MRL 在多个嵌套的维度上训练模型,使得每个低维度的表示都能作为数据点的有用表示。这样,模型在不同的任务和计算约束下都能表现良好。
推理过程:在推理过程中,MRL 可以根据需要使用不同维度的嵌入。对于分类任务,可以从低维度开始,逐步使用更高维度的表示。对于检索任务,可以先使用低维度表示进行初步筛选,然后使用高维度表示进行精细排序。
(具体可以参考论文和sentence_transformers中所实现的MatryoshkaLoss)
bge-m3
m3—即Multi-Linguality 支持多语言, Multi-Functionality 支持多种检索方式(Dense-retrieval,Sparse-Retrieval, Multi-Vec Retrieval),以及Multi-Granularity 支持多粒度的检索(sentence-level,Passage-level,和Doc-level)
pip install -U FlagEmbedding
- Dense Embedding
from FlagEmbedding import BGEM3FlagModel

model = BGEM3FlagModel('BAAI/bge-m3',
                       use_fp16=True) # Setting use_fp16 to True speeds up computation with a slight performance degradation

sentences_1 = ["What is BGE M3?", "Defination of BM25"]

model.encode(sentences_1)

print(model.encode(sentences_1)['dense_vecs'].shape)

# (2, 1024)
- Sparse Embedding (Lexical Weight)
output_1 = model.encode(sentences_1, return_dense=True, return_sparse=True, return_colbert_vecs=False)

output_1

"""
{'dense_vecs': array([[-0.03412  , -0.04706  , -0.0009317, ...,  0.0483   ,  0.007576 ,
         -0.02959  ],
        [-0.01026  , -0.0449   , -0.02432  , ..., -0.00828  ,  0.01502  ,
          0.011086 ]], dtype=float16),
 'lexical_weights': [defaultdict(int,
              {'4865': 0.0836,
               '83': 0.0814,
               '335': 0.1295,
               '11679': 0.252,
               '276': 0.17,
               '363': 0.2695,
               '32': 0.04083}),
  defaultdict(int,
              {'262': 0.04996,
               '5983': 0.1367,
               '2320': 0.04483,
               '111': 0.06335,
               '90017': 0.2517,
               '2588': 0.3335})],
 'colbert_vecs': None}

"""

# you can see the weight for each token:
print(model.convert_id_to_token(output_1['lexical_weights']))

# [{'What': 0.08356, 'is': 0.0814, 'B': 0.1296, 'GE': 0.252, 'M': 0.1702, '3': 0.2695, '?': 0.04092},
#  {'De': 0.05005, 'fin': 0.1368, 'ation': 0.04498, 'of': 0.0633, 'BM': 0.2515, '25': 0.3335}]

# compute the scores via lexical mathcing
print(model.compute_lexical_matching_score(output_1['lexical_weights'][0], output_1['lexical_weights'][1]))
# 0
- Multi-Vector (ColBERT)
sentences_1 = ["What is BGE M3?", "Defination of BM25"]
output_1 = model.encode(sentences_1, return_dense=True, return_sparse=True, return_colbert_vecs=False)
print(output_1['colbert_vecs'][0].shape)
# (8, 1024)
print(model.colbert_score(output_1['colbert_vecs'][0], output_1['colbert_vecs'][1]))
# tensor(0.4768)
ColBERT score: 在计算完查询和文档之间的相似度矩阵后,对每个查询token选择与文档中token的最大相似度,将所有最大相似度累加,得到最终的colbert_score。
基于LLM实现embedding
几个代表模型:
Alibaba-NLP/gte-Qwen2-7B-instruct
intfloat/e5-mistral-7b-instruct
e5-mistral-7b-instruct论文:Improving Text Embeddings with Large Language Models
config.json:
{
  "_name_or_path": "mistralai/Mistral-7B-v0.1",
  "architectures": [
    "MistralModel"
  ],
  "bos_token_id": 1,
  "eos_token_id": 2,
  "hidden_act": "silu",
  "hidden_size": 4096,
  "initializer_range": 0.02,
  "intermediate_size": 14336,
  "max_position_embeddings": 32768,
  ...
通过LLM生成数据(合成数据), 采用对比学习微调Mistral-7B;
Given a pretrained LLM, we append an [EOS] token to the end of the query and document, and then feed them into the LLM to obtain the query and document embeddings $(h_{q_{inst}^+}, h_d^+)$, by taking the last layer [EOS] vector.
附录
如何找到合适的embedding模型和reranker模型
首先推荐从 huggingface MTEB Leaderboard上选择排名靠前的模型
其次,实验!根据自己的场景构造测试集验证,才能选择出适合自己场景的embedding模型和reranker模型;
embedding模型和reranker模型的注意事项
-
上下文长度限制。 这些模型大多本质是Bert-based 模型, 而Bert的上下文长度限制一般是512,具体可以在huggingface中的
config.json中查看;以BAAI/bge-base-en-v1.5 为例{ "_name_or_path": "/root/.cache/torch/sentence_transformers/BAAI_bge-base-en/", "architectures": [ "BertModel" ], "attention_probs_dropout_prob": 0.1, "classifier_dropout": null, "gradient_checkpointing": false, "hidden_act": "gelu", "hidden_dropout_prob": 0.1, "hidden_size": 768, "id2label": { "0": "LABEL_0" }, "initializer_range": 0.02, "intermediate_size": 3072, "label2id": { "LABEL_0": 0 }, "layer_norm_eps": 1e-12, "max_position_embeddings": 512, "model_type": "bert", "num_attention_heads": 12, "num_hidden_layers": 12, "pad_token_id": 0, "position_embedding_type": "absolute", "torch_dtype": "float32", "transformers_version": "4.30.0", "type_vocab_size": 2, "use_cache": true, "vocab_size": 30522 }其中`
"max_position_embeddings": 512,也就是它的上下文长度,但输入sequence长度超过512个token,则模型只看到了最前面的512个token; -
向量维度
-
微调
如何微调embedding 模型
采用FlagEmbedding,参考:How to fine-tune bge embedding model?
微调Sentence Transformer,参考:Training Overview
还有哪些类型的reranker模型
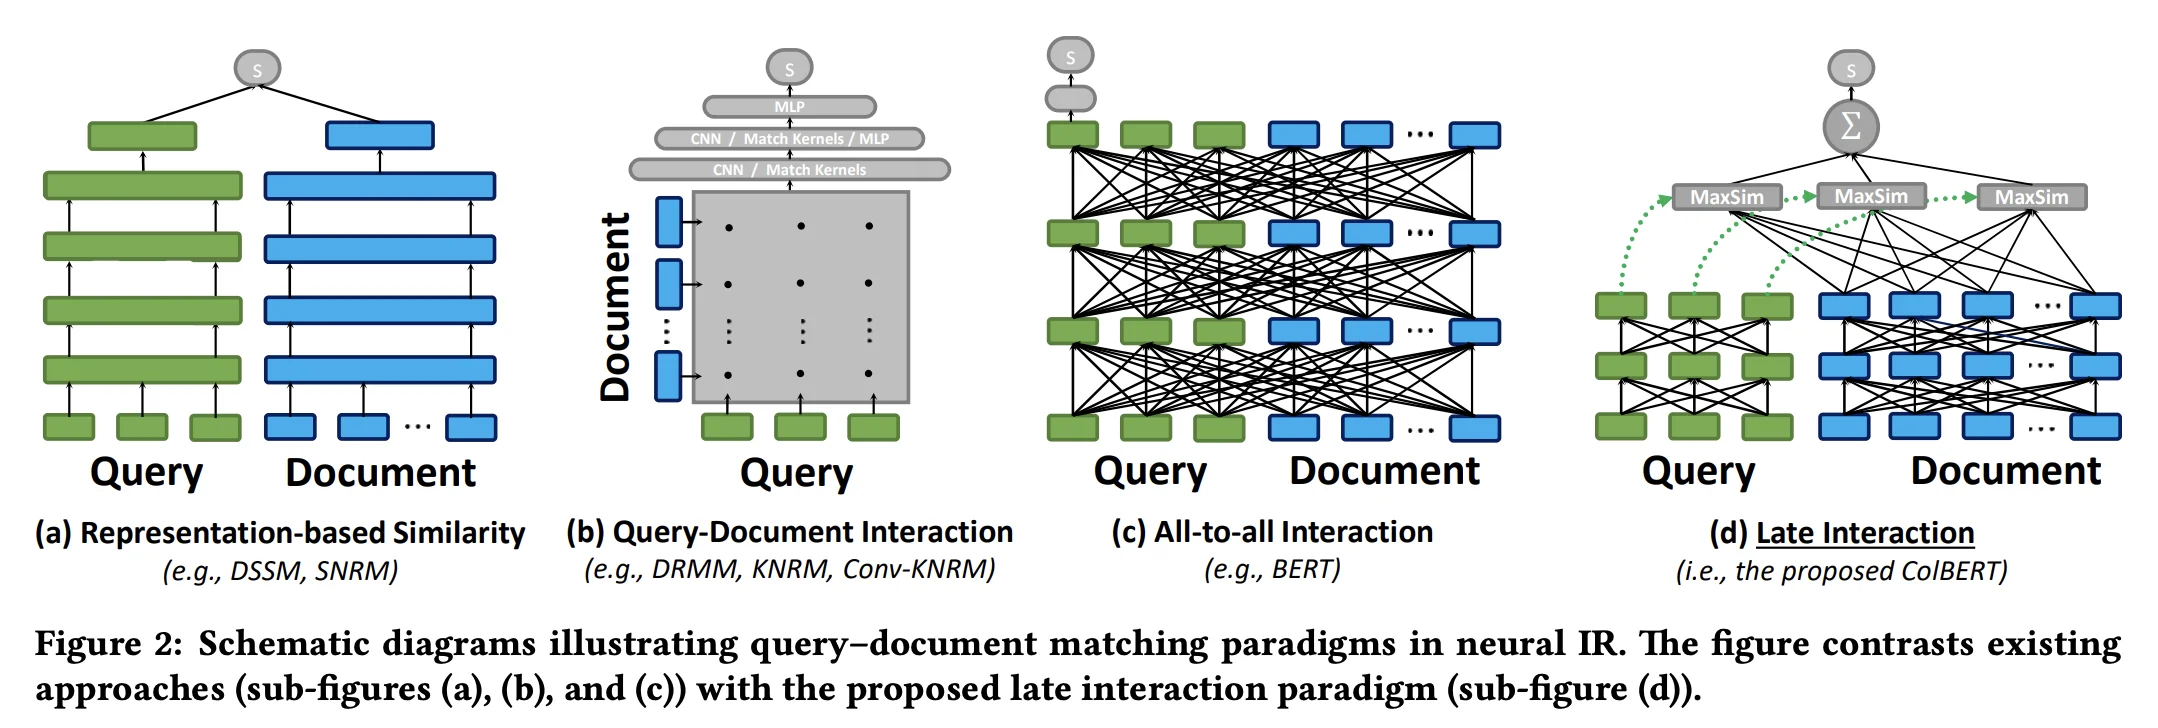
根据ColBert文章
作者将query-document matching 任务(reranking)分类成:
-
Representation-based Similarity, 双塔,独立对查询和文档进行编码,然后通过计算它们的向量相似度进行匹配, 但query和doc间无更精细的交互。
-
Query-Document interaction: 在查询和文档之间直接进行交互,通常使用CNN来捕捉查询和文档之间的交互特征, 但交互计算复杂度较高,尤其是当查询和文档长度较长时。
-
All-to-All Interaction,基于Bert 的Cross-encoder结构, 查询和文档的每个词与对方的每个词进行全连接交互。这种方式可以捕捉细粒度的交互信息,通常需要较高的计算资源。
-
Late Interaction, 迟交互型,在对查询和文档的每个词进行独立编码后,再进行交互计算。通常使用最大池化(MaxSim)来选择最相关的词进行匹配,从而结合了高效性和细粒度交互的优点。
此外, 当然也有基于LLMs的reranker,参考:llm_reranker
以 BAAI/bge-reranker-v2-gemma 为例, 只是做这样一件事
prompt = "Given a query A and a passage B, determine whether the passage contains an answer to the query by providing a prediction of either 'Yes' or 'No'."
以输出“Yes” 的logit 作为相关分数
对比学习
在之前不断提到了embedding,当然, 和transformer中的embedding层不是一个东西;
这里所指的embedding是通过对比学习的方式,将语义相近的文本映射到高维参数空间中的相近位置,使它们的距离尽可能短。相反,语义差别大的文本则被映射到参数空间中远离的位置。类似地,这种方法也可以应用于图像(相似图像检索)以及文本和图像的多模态语义匹配(如CLIP)。那么,对比学习有三个核心:loss function,网络架构和采样。
对比学习有三个核心要素:网络架构、损失函数(loss function)和采样策略。
常见的损失函数有contrastive loss、triplet loss,以及N-pair loss。
网络架构方面,对比学习通常采用双塔(siamese network)或者三塔(triplet)结构。双塔结构包含两个相同或相似的编码器,分别用于处理正样本对;三塔结构则增加了一个用于处理负样本的编码器。这些编码器可以是各种深度学习模型,如CNN、RNN或Transformer等,具体选择取决于任务域和数据类型。这一步将原始较为复杂的数据类型,通过深度学习的方法降到相对较低的维度便于之后的计算。
对于双塔结构, 一般采用Contrastive Loss, 其用于度量两个样本之间的相似度。其公式为:
$$ L = \frac{1}{2N} \sum_{i=1}^N (y_i d_i^2 + (1 - y_i) \max(0, m - d_i)^2) $$
其中:
-
$d_i$是样本对$(x_i, x_j)$ 的欧几里得距离。
-
$y_i$ 是样本对的标签,1 表示正样本对,0 表示负样本对。
-
m 是一个超参数,表示负样本对之间的最小距离,也称margin。
Triplet Loss则使用于triplet-network结构, 其通过构造三元组 ( anchor, positive, negative) 来训练模型,使得正样本(positive)与锚点(anchor)的距离小于负样本(negative)与锚点的距离。其公式为:
$$ L = \sum_{i=1}^N \left[ |f(x_i^a) - f(x_i^p)|_2^2 - |f(x_i^a) - f(x_i^n)|_2^2 + \alpha \right] $$
其中:
-
$f(x)$ 表示样本 x 的特征向量。
-
$\alpha$是一个超参数,表示正负样本对之间的最小距离差。
N-pair Loss 是 Triplet Loss 的推广,通过引入多个负样本来提升训练效果。
$$ L = \sum_{i=1}^N \log \left( 1 + \sum_{j \neq i} \exp \left( f(x_i)^\top f(x_j^n) - f(x_i)^\top f(x_i^p) \right) \right) $$
在训练过程中, 采样策略则很关键;但运气不好, 选择的样本都是Easy Negative mining,也就是$d(a,p)+margin<d(a,n)$,则模型能够很快收敛,但什么也没有学会,相反在另一个极端中, 采用的多是hard negative mining,也就是$d(a,n)<d(a,p)$的情况,此时模型训练将很难收敛;实际情况中, 往往采用semi-hard 或者是distance-weighted sampling 来寻找难度适中的负样本,以避免模型过于关注极端情况。而由于在高维空间下, 因为高维空间中大部分体积都集中在高维球壳上,所以随机采样得到的点之间的距离往往非常接近,这也是不采用随机采样的策略的原因(Sampling Matters in Deep Embedding Learning)。
向量库是个什么东西
向量库不是“库”,但也是“库”;
考虑到传统关系型数据库, 数据以表格形式存储, 但在AI时代, 大量非结构化数据的存储和查询,以表格形式存在这不太合理了;因为数据维度高, 需要一些特殊的查询方式;
不同于传统数据库的精确匹配查询,向量库主要用于相似性搜索。这种搜索基于向量间的距离,通常使用欧几里得距离或余弦相似度。以暴力遍历的最近邻查询为例(Nearest neighbor search),假设我们有n个d维向量,查询复杂度为$O(nd)$。当n和d都很大时,这种方法变得非常耗时。
而近似最近邻搜索(Approximate Nearest Neighbor search, ANN)则能将时间复杂度降低到亚线性,通常为$O(log n)$或更优。
常见的ANN算法:
-
基于树的:k-D树(k-D tree):将空间递归地划分为子空间,适用于低维数据。
-
基于哈希的:局部敏感哈希(LSH, Locality-Sensitive Hashing):将相似的向量映射到相同的"桶"中。
-
乘积量化(Product Quantization):将高维向量分解为低维子向量,并对每个子向量进行量化。
-
基于Graph的:分层可导航小世界图(HNSW, Hierarchical Navigable Small World):构建多层图结构,在图上进行快速导航搜索。
而以上算法的思路都可以归介于—将相似的样本放在一起(减少搜索空间), 和构建高效的搜索结构。
参考
Build a search engine, not a vector DB
再谈大模型RAG问答中的三个现实问题:兼看RAG-Fusion多query融合策略、回答引文生成策略及相关数据集概述
[RAG] BGE M3-Embedding | 什么?我的RAG底座模型又要换了?
Utilizing BERT for Information Retrieval: Survey, Applications, Resources, and Challenges
ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT