写在开头
本文是基于最近组内技术交流的文字稿整理。
What is Agent?
在探讨复杂的人工智能技术之前,让我们先回顾一下生活中的一个简单例子:扫地机器人。这种智能设备在房间中自主导航,避开障碍物,寻找最有效的清洁路径。它就是一个现实生活中的Agent——一个可以自主决策和行动的实体。
在人工智能领域,Agent指的是任何可以感知其环境并根据感知结果做出决策的实体。这些决策旨在完成某些任务或达成特定的目标。Agent的行为可以简单如游戏里的机器人,也可以复杂如自动驾驶汽车。
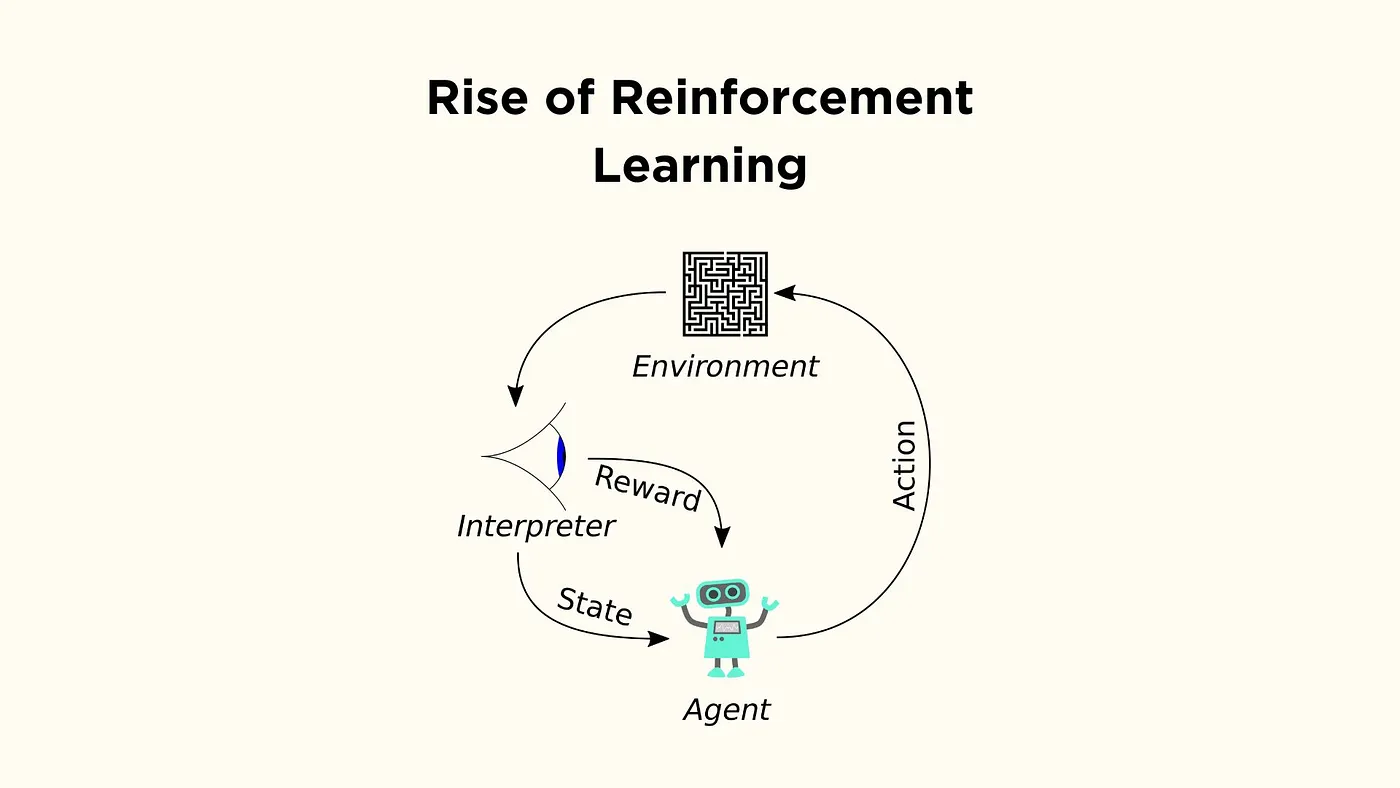
开始于强化学习
在强化学习中, 我们往往能见到agent的概念。强化学习是一种机器学习方法,它教导Agent通过试错法找到最佳行动路径。就像训练小狗一样,我们通过奖励来引导Agent做出正确的决策。Agent的目标是在与环境的交互中寻找最优策略。理想情况下,如果Agent能够获取足够多的真实环境数据,它就能找到最佳解决方案。然而,由于真实环境的复杂性,完全模拟真实世界是不现实的。
目前,强化学习主要适用于环境简单、问题定义明确的场景,如围棋或视频游戏。这种方法在虚拟环境中通过大量试错来探索解决方案,这种方法虽然有效,但缺乏灵活性和高效性。与人类学习新技能的方式相比,强化学习的效率远低。人们通常通过少量的尝试就能迅速掌握新技能,而强化学习可能需要成千上万次的试错。
这时候,如果agent具有大脑就好了。
将LLMs作为大脑: 赋能智能Agent的关键技术
相较于基于强化学习的Agent,人类的优势在于我们天生具备的记忆能力和逻辑判断能力,甚至包括反思和从经验中学习的能力。这些能力使得我们能够通过极少的试错迅速适应和掌握新技能。
语言模型(LLMs)为AI领域带来了革命性的变化。LLMs通过其深度学习的新范式,以及在思维链和自然语言理解方面的强大能力,预示着Agent将拥有更强大的学习和迁移能力。这种能力的提升将使得创建广泛应用且实用的Agent成为可能。
虽然LLM是否真正具备了推理能力仍然存疑,但LLM的出现无疑改变了很多。以COT(Chain of Thought)为例,这种模型通过打印解题的中间步骤,加强了在数学和逻辑推理方面的能力,减少了幻觉的出现。这一突破性的工作揭示了LLM在不同场景下的强大"in-context learning"能力,以及其在未经微调的情况下的泛化能力。
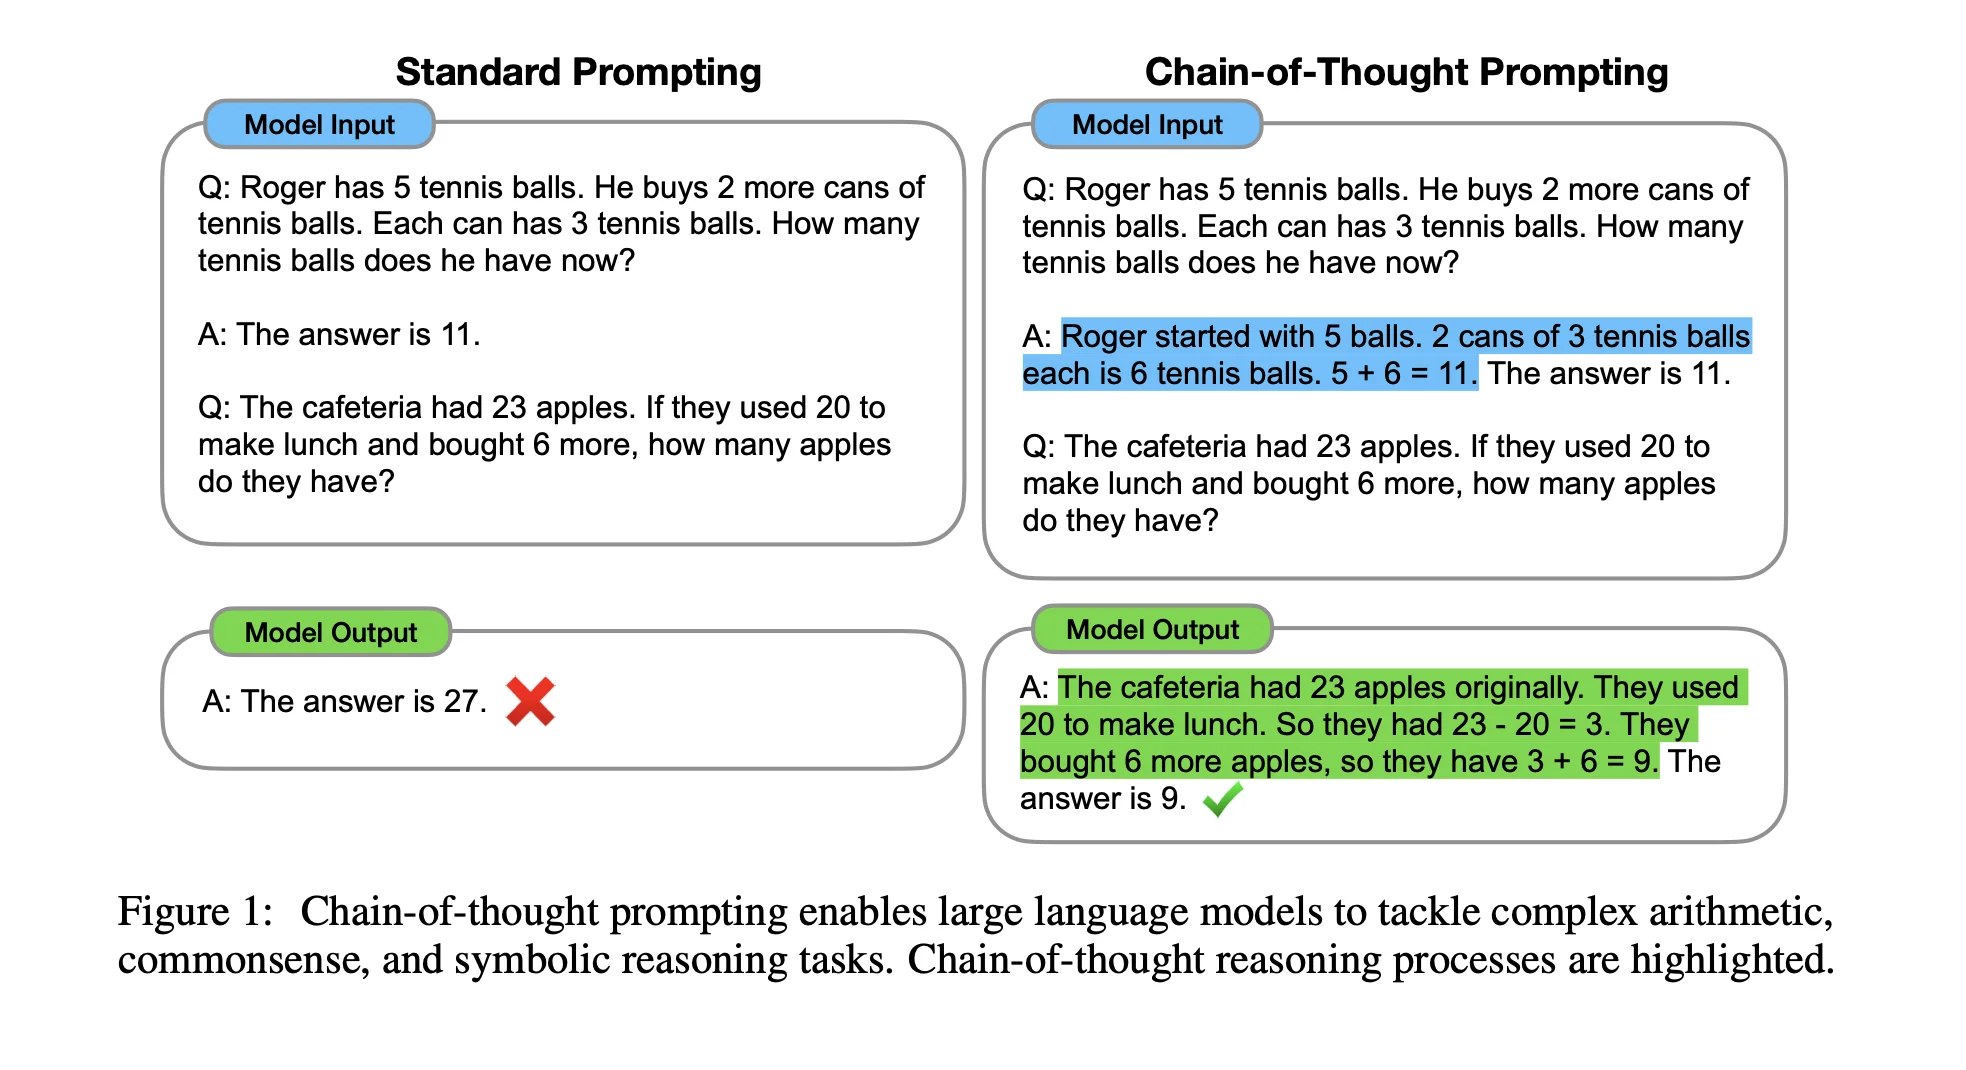
将LLM视为AI Agent的大脑,为自动化系统提供了一种全新的构思方式。这种基于LLM的agent系统综合了规划、记忆、工具使用和行动的能力,通过API调用与外部世界互动,显示出了前所未有的灵活性和效率。
根据LLM Powered Autonomous Agents一文对LLM-based agent系统的定义, agent需要具备的基本能力:规划+记忆+工具+行动。
规划能力:将复杂的任务分解成小任务, 并管理每一个子任务的目标, 并从过去的失败中反思,以吸取经验。
记忆:LLM的上下文长度有限, 通过额外的记忆系统以提升LLM作为大脑的能力。
工具调用&行动:LLM通过API调用的方式,执行任务, 与外界交互,而不是只是输出文字。
探索AI代理的独特能力:人类与单一LLM无法比拟
AI系统的主要优势在于它们的规模和效率。这些系统能够执行以下任务,超越人类能力:
-
大规模数据处理:AI能够高效地分析和处理超出人类理解范围的数据量。
-
无需休息的持续操作:AI系统可以不间断地运行,而无需像人类那样休息和恢复。
-
超快速计算:AI可以迅速执行复杂的计算,处理速度和效率远超人类。
AI代理与单一LLM的不同:
根据Andrew Ng在讲座中分享的内容,使用相对“简单”模型的代理工作流程(例如GPT-3.5)在实际应用中往往能够超越使用“智能”模型(如GPT-4)的零次提示。这说明在特定场景下,选择适当的AI模型和策略可能比单一的高级模型更有效。
AI代理在决策制定中的应用也显示出其独特的优势。它们可以在没有情感偏见的情况下,基于大量数据做出快速且精确的决策。这种能力在需要快速响应和高精确度的领域尤为重要,如金融交易和紧急响应系统。
Agent的规划和思维过程
AI Agent在处理复杂任务时,通过将大任务分解成小任务来提高效率。此外,自我反思能力允许Agent从过去的行动中学习,通过评估过去的决策来改善未来的表现。
CoT,Chain of Thought, Wei et al. 2022。 即“思维链”,是一种使Agent逐步思考的方法。它通过要求模型展示解决问题的中间步骤来加强其逻辑推理能力,从而提高决策的质量和准确性。
Tree of Thoughts, ToT (Yao et al. 2023)
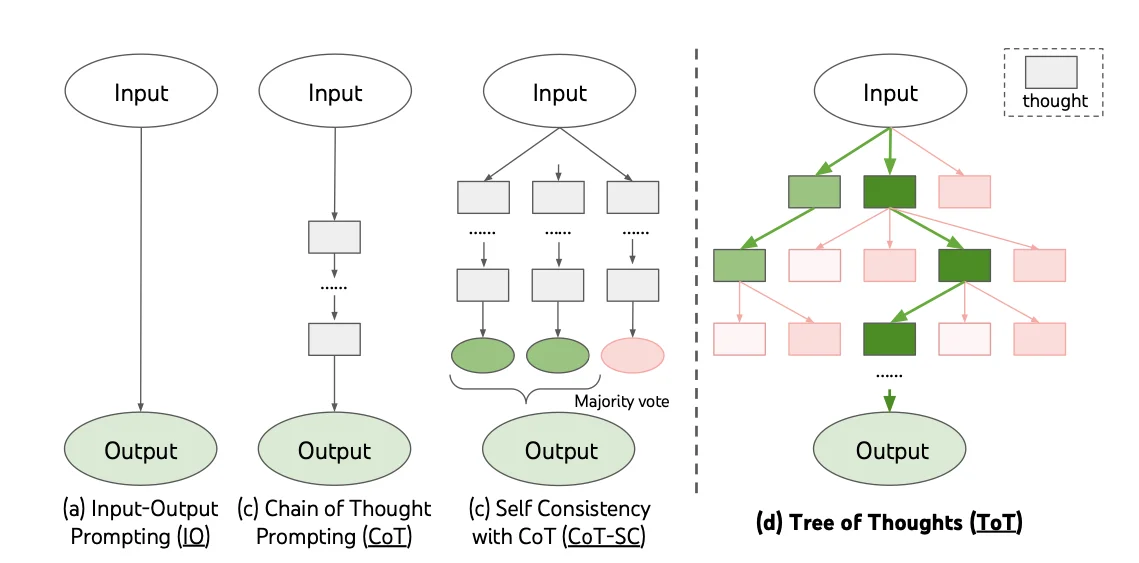
尽管语言模型在许多领域表现出色,但在需要复杂规划和全局决策的任务上,它们的能力受到了限制。ToT框架应运而生,旨在通过一个结构化的思考和评估过程来弥补这一缺陷。
ToT框架借鉴了人类心理学中的双系统决策理论,通过整合快速直觉判断和慢速深思熟虑的决策过程,极大地提升了模型的决策能力。这一框架通过自我评估的方式,允许模型在面对多种可能的决策路径时,能够进行有效的选择和全局优化。
ToT框架旨在克服现有语言模型在处理需要复杂规划或搜索任务的局限。它通过结构化的思想树来探索和评估不同的决策路径。ToT允许模型在考虑多个推理路径时自我评估其选择,以做出最佳的决策。此外,ToT结合了语言生成和搜索算法(如BFS和DFS),使模型能够在进行决策时前瞻和回溯,以实现全局最优选择。
prompt example:
cot_prompt = '''
Write a coherent passage of 4 short paragraphs. The end sentence of each paragraph must be: {input}

Make a plan then write. Your output should be of the following format:

Plan:
Your plan here.

Passage:
Your passage here.
'''

vote_prompt = '''Given an instruction and several choices, decide which choice is most promising. Analyze each choice in detail, then conclude in the last line "The best choice is {s}", where s the integer id of the choice.
'''

compare_prompt = '''Briefly analyze the coherency of the following two passages. Conclude in the last line "The more coherent passage is 1", "The more coherent passage is 2", or "The two passages are similarly coherent".
'''

score_prompt = '''Analyze the following passage, then at the last line conclude "Thus the coherency score is {s}", where s is an integer from 1 to 10.
'''
GoT, Graph of Thoughts,
https://arxiv.org/abs/2308.09687
https://arxiv.org/abs/2401.14295
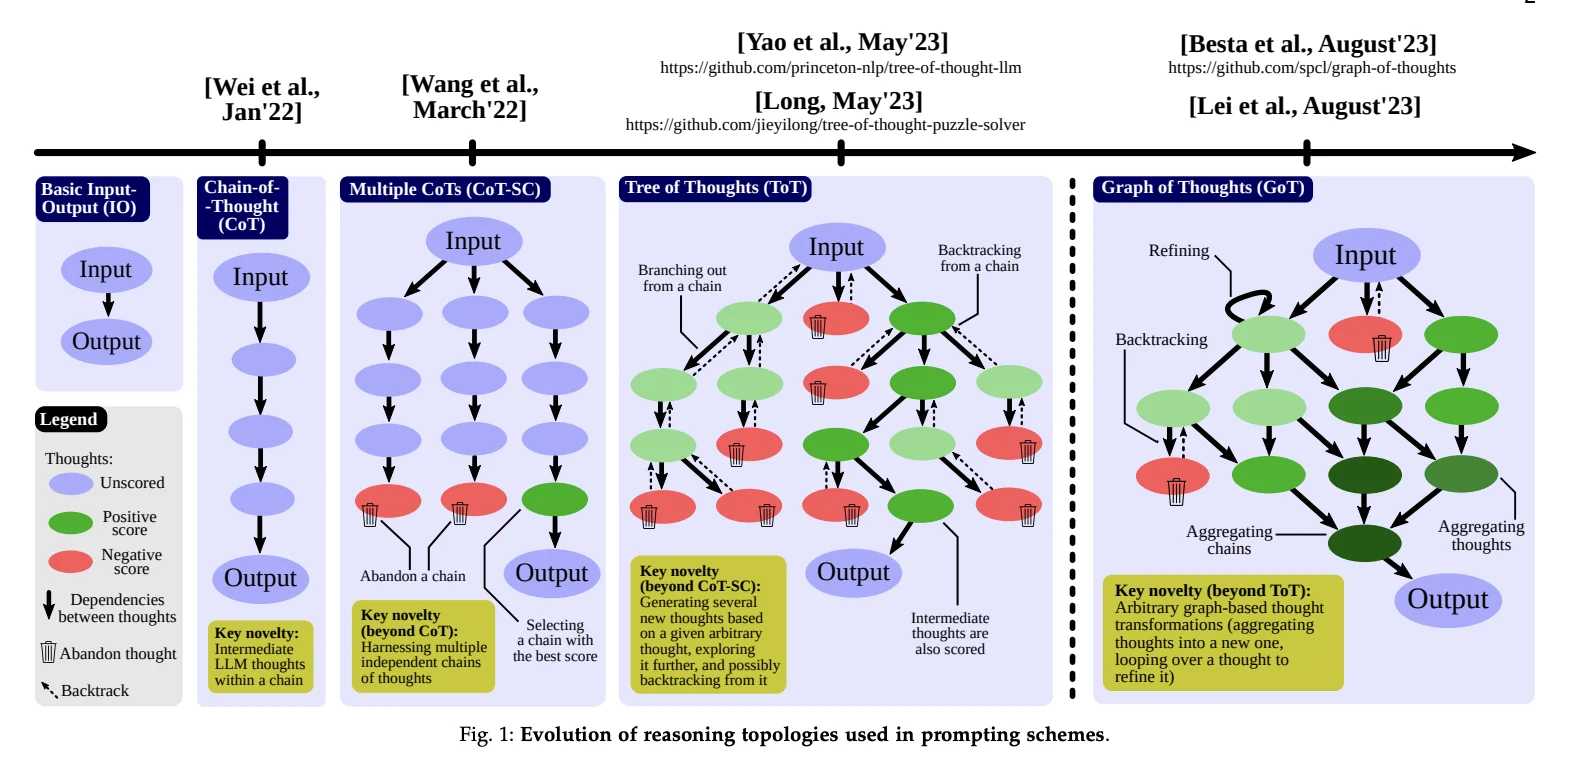
GoT(Graph of Thoughts)是在ToT(Tree of Thoughts)基础上的一种进阶,它通过引入图状结构,增强了模型处理复杂推理任务的能力。这种结构允许在生成的思考中进行更为灵活的图状转换,如合并多个思考或在思考间进行循环。
GoT的核心特点在于其灵活的图状结构,这使得它能够通过合并和循环不同的思考节点来模拟更复杂的推理过程。每个思考节点可以从多个父节点聚合信息,也可以向多个子节点扩展,形成一个密集的思考网络。这种结构特别适合处理那些传统树状模型难以解决的复杂推理和决策任务。
GoT设计之初就为了处理比ToT更为复杂的推理任务。通过允许广泛的依赖关系和中间步骤的聚合,GoT能够更有效地解决那些需要非线性思考路径的问题。例如,在处理涉及多个相互关联子问题的任务时,GoT的图状结构提供了一种比传统线性或树状结构更为有效的解决方案。
XoT, Everything of Thoughts, https://arxiv.org/abs/2311.04254
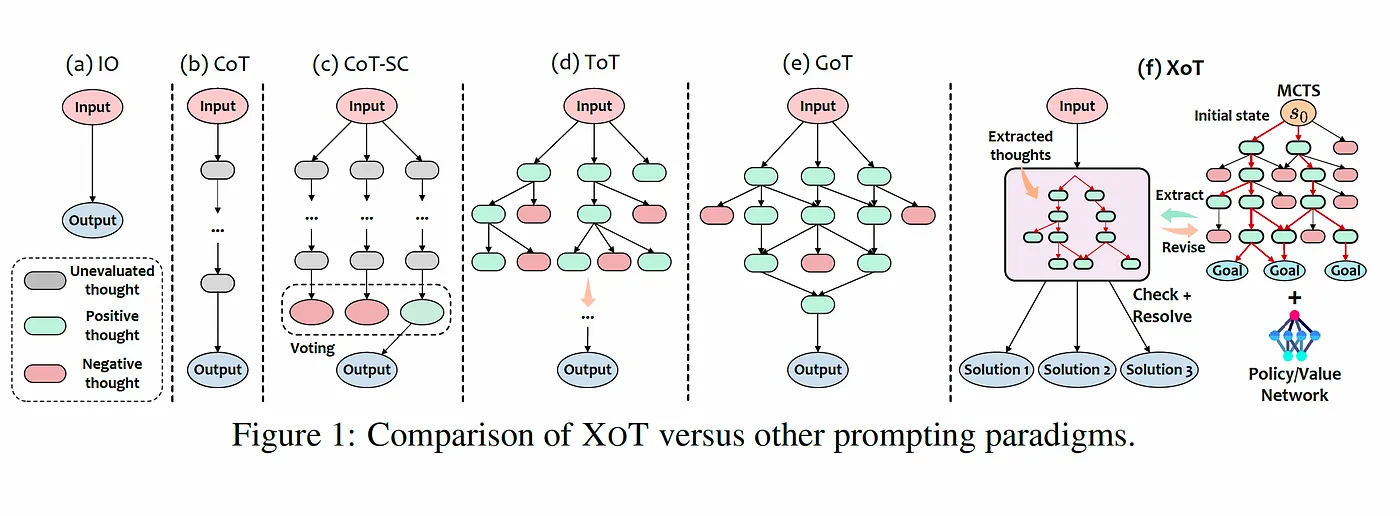
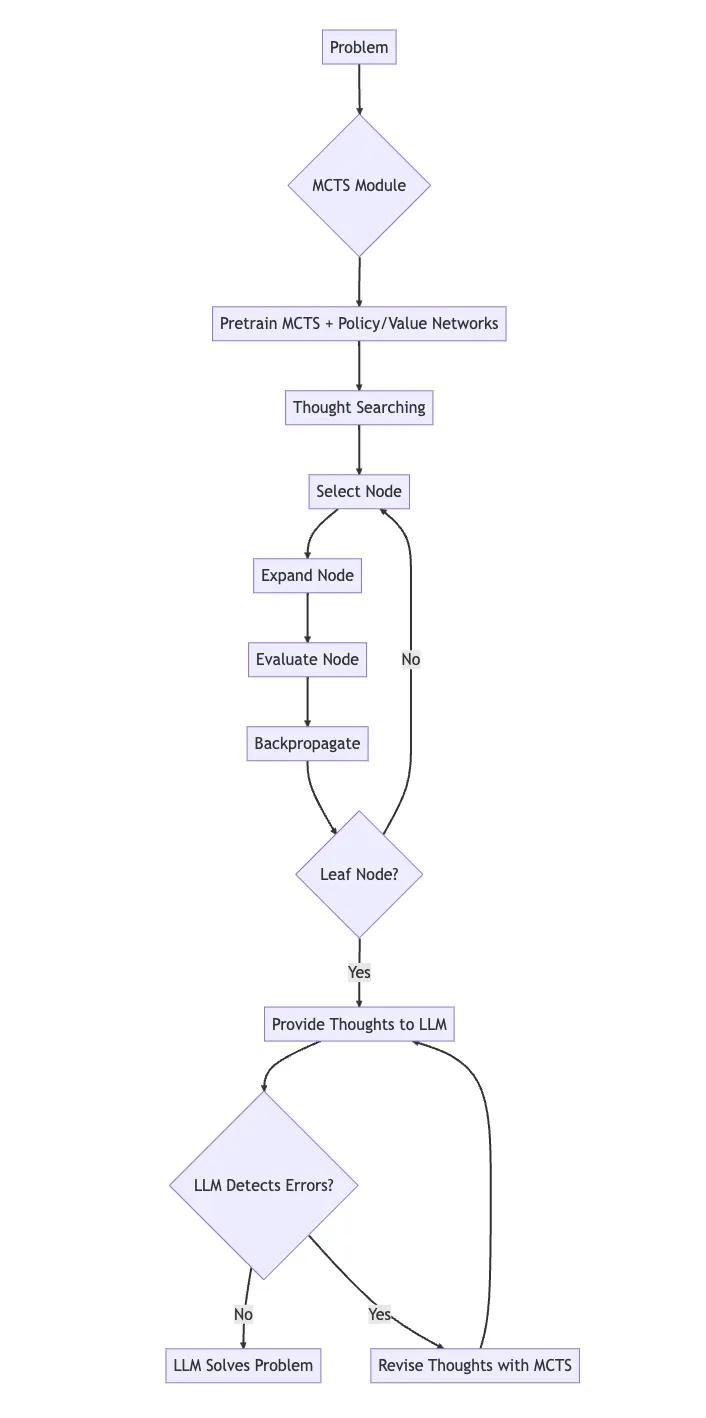
XoT代表了在AI领域中对复杂思考和决策过程的一次显著革新,它通过结合蒙特卡洛树搜索(MCTS)和大型语言模型求解器(LLM solver)来优化决策路径。
XoT框架包含以下几个关键步骤和组件:
-
预训练的MCTS模块:该模块通过在特定任务上的预训练,获得了有效导航复杂思考路径的能力。
-
动态思考搜索:在实际应用中,MCTS模块继续利用其策略和价值网络来探索和优化潜在的思考轨迹。
-
思考修正与优化:LLM评估并修正MCTS的输出,确保思考路径的逻辑严密性和有效性。
-
决策执行:修正后的思考路径被送回LLM,用于解决具体的问题和挑战。
ReAct (Reason to Act) 是由 Yao et al. 2023 提出的一种新颖的提示框架,旨在通过交错的思考、行动和观察步骤,提高大型语言模型(LLM)的动态推理和计划调整能力。
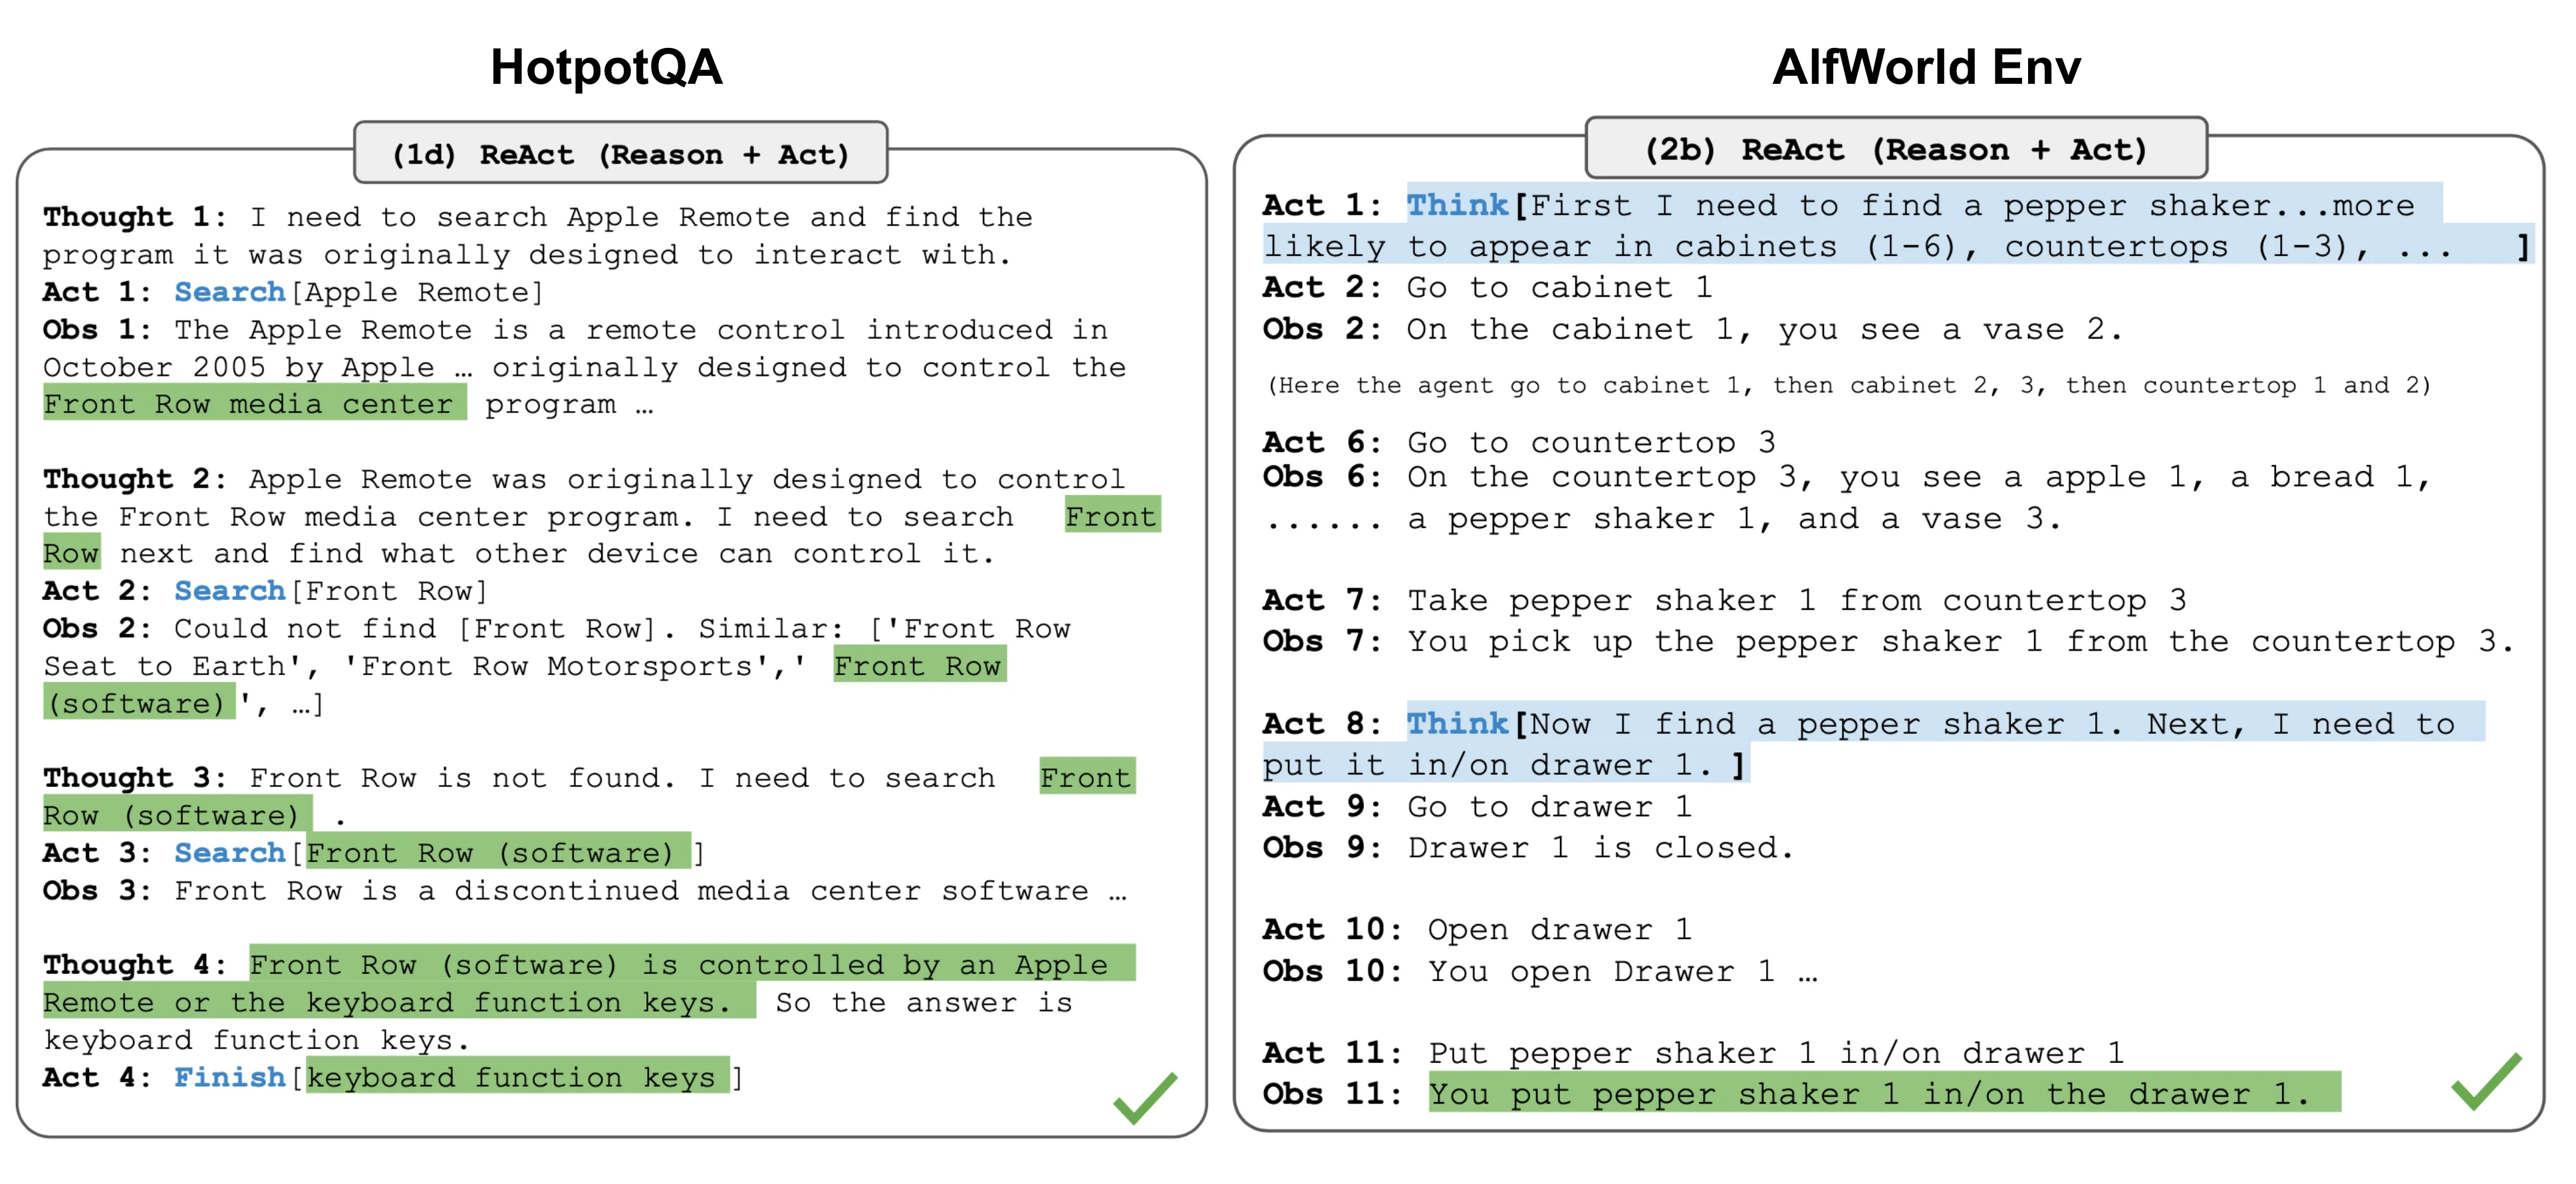
ReAct通过“思考-行动-观察”结构,使LLM能够生成口头推理迹线和与任务相关的行动。这种结构允许模型动态地创建、维护并调整高层次的行动计划,同时与外部环境(如Wikipedia)互动,引入额外信息以丰富推理。
ReAct的独特特点
-
直观且易于设计:ReAct的设计直观,易于实现,并能快速适应不同的应用场景。
-
通用性与灵活性:适用于多种任务,能够灵活处理复杂的情境。
-
高性能与鲁棒性:提供稳定且有效的推理输出。
-
与人类行为一致且可控:增强了模型的可控性,与人类的推理和行动方式更为一致。
ReAct与CoT的对比
相对于CoT(Chain of Thought),ReAct通过交错的思考、行动和观察步骤,改进了模型的根据性和可信度。然而,这种结构在提高模型实地操作的同时,也略微降低了在推理步骤制定的灵活性。此外,ReAct的有效性很大程度上依赖于成功检索到信息丰富的知识。
Thought: ...
Action: ...
Observation: ...
... (Repeated many times)
Reflexion是由Shinn & Labash 2023提出的一种创新的决策支持框架。它包括三个核心模块:Actor(行动模块)、Evaluator(评估模块)、和Self-Reflection(自我反思模块),旨在通过增强的语言模型反馈机制提升任务处理效率和质量。
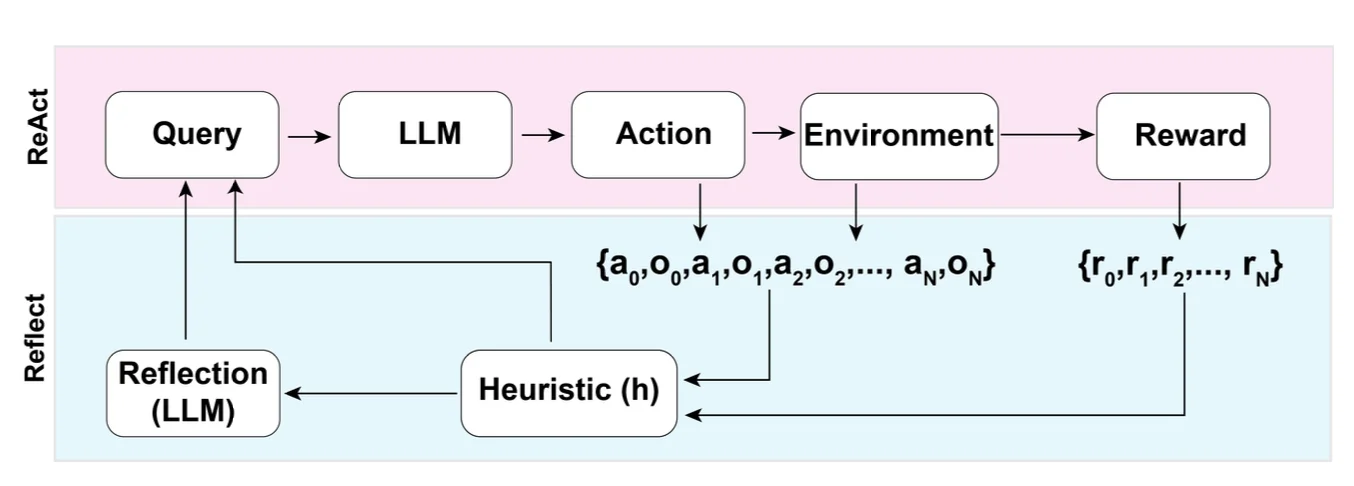
框架组成与工作机制
-
Actor模块:负责生成针对特定任务的行动指令和文本。
-
Evaluator模块:评估Actor的输出,保证行动的适宜性和效果。
-
Self-Reflection模块:反馈生成部分,通过深入分析和总结Actor的表现,指导未来的改进。
Reflexion框架的轻量级设计和对详细反馈的处理能力使其在多个高级任务中表现优异,包括编程、推理和复杂决策。实际应用显示,该框架能显著提升任务处理的正确率和效率。
思考的快与慢。 在《思考,快与慢》一书中,丹尼尔·卡尼曼提出了人类思考的两种模式:“系统1”和“系统2”。系统1是快速、本能和情感性的,而系统2则更为缓慢、深思熟虑和逻辑性。这两种系统在处理不同类型的记忆和决策时发挥着不同的作用。
Agent记忆
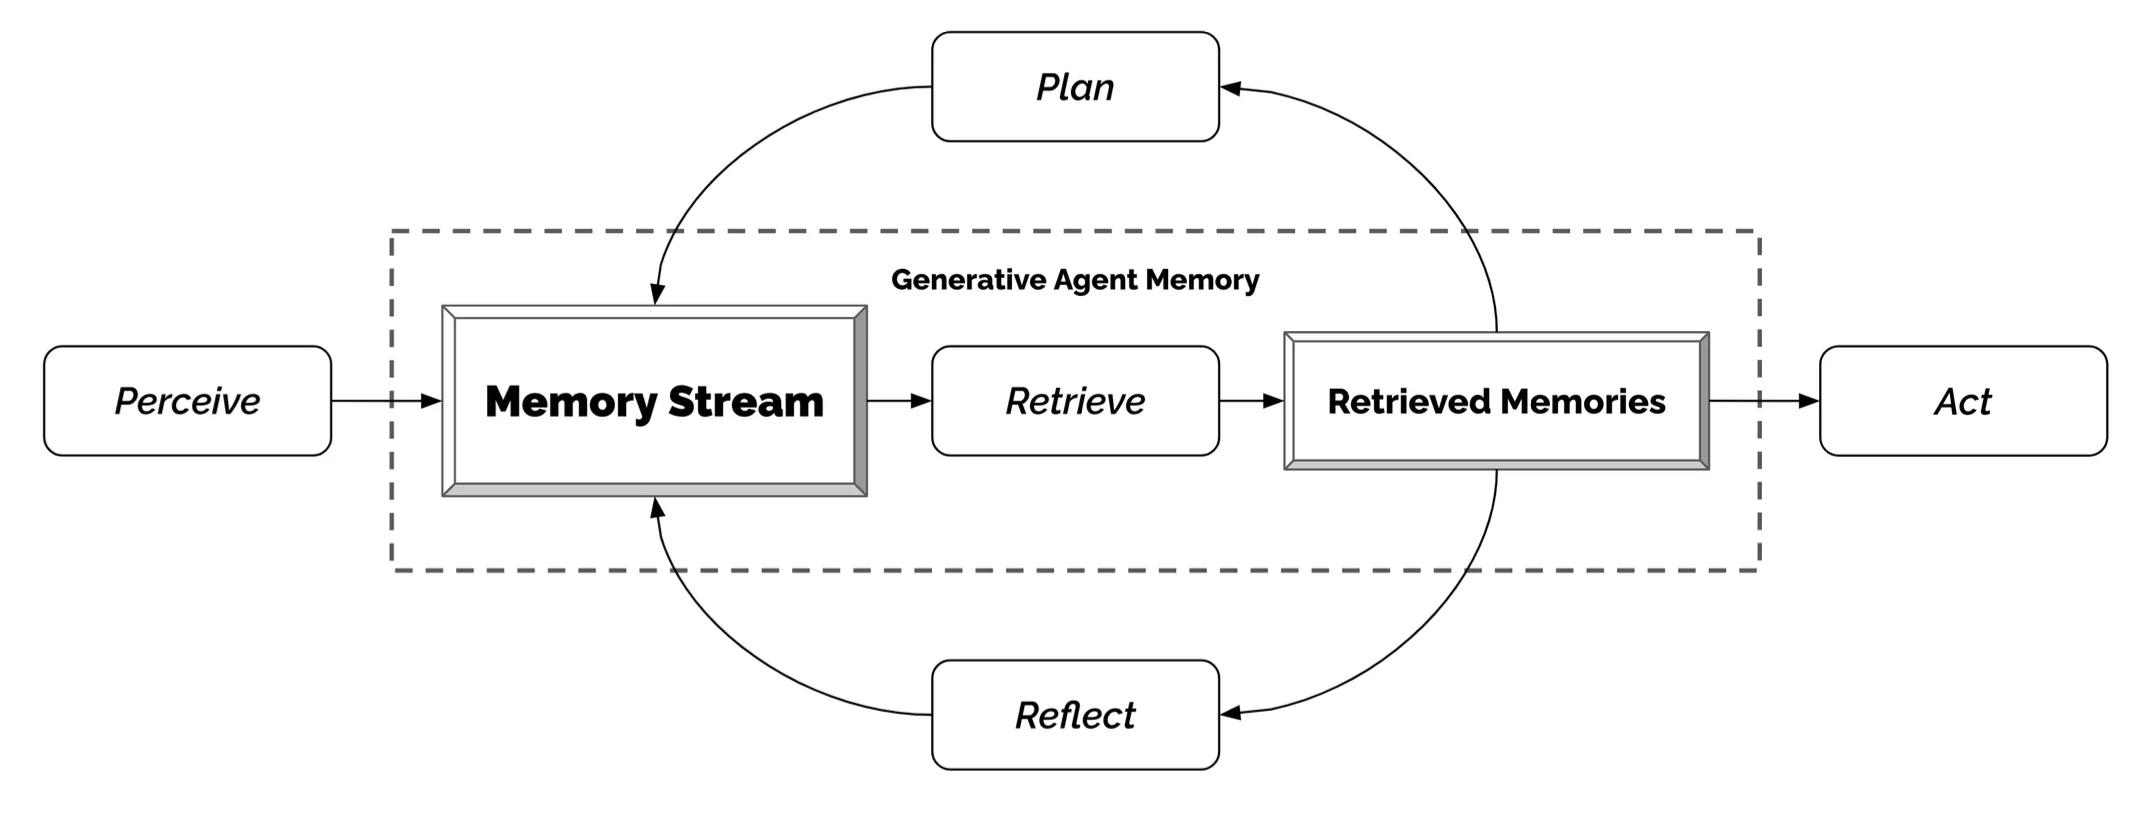
记忆是人类认知功能的核心,使我们能够从经验中学习并避免重复错误。在人工智能领域,尤其是在开发智能代理(Agent)时,构建有效的记忆系统也显得尤为重要。
AI系统,尤其是依赖于大型语言模型的Agent,常面临有限的上下文记忆容量问题。这限制了它们在处理持续对话和复杂任务中的表现。这些系统通常受到有限上下文长度的制约,这限制了它们在处理连续对话或复杂任务时的效率。例如,一个没有有效记忆机制的Agent可能会重复犯同样的错误,或者忘记初始的任务目标。
尽管现代LLMs的上下文长度已经可以处理超过100,000个标记,试图将所有对话历史和相关记忆直接置于模型的上下文中既不经济也不高效。因此,开发一个专门的记忆系统,如检索增强生成(Retrieval-Augmented Generation, RAG)成为提升Agent性能的有效手段。
如果要为AI构建高效的记忆系统,借鉴和参考人类的记忆系统是必不可少的。人类的记忆系统包含多种类型的记忆,每种记忆都有其独特的生物学基础和功能,这些记忆类型不仅支持我们的日常活动,还是我们进行复杂决策和学习的基础。
通过了解人类记忆的工作原理,我们可以设计出能够更好地模拟人类认知过程的AI系统。这不仅可以提高机器的任务执行能力,还可以使机器更加自主地适应复杂的环境和需求。
根据维基百科的定义,人类的记忆系统可细分成:
-
工作记忆:支持我们处理日常任务和进行决策。
-
工具记忆:帮助我们形成习惯和自动化反应。
-
语义记忆:允许我们累积知识和理解世界。
-
情节记忆:使我们能够回忆过去的经历和事件。
-
动作记忆:通过练习改善我们的物理技能和运动。
遗忘的机制和认知卸载。记忆的形成经历过滤、压缩、遗忘和重组等环节。在这个过程中,大脑会删除大部分接收到的信息,只保留对当前活动或未来决策最关键的部分。
建议阅读:
A Survey on the Memory Mechanism of Large Language Model based Agents
Agent的工具调用
我们更希望能帮助我们干活的agent 而不是一个只会说话的LLMs。换句话说人实际上并不需要一个聊天的对象,而是帮助解决问题的助手
如何让LLMs具备工具调用的能力。 根据当前的主要工作, 主要是以openAI 的tool-using 的工作为主(也就是之前的function calling)。
一句话解释:function calling从本质上并不是严格的工具调用, 而是作为工具调用的前奏,它通过更加结构化的方式指导LLM输出,为在本地执行具体函数提供了参数,铺平了道路。
具体来说,function calling允许LLM在执行过程中通过指定的参数来调用并执行一个特定的函数。这种方式不仅实现了代码的重用和模块化处理,而且能够从模型中获取更可靠的结构化数据回应。在API调用过程中,开发者可以描述想要执行的功能,并让模型智能地选择输出包含所需参数的JSON对象。这个过程中,Chat Completions API本身不直接执行任何函数调用,而是生成了可以在开发者代码中实现函数调用的JSON。
更详细的tool-using内容,可以查看之前的博文:Agent学习笔记:OpenAI Function Calling完全指南
除了tool-using意外, 比较重要的工具还有:code interpreter, 在代码开发的场景下, code interpreter充当了RL中的Env角色,让agent能够根据环境的反馈做出对应决策,而不只是生成代码。 除了openAI所提供的code interpreter外, 还有一些开源的code interpreter,如Open Interpreter 可以使用。
从单Agent到多agent协作
来自斯坦福的虚拟小镇,因其独特的话题性而被广泛讨论。
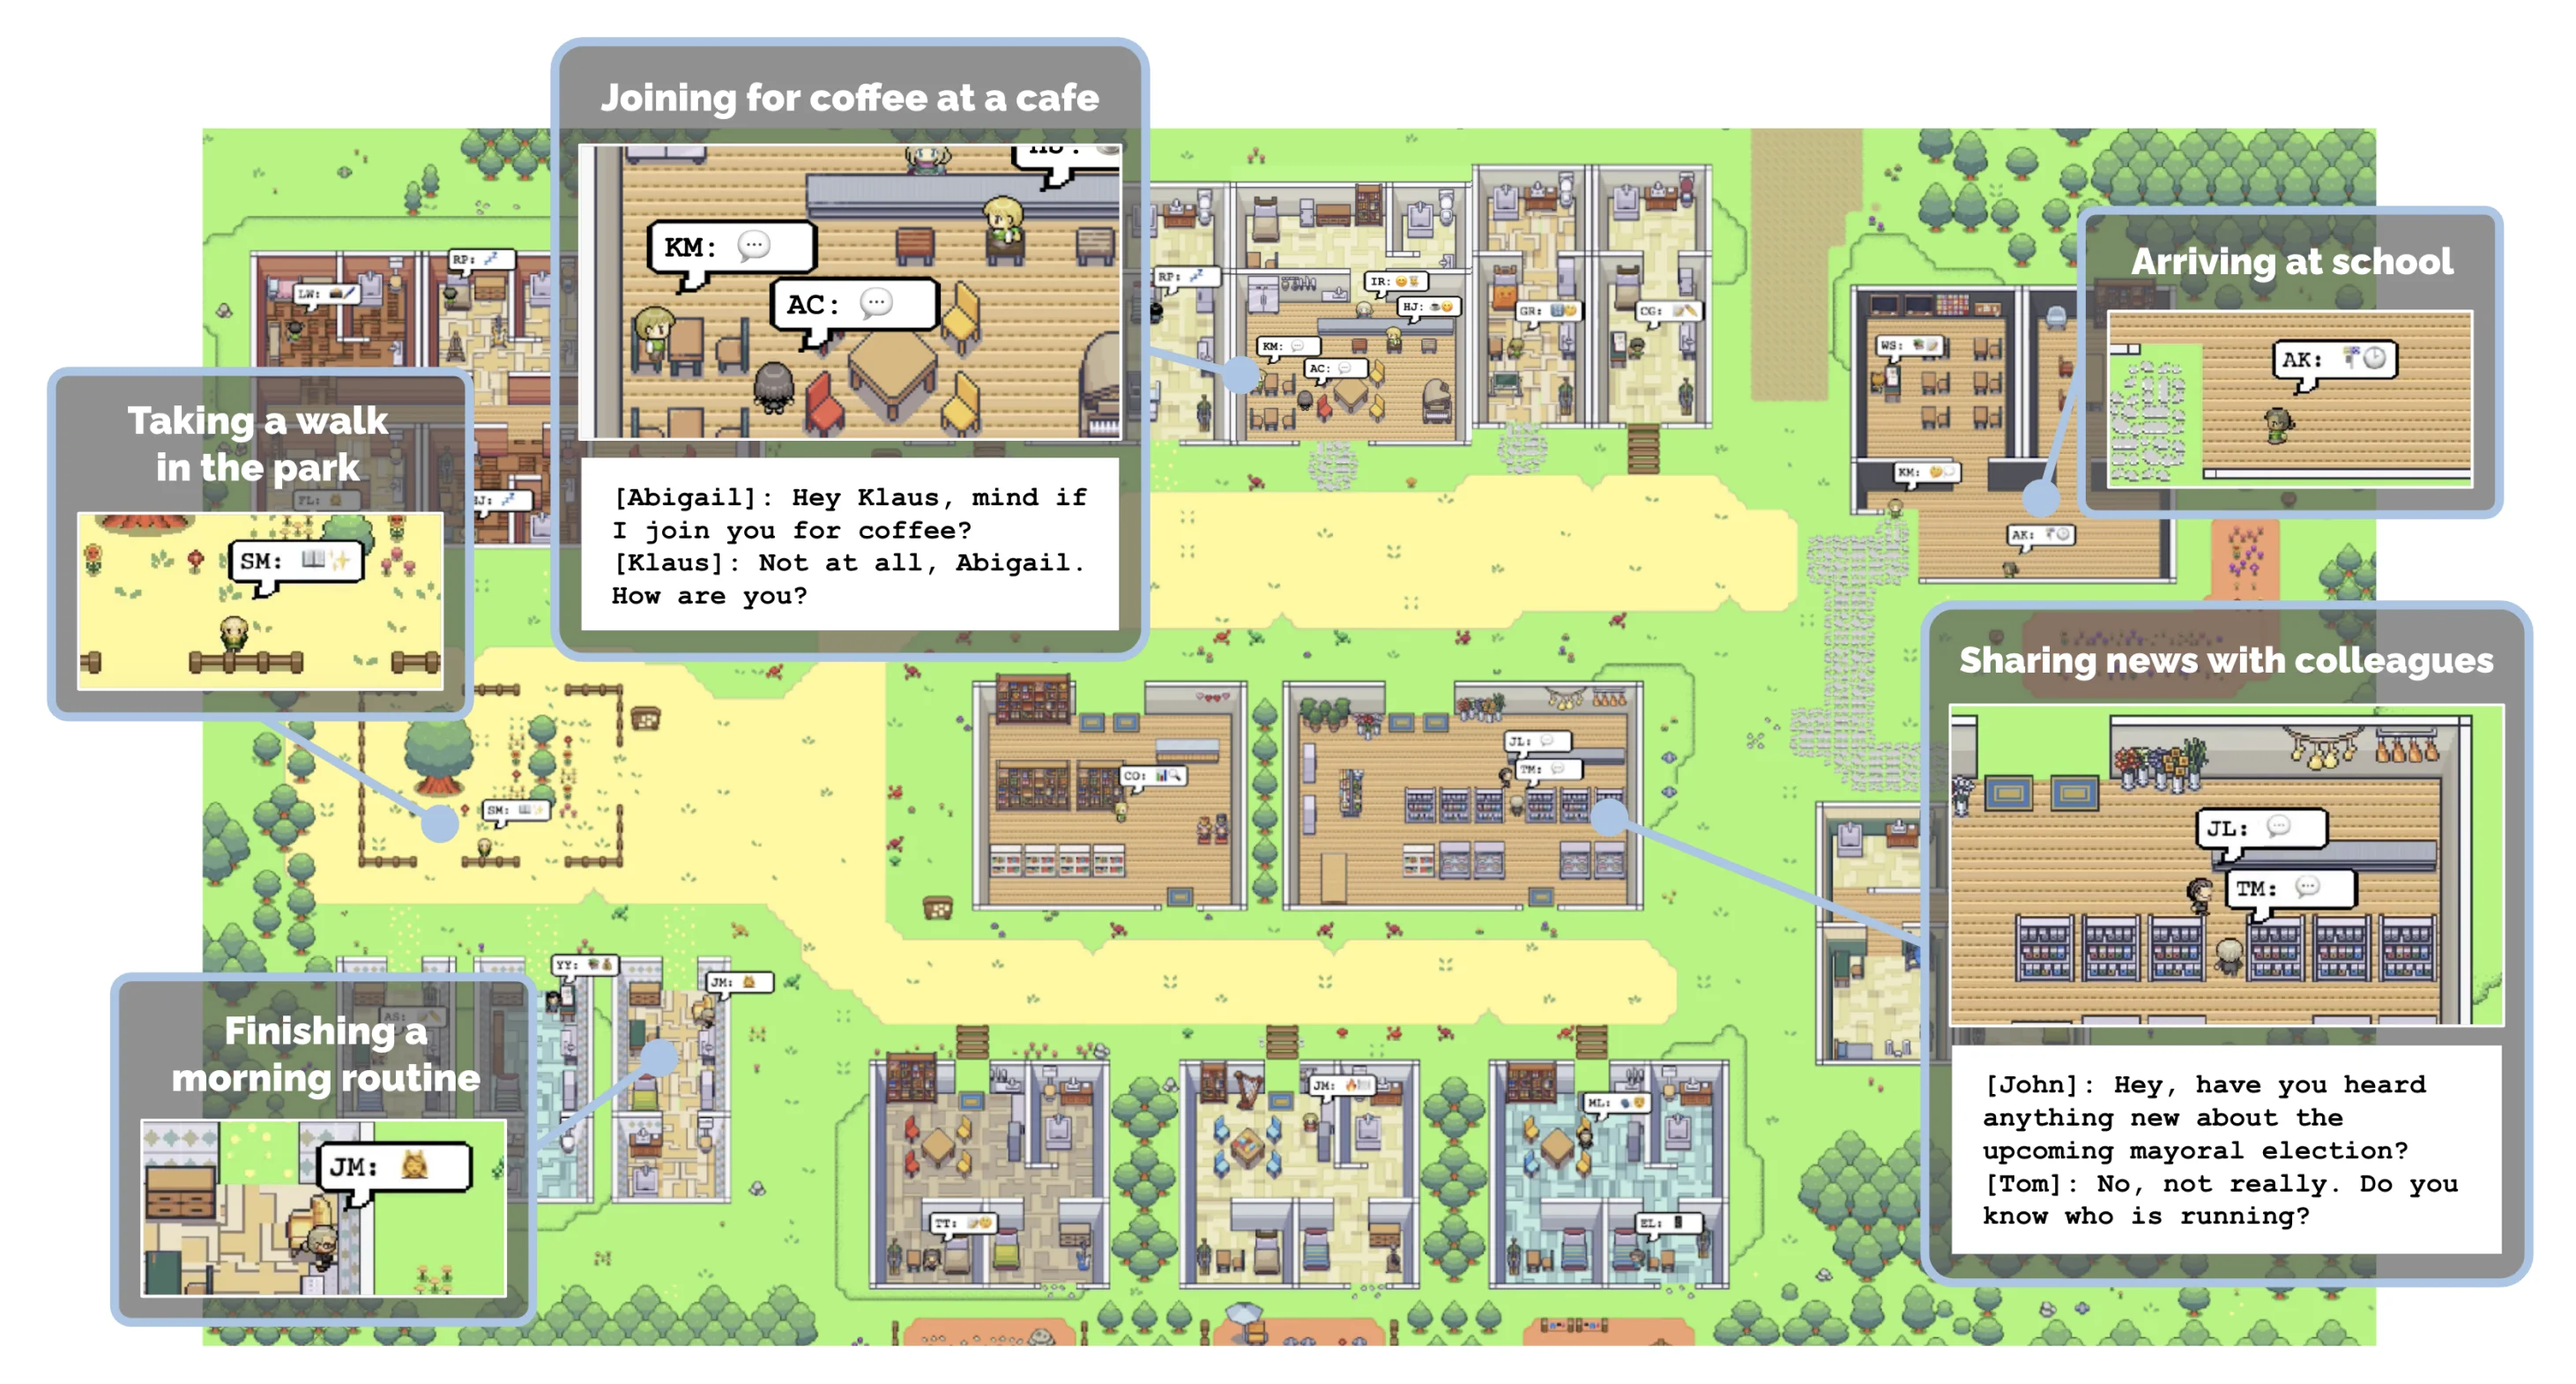
Generative Agents: Interactive Simulacra of Human Behavior
MetaGPT
在MetaGPT看来,可以将智能体想象成环境中的数字人,其中
智能体 = 大语言模型(LLM) + 观察 + 思考 + 行动 + 记忆
多智能体系统可以视为一个智能体社会,其中
多智能体 = 智能体 + 环境 + 标准流程(SOP) + 通信 + 经济
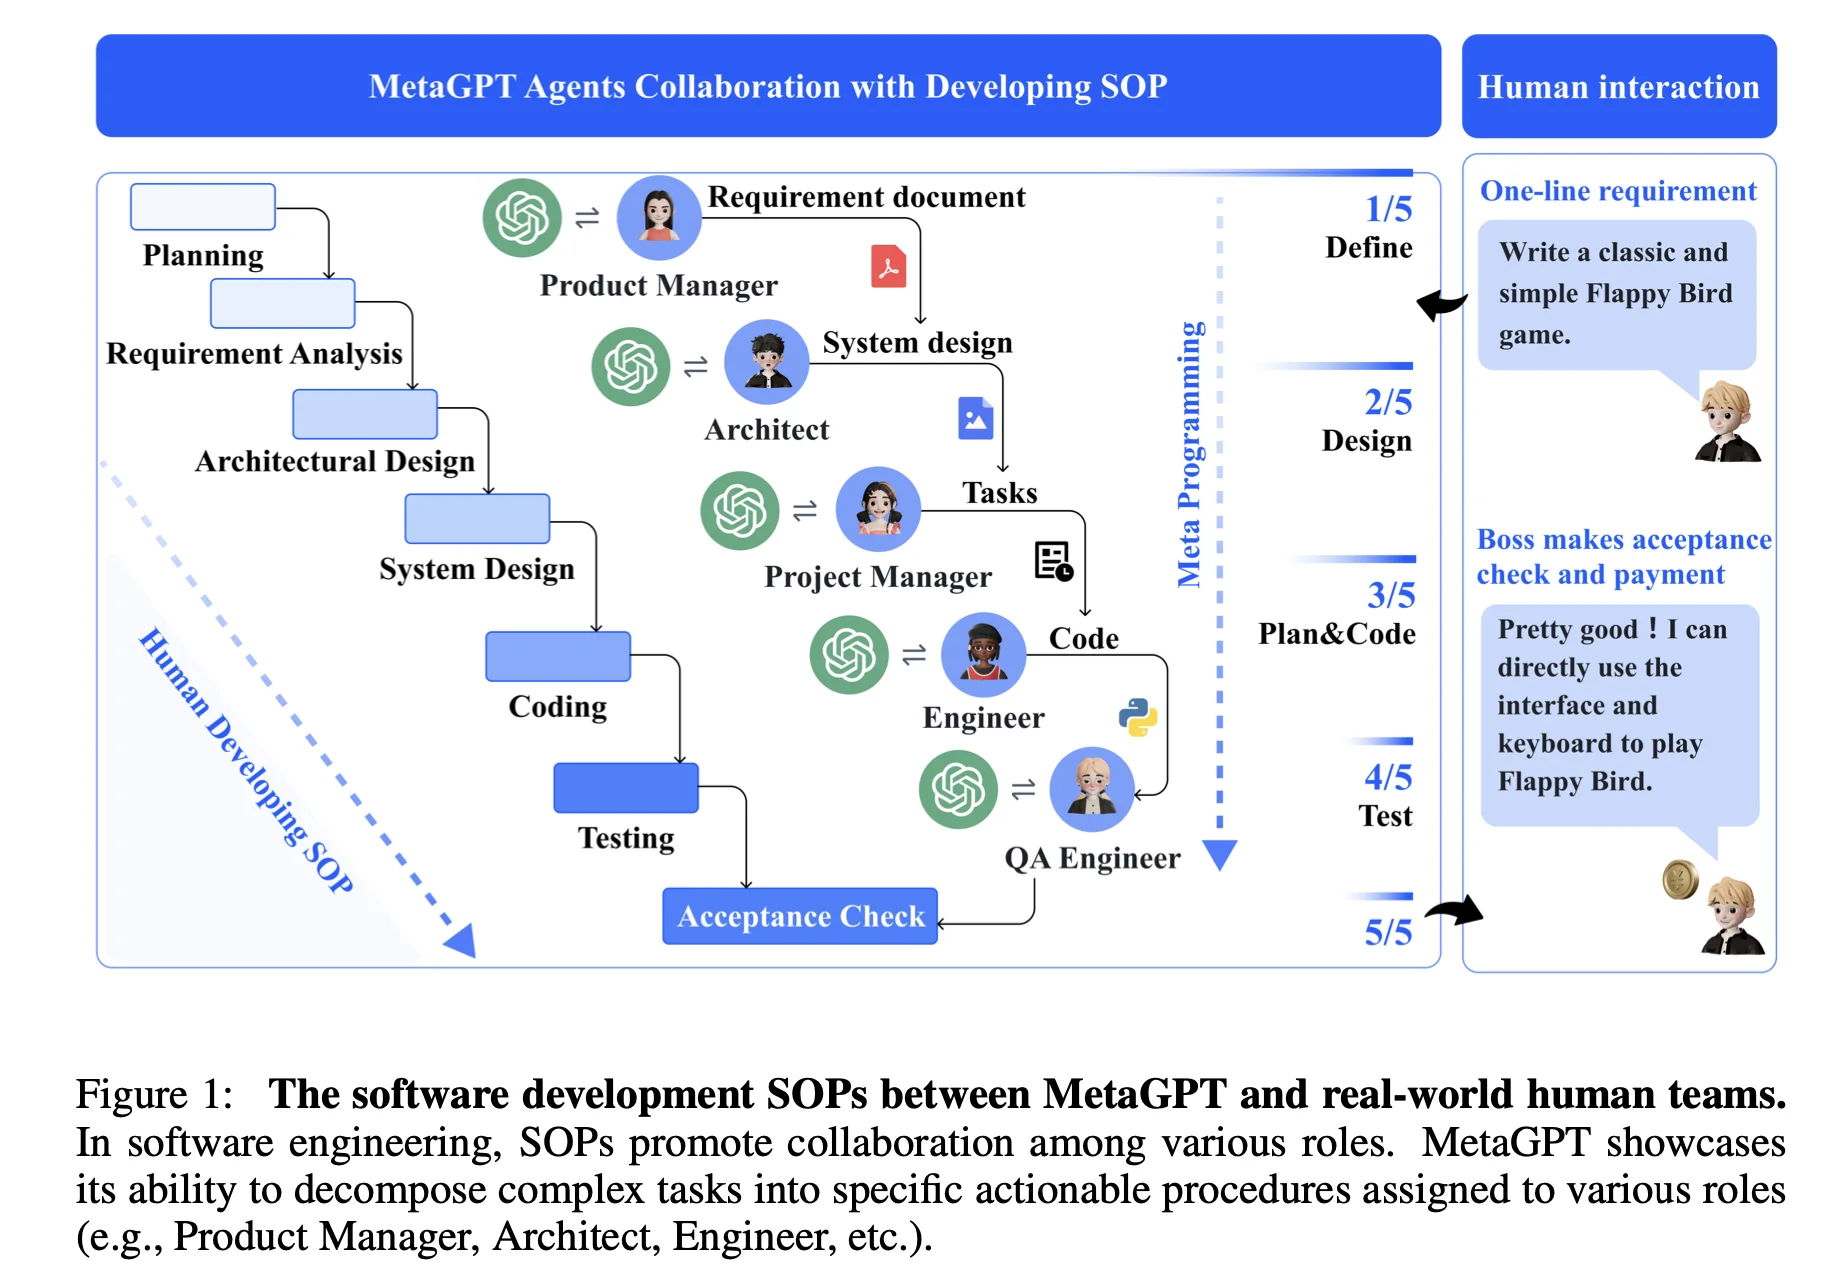
Code = SOP(Team)是核心哲学。我们将SOP具象化,并且用于LLM构成的团队
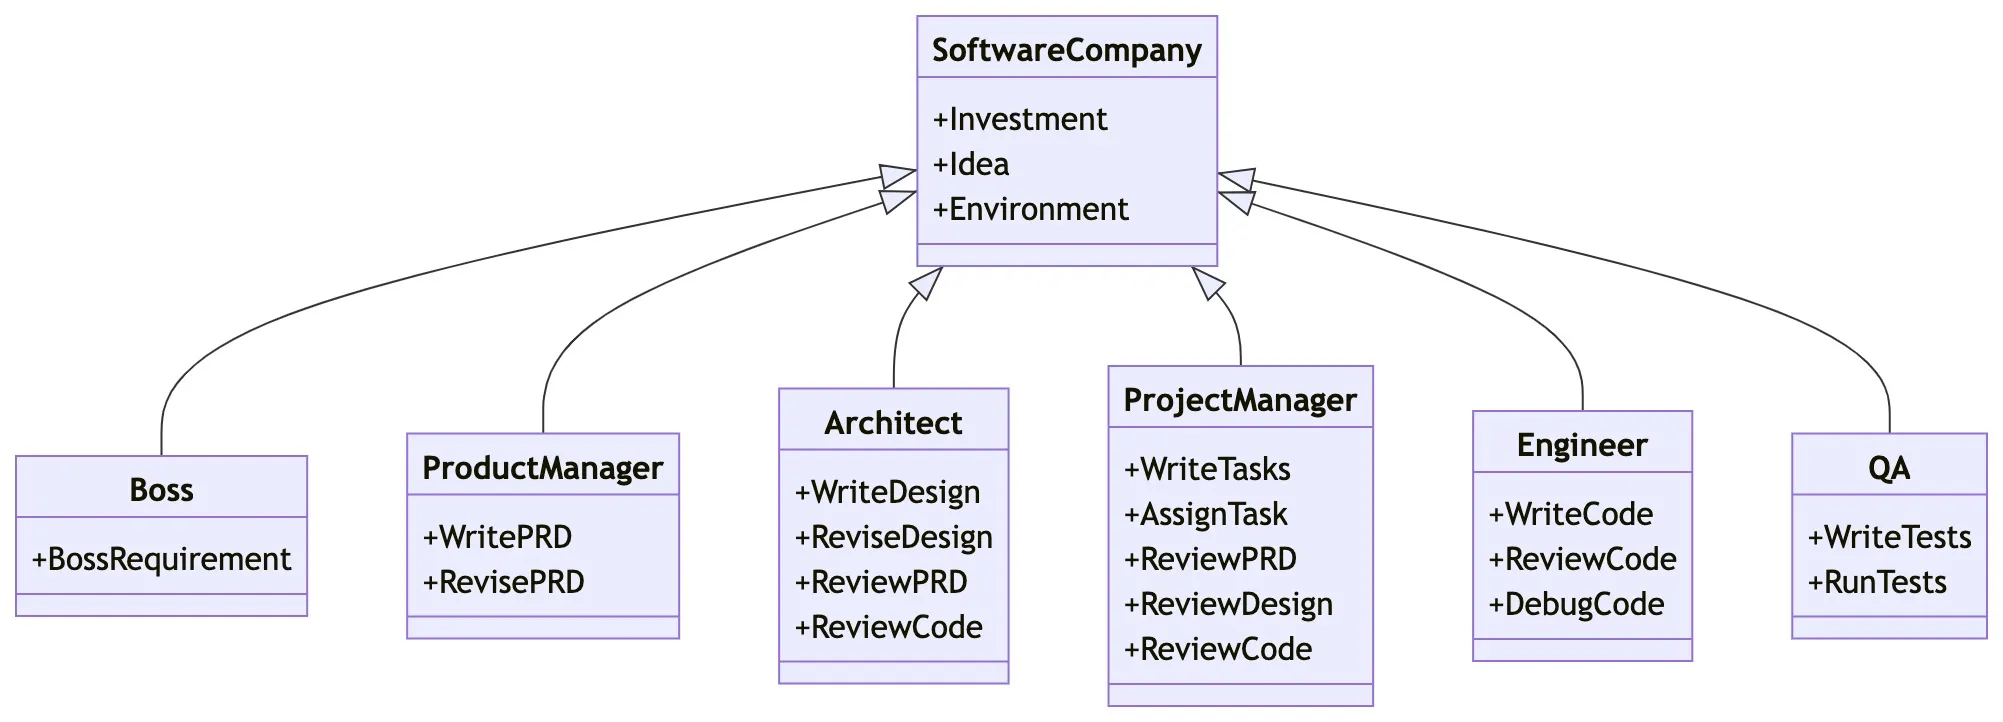
一些讨论
LLMs真的具备逻辑推理能力吗
何为推理(reasoning):是对信息进行处理和推断,形成判断或结论的过程;**推理通常是一个包含多个推断步骤的过程。推理通常被认为需要抽象思维——也就是说,推理的能力不局限于具体的例子,而是更为普遍的。**LLMs的推理能力似乎是”涌现“的结果,而非专门针对性训练,所以LLMs是否真正具备推理能力?从一些结果表明,LLMs似乎是在背答案而非真正的推理。
在 Can Large Language Models Reason? 这篇文章中作者认为CoT过程中LLM可能是在背答案:
GPT-4 solved 10 out of 10 problems that had been published before 2021 (GPT-4’s pre-training cutoff date) and zero out of 10 problems that had been published after 2021.
不过,我还是持保留意见的, 作者所观察到的现象和人类很像,更擅长在自己熟悉的领域,因为存在大量的记忆,记忆间存在大量“近道”(shortcut)用于加速推导过程,甚至直接给出答案;所要做的让LLMs去执行“慢思考”而不是“快思考”。
如果从transformer 的原理上讨论, 一个自回归的模型本身是和推理,逻辑甚至是智能无缘的。
但人类的语言中, 天生具备了逻辑,或者人类的语言中融入的人类本身的逻辑。那么通过模拟语言的生成,一定程度也能恢复出语言背后的逻辑。
Agent真的只是商业上的吹捧或者泡沫吗
泡沫的成份一定是有点。但也是未来十年值得做的东西。
如果把LLM类比成CPU的话, 一个完整的计算机系统,除了CPU以外, 还需要内存,控制,输入输出等组件。不可能让LLM实现所有功能,这并不现实。但通过一定合理的架构,工作流的编排,能够大大提升LLM的准确性,进而加快落地实现。
传统行业要如何在agent上发力
所有公司都有SOP,和大量存在在员工脑子中的“隐性知识”。 这些“知识”只有转换成agent的工作流(思维方式),或者是LLM的system prompt,才会变得更有价值和意义。现阶段有很多公司在做所谓的知识管理, 本质上是用公司的内部文本作为RAG系统而已,但一个问答系统很难量化出收益,并且对于使用者的要求挺高的。 实际上我认为,发力点应该是将内部人类可使用的工具逐渐API化,标准化以方便agent的工具调用,然后定义智能代理在各种业务场景中的具体任务和行动。这包括从简单的数据检索到复杂的决策制定
Agent应该从事简单重复劳动还是具有创造性的探索工作
这题让GPT-4来回答吧:
关于“Agent应该从事简单重复劳动还是具有创造性的探索工作”的问题,我们可以从多个角度进行分析:
经济效益:从经济角度考虑,如果简单重复的劳动可以被自动化或由机器人执行,这将大幅度降低成本,并提高效率。企业通常会选择自动化这类工作以减少人力成本。然而,对于创造性的探索工作,由于需要不断地创新和解决新问题,这种类型的工作更可能需要人类智能的参与,因此,这种工作对于推动技术进步和经济增长具有重要价值。
技术发展:随着AI和机器学习技术的发展,越来越多的简单劳动可以被智能系统所取代。例如,数据输入、监控等任务已被自动化系统广泛接管。然而,对于需要高度创造性和判断力的工作,如科学研究、艺术创作、复杂决策制定等,目前的技术还无法完全替代人类。
人类福祉:从心理学的角度来看,长期从事简单重复的劳动可能导致工作满意度下降,影响心理健康。相反,创造性工作通常能带来更高的个人成就感和职业满意度。因此,鼓励Agent从事创造性探索工作可能更有助于提升整体福祉。
社会需求和未来趋势:社会对创新和创造的需求日益增加,这种趋势推动了对创造性职业的需求。例如,新兴技术、可持续发展解决方案和个性化产品等领域,都需要大量的创新思维和创造力。因此,社会和市场需求可能更倾向于从事具有创造性的探索工作。
综上所述,虽然从事简单重复的劳动在某些情况下具有其经济和效率上的优势,但从长远和全面的角度来看,鼓励Agent从事具有创造性的探索工作似乎更具前瞻性和可持续性。这不仅有助于经济和技术的发展,还能改善工作者的心理福祉和职业满意度。
Agent在制造业良率分析上如何应用
以Yield分析和提升为例,在进行Yield提升和案例分析时,存在大量重复的分析和判断工作,这些可以通过AI进行加速和辅助,而不需人工逐一检查。
工程师每天可能需要处理超过100个与良率相关的预警。其中约40%可能是由于测试问题、设备故障或是之前已经标注过的案例。这些都需要工程师逐一检查。由于人力有限,他们只能优先审查良率特别低的情况,可能会错过一些潜在的问题。通过使用特定规则和AI Agent,可以自动检查这些数据并作出判断。
在处理实际案例时,工程师通常会根据案例特征在知识库中查询处理方法,这一过程也可以由Agent自动完成,并缩小后续检查的范围。如果需要进一步分析,工程师会调用不同的工具用于检查,这些分析也可以通过Agent来执行。如果仍无法找到问题,可以提醒人工介入。当Agent成功分析出结果时,还会将分析过程和结果整理成图文并茂的报告,供工程师检查和使用。一旦这些分析被人工审核并采用,它们就会成为高质量的知识,自动加入知识库中供下次使用。
Reading
A busy person’s Intro to AI Agents
MetaGPT: Meta Programming for Multi-Agent Collaborative Framework
Generative Agents: Interactive Simulacra of Human Behavior
AI Agents are disrupting automation: Current approaches, market solutions and recommendations
AGI-Edgerunners-LLM-Agents-Papers
The Rise and Potential of Large Language Model Based Agents: A Survey
Large Language Model based Multi-Agents: A Survey of Progress and Challenges
The Landscape of Emerging AI Agent Architectures for Reasoning, Planning, and Tool Calling: A Survey