读完 Anthropic 的一篇博客 Demystifying evals for AI agents,深有感触。
结合文章内容和最近的工程实践,整理了一些关于构建 Agent 评估体系的笔记,和一些思考。
为什么需要 Evals?
Evals 的本质不是为了打分,而是为了让开发可量化。
在缺乏评估体系时,开发团队往往面临着极大的不确定性:无论是优化 Prompt 还是更换基座模型,都难以判断这些变更是真正解决了问题,还是在引入新问题的同时破坏了原有的能力。
在早期的 Demo 阶段,依赖人工测试或许能快速验证想法。然而,Agent 系统不同于单次交互的对话模型,它包含多步骤推理和动态工具调用。随着系统复杂度的增加,手动测试的覆盖率和回归效率将难以为继,团队很容易陷入“由于缺乏前置检测,只能依赖线上反馈被动修复 Bug”的恶性循环。
此外,Evals 也是产品与研发之间的通用语言。将模糊的主观感受,转化为准确率、响应延迟和 Token 成本等可度量的工程指标。
目前的评估方式,依旧还是三大件:
-
人工评估:最准确但最贵。通常用来作为Golden,用于校准自动评估的准确性。
-
代码基准 (Code-based):适用于有明确唯一答案的场景(如数学计算、代码运行)。
-
LLM-as-a-judge:目前的主流。用更强的模型去评估其他模型的输出。关键点:需要经过人类专家的校准。
(注:关于评估的具体细节与最佳实践,推荐参考 Hugging Face 的 The LLM Evaluation Guidebook )
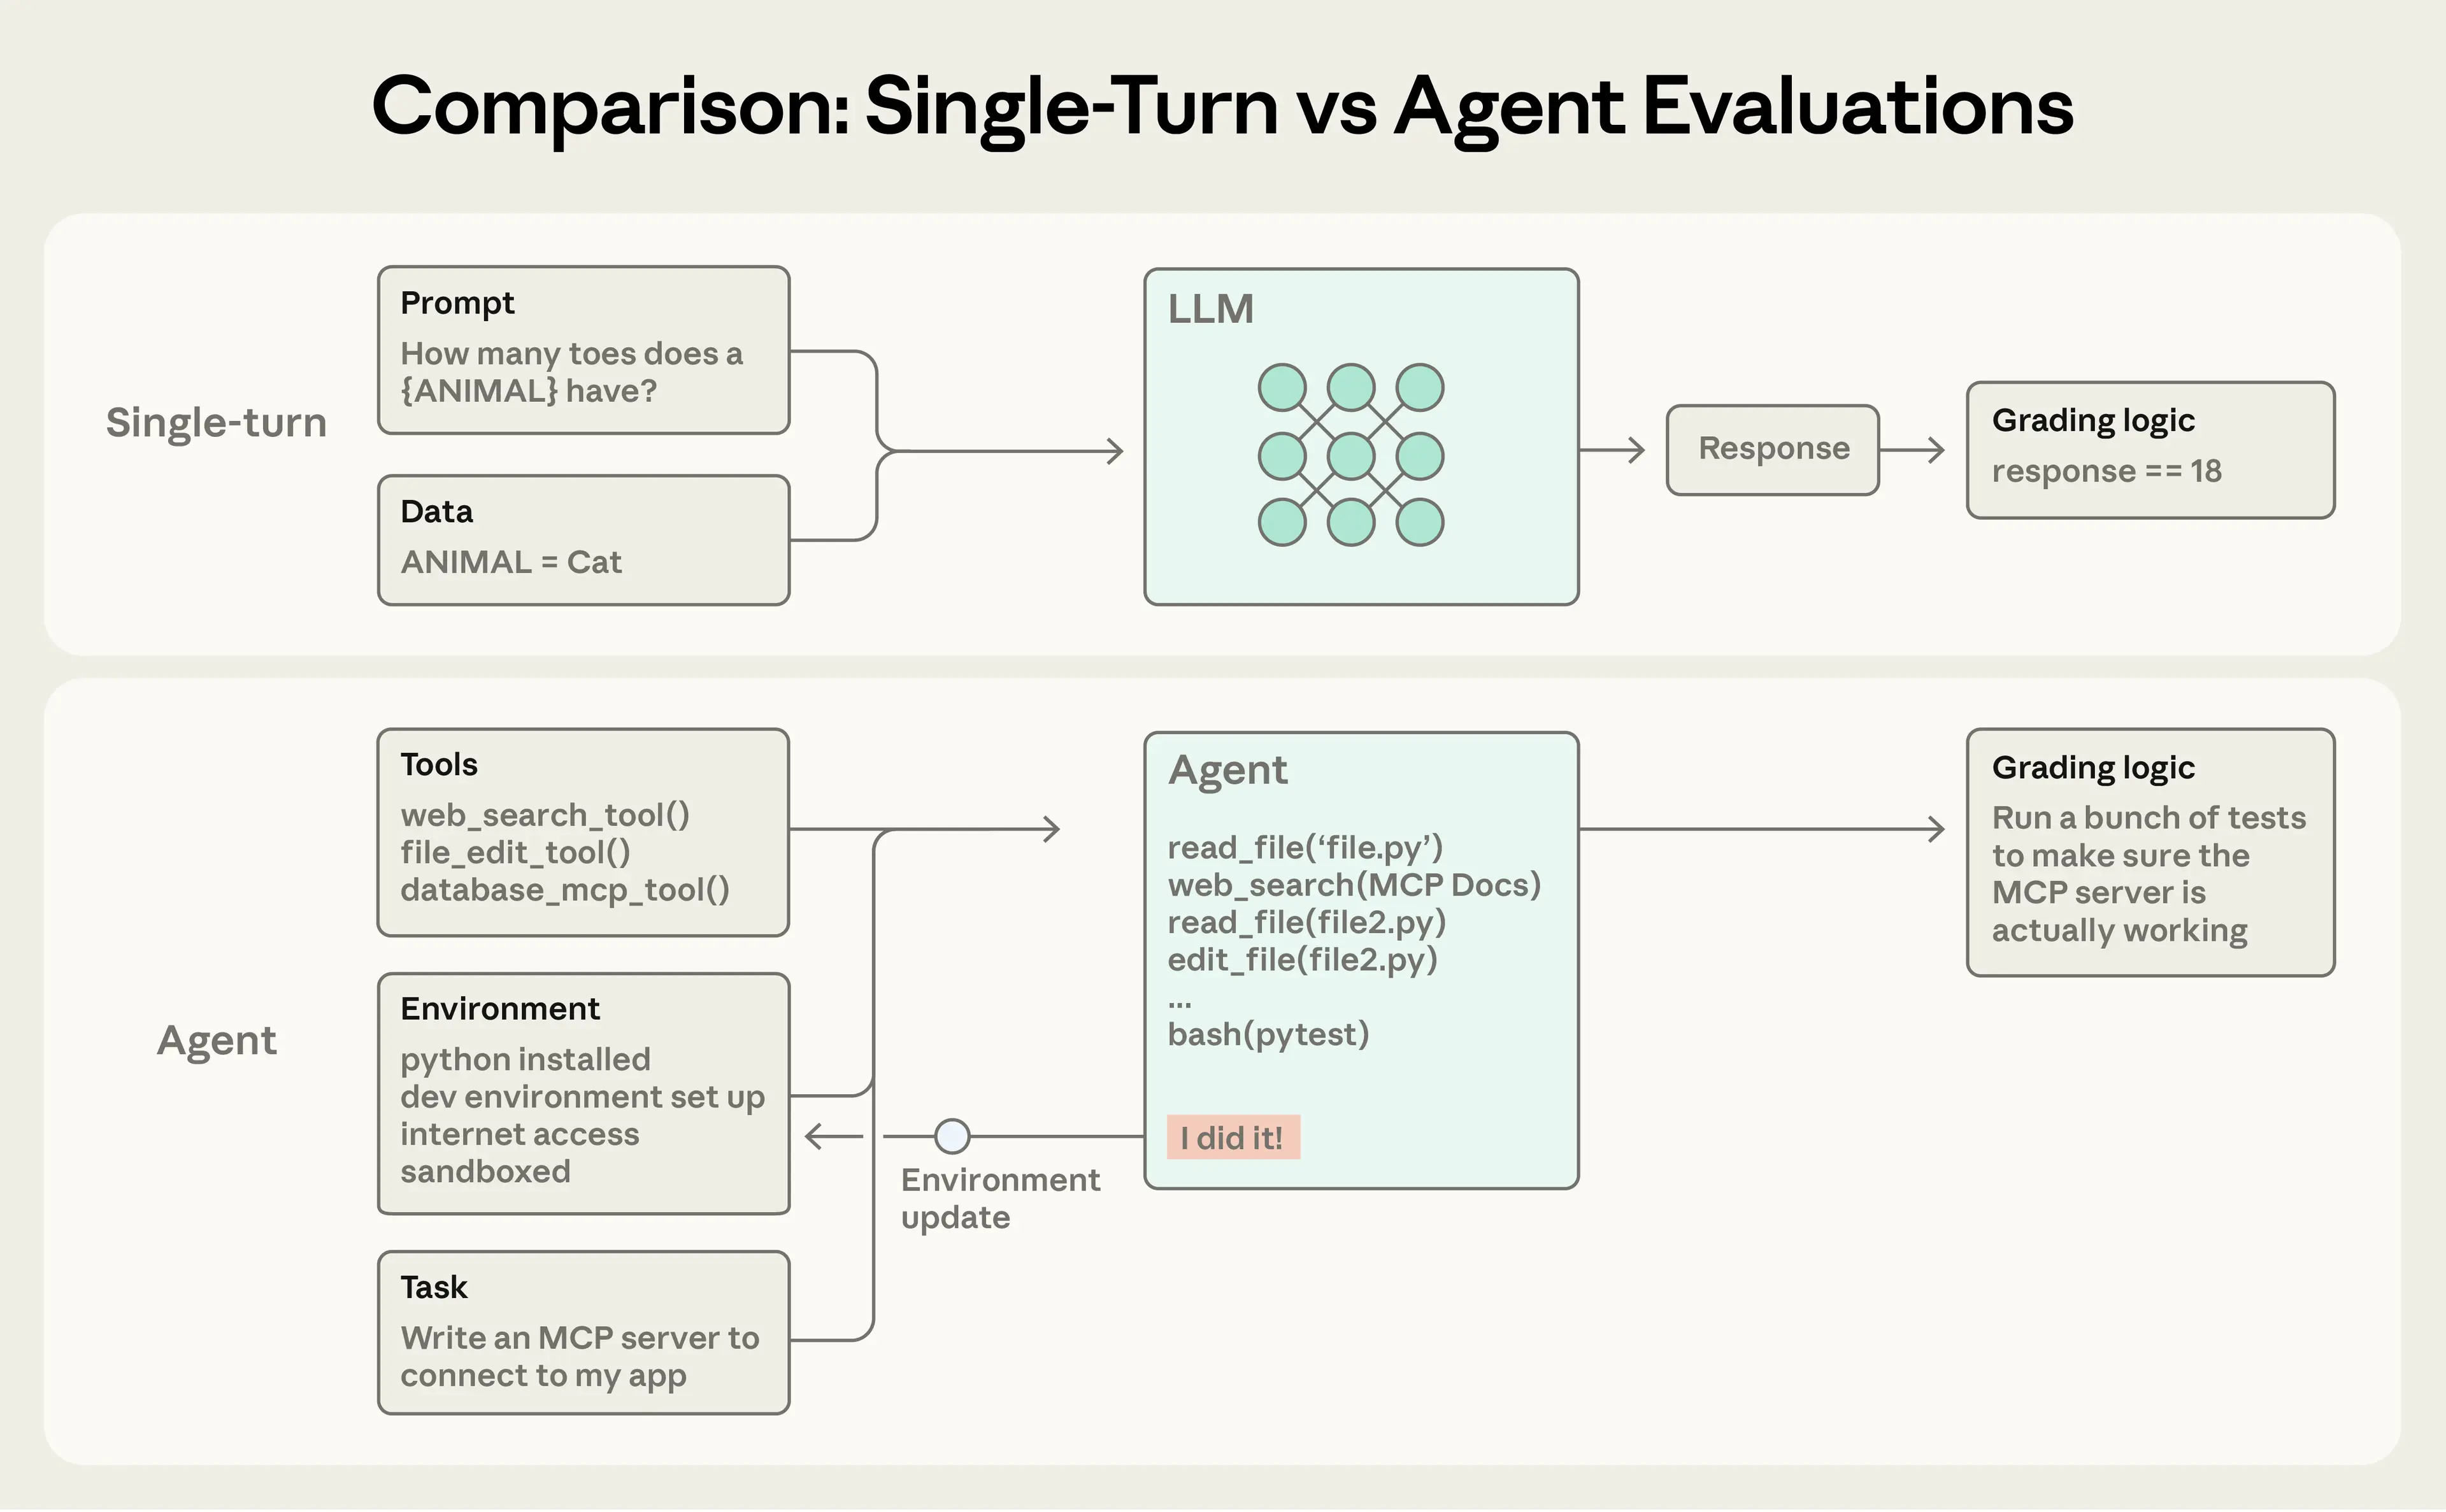
Agent Eval 和LLM Eval 的不同
相比于单纯的 RAG 或 LLM 评估,Agent 的评估复杂度要高得多。
- 从“测模型”到“测系统”
正如Why benchmarking is hard,中提到的“许多变动的部件和自由度都会影响最终结果”。在 Agent 开发中,
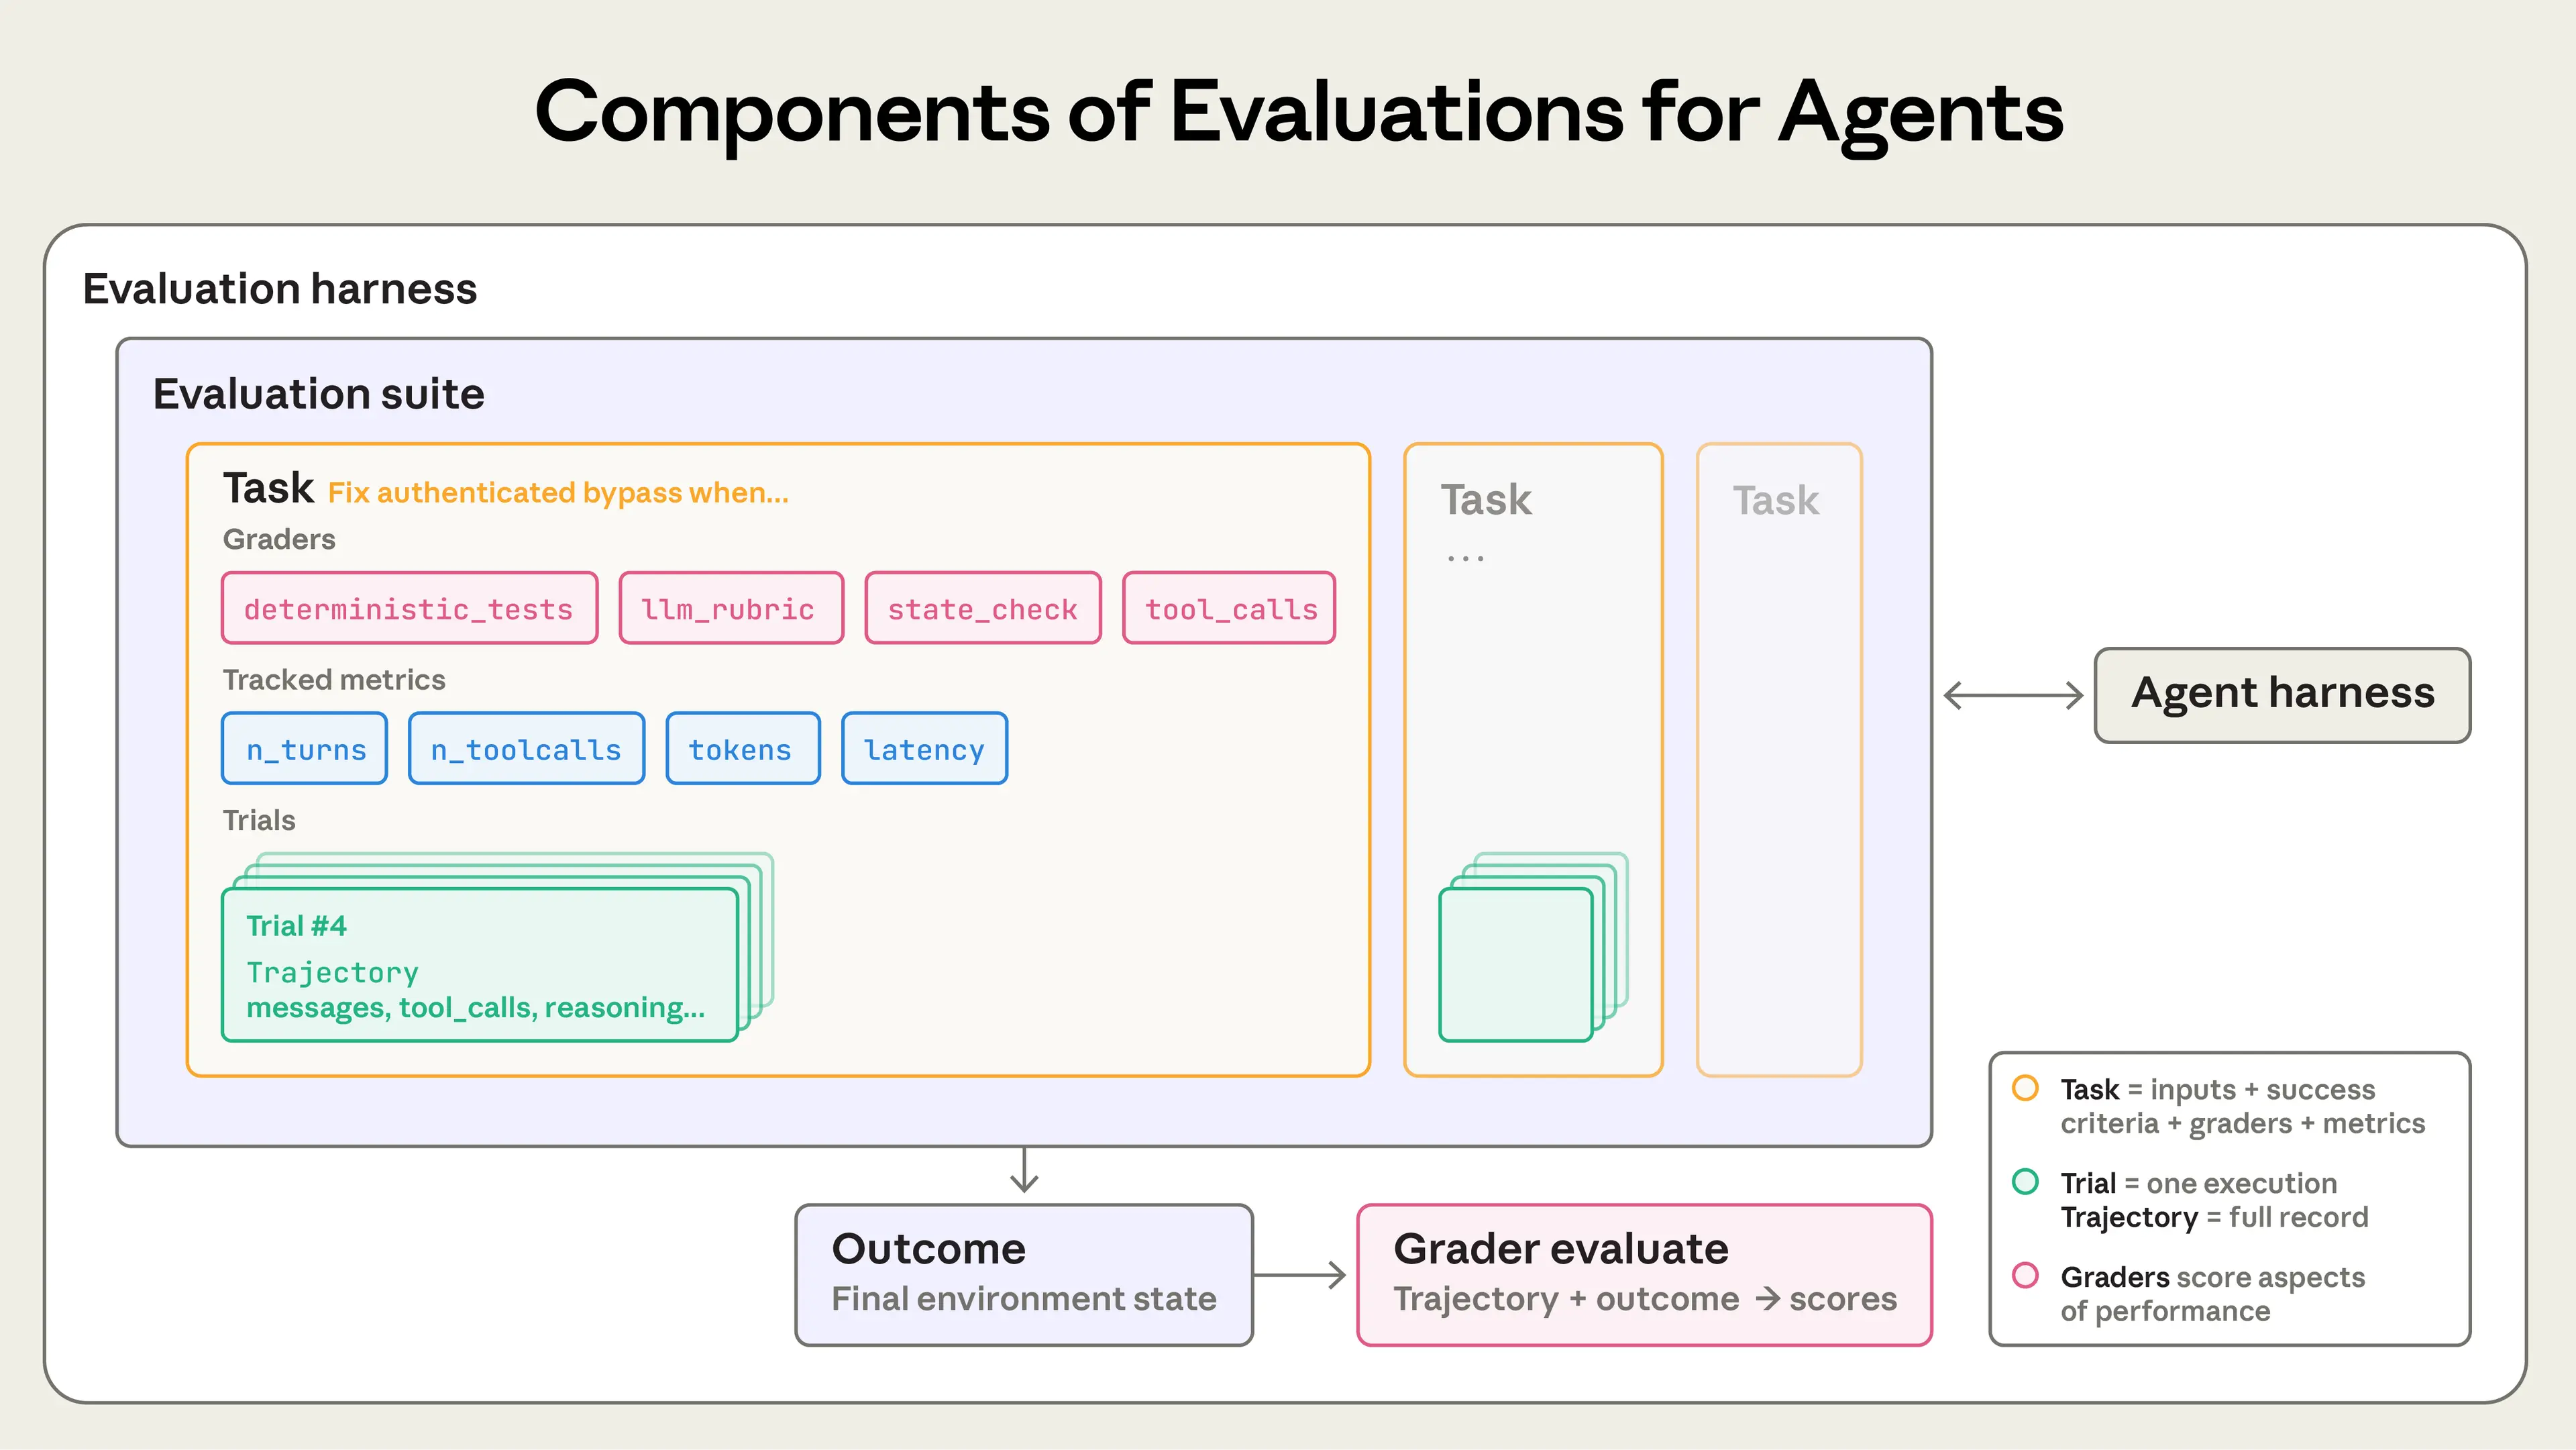
我们测试的永远不是“裸模型”,而是 “模型 + Harness” 这个整体。
这里的Harness 分成两大部分:Eval Harness(我们的评估系统本身)+ Agent Harness (Scaffold)。
这些“脚手架”中的每一个变量,都会直接影响最终的评估结果。
因此,Agent Eval 实际上是对整个工程系统的综合验收,比较两个 Agent 的分数时,必须考虑到系统架构带来的差异。
- Outcome(执行结果)vs. Output(文本输出)
Agent 的核心在于“行动”。评估的核心不再是它“说了什么”,而是它“做了什么”。
Output (文本):Agent 回复用户的文本内容。
Outcome (结果):Agent 对环境造成的实际改变
当 Agent 回复“票已订好”时,这仅仅是 Output;而数据库中是否真的生成了订单,才是 Outcome。
因此,Agent 评估必须基于 环境状态(Environment State),而不仅是文本生成。
- Trace
传统的 LLM 评估往往将模型视为黑盒,仅关注输入与输出的对应关系。而在 Agent 评估中,Trace (执行轨迹) 包含了极高价值的信息。
Trace 记录了 Agent 的工具调用参数以及对错误的反思过程。相比于 LLM Evals,Agent Evals 不应忽略这些中间过程。
Capability 与 Regression
建议将评估体系拆分为两类,分别对应 Agent 生命周期的不同阶段:
- Capability Evals (能力评估)
目标:验证能力边界(测上限)。 探索 Agent 在特定任务上到底能达到怎样的高度。
场景:技术选型、架构调整、引入新工具时
指标:这里的通过率(Pass Rate)通常不高,目的是指引优化的方向
- Regression Evals (回归评估)
目标:保障系统稳定性(测下限)。 核心目的是防止能力退化,确保 Agent “没有变笨”,且已有的功能未被破坏。
场景:CI/CD 流程、发版前的自动化测试
指标:要求极高的通过率,作为上线门槛
指标的选择
不同的业务形态决定了对“成功”的定义不同,从而影响指标的选择:
-
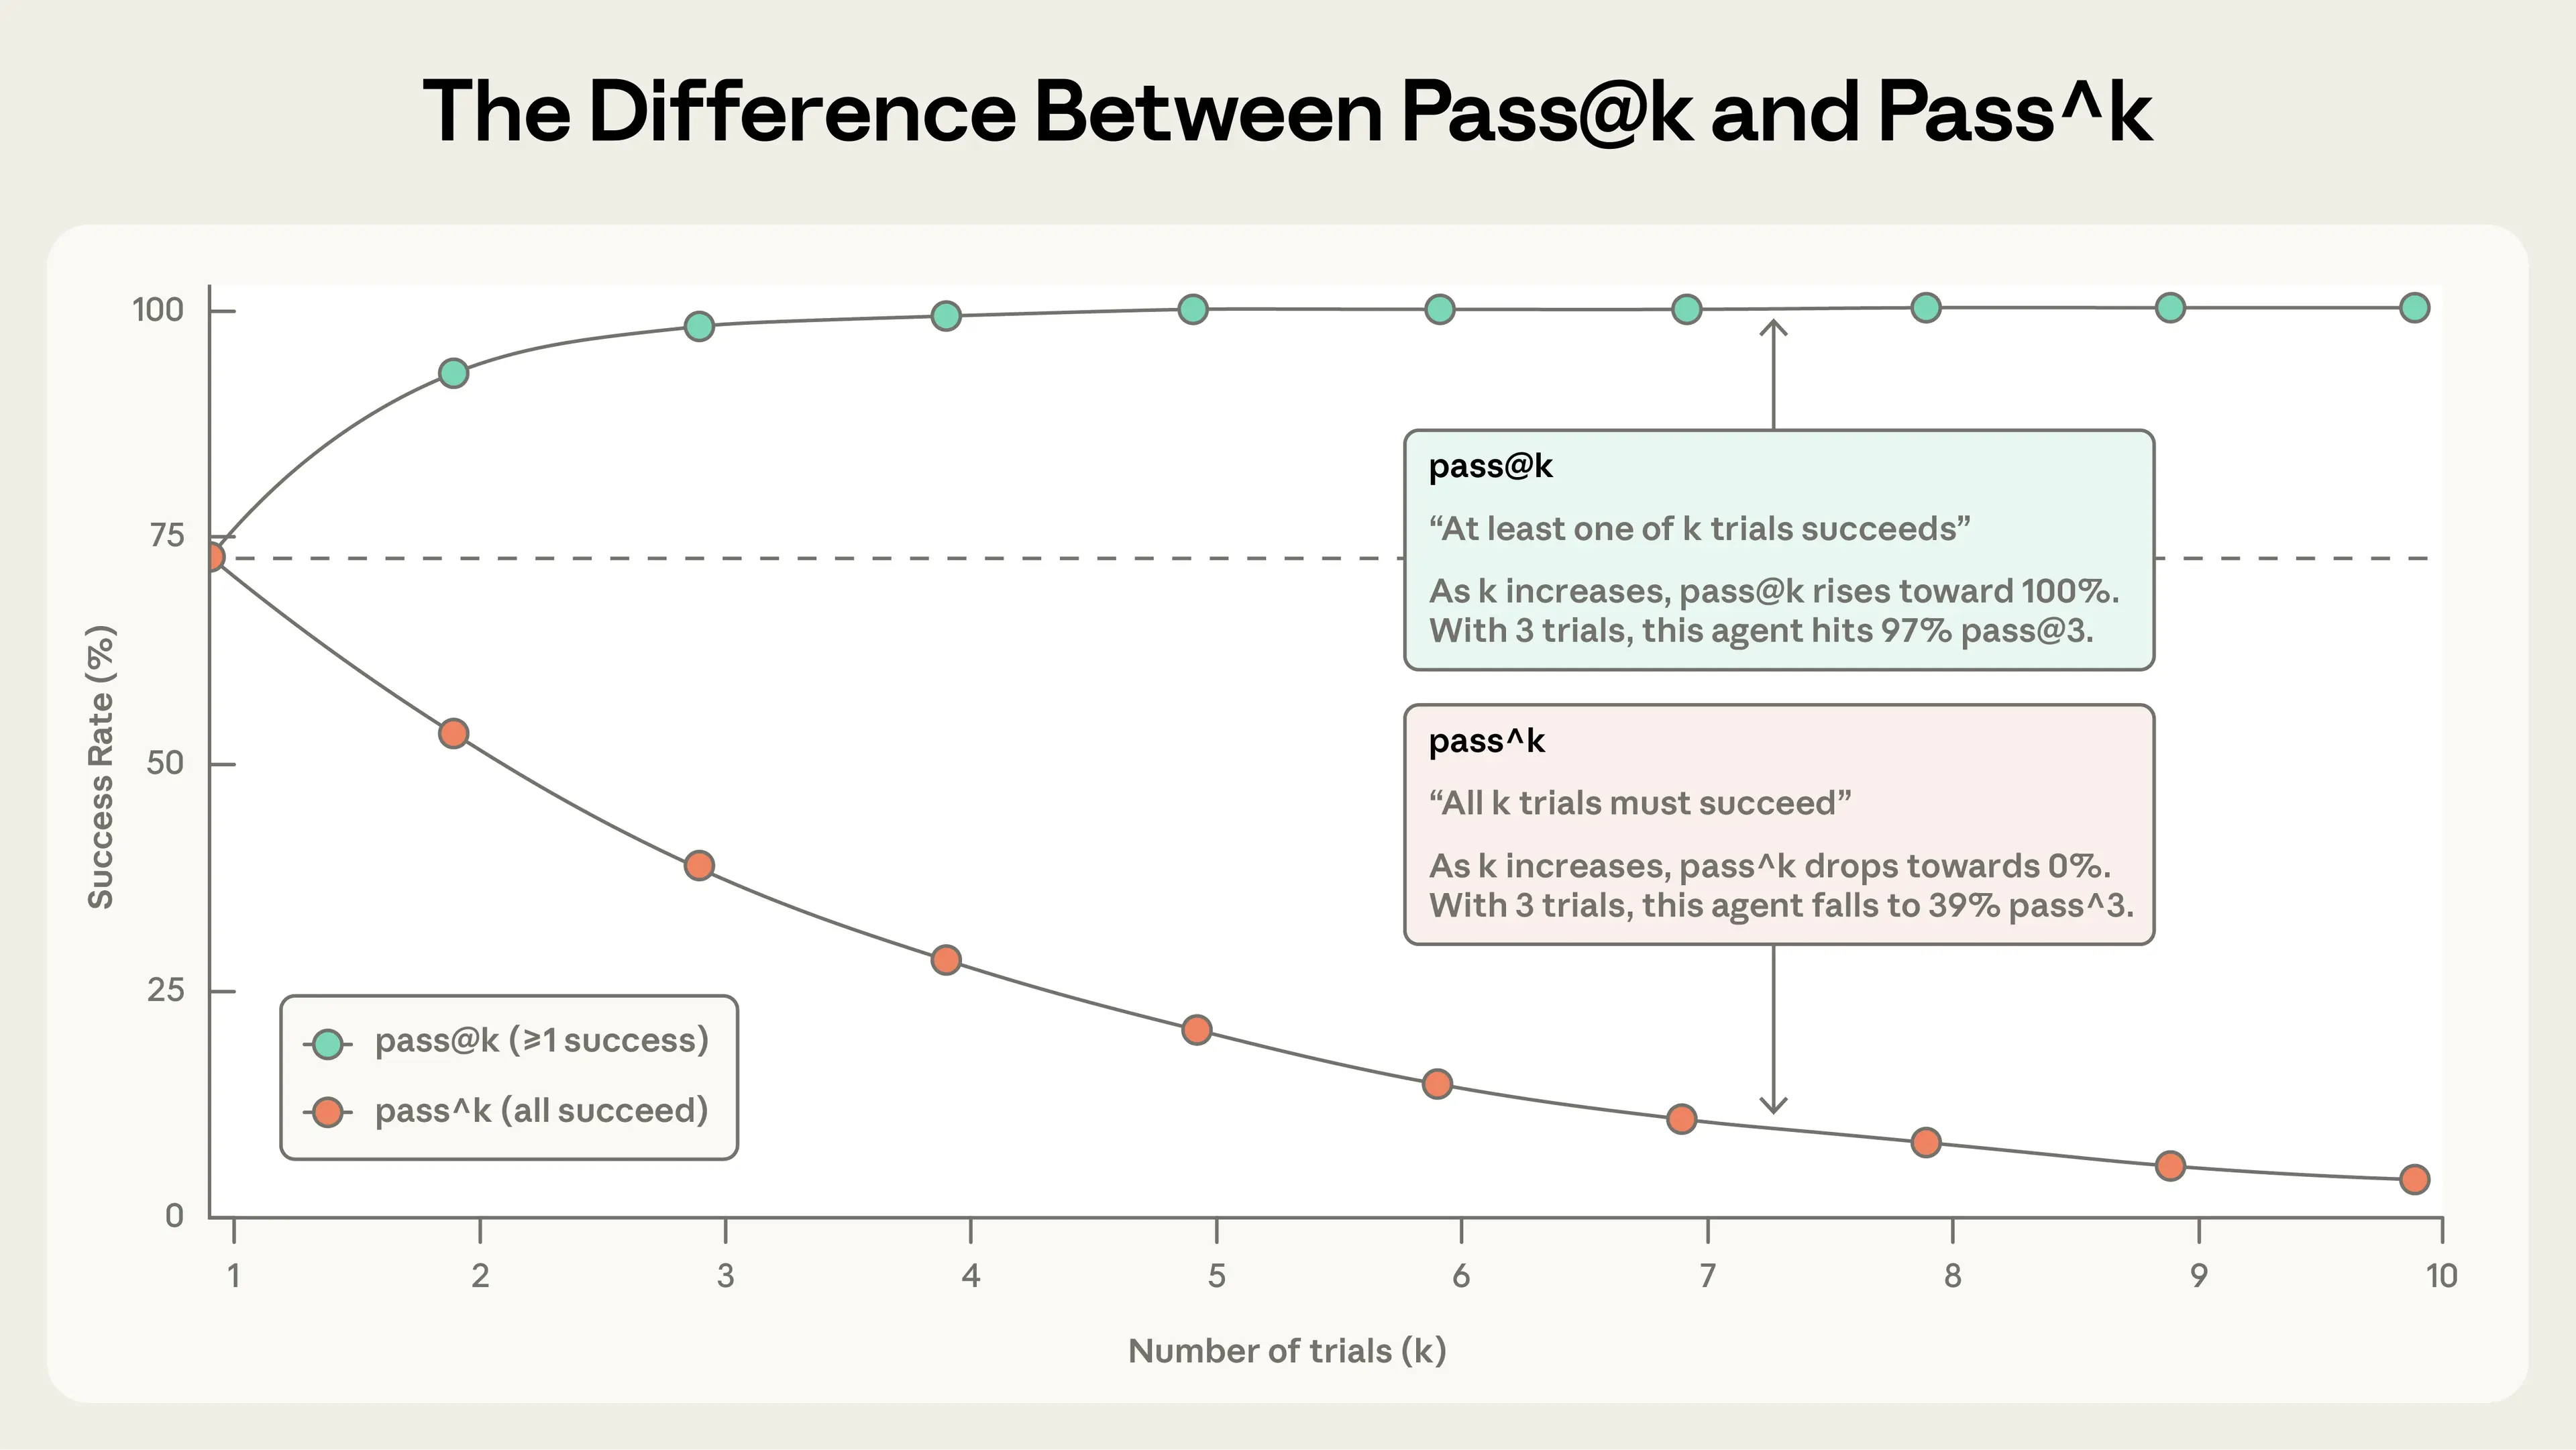
Pass@k (尝试 k 次,至少成功 1 次) (辅助类工具,关注的是最佳表现)
-
Pass^k (尝试 k 次,必须连续成功 k 次) (全自动 Agent, 关注的是系统可靠性)
如何落地
如何着手构建这套体系?核心原则是:以终为始,小步快跑。
1. 冷启动策略:20-50 个 Case 足矣
在初期阶段,不必追求构建海量的测试集。只需要收集 20 到 50 个具有代表性的真实案例。
它的作用是让你快速跑通评估流程,并在后续的开发中通过不断的 Case 积累进行迭代,而不是在一开始就陷入数据清洗的泥潭。
- 环境隔离
Agent 的运行往往是非确定性的,且依赖环境。为了保证测试结果可复现,必须进行环境隔离。
如果多个测试共享同一个数据库或文件系统,状态的残留会导致测试结果不可信。
正如在评估 Data Agent 时遇到的典型问题:测试集中包含类似“查询昨日销售额”的时间相关 Query。
如果在周一运行,它是对的;但在周二运行,数据就变了。解决方案,是引入类似自动化沙盒或数据库快照机制,甚至需要对系统时间进行 Mock,确保无论何时运行测试,Agent 面对的都是一个“时间静止”的确定性世界。
- Eval-Driven Development
借鉴 TDD(测试驱动开发)的理念,在编写 Agent 的 Prompt 或工具代码之前,先定义好测试用例(Task)和成功标准(Success Criteria)。
- Swiss Cheese Model
必须承认,没有任何一种单一的评估手段是完美的。自动化 Evals 只是防线的一层。一个健康的 AI 系统质量保障体系,应该遵循“瑞士奶酪模型”,即多层防御:
第一道防线:自动化 Evals 日常开发中的单元测试与回归测试,用于快速发现明显的逻辑错误和能力退化。
第二道防线:系统化人工评估 由专家对自动化评分的结果进行抽检和校准,确保机器裁判的标准没有跑偏。
第三道防线:A/B 测试 在真实流量中灰度发布,对比新旧版本的实际业务表现。
第四道防线:生产环境监控 设置兜底逻辑和实时告警,防止 Agent 在极端情况下产生失控行为。
第五道防线:用户反馈与 Trace 审计 利用用户的 Complaint 和对线上日志的深挖,发现那些测试集未覆盖到的长尾问题。
结语
LangChain 不久前曾提出过 Agent Engineering 的概念,认为这是一门融合了产品洞察、工程架构与数据科学的新兴学科。

面对 Agent 这样一个高度非确定性的复杂系统,传统的线性工程思维往往难以奏效。我们需要引入科学实验的思维模式: 核心在于建立一套严谨的评测体系,将庞大的黑盒拆解为一个个独立的子系统。通过屏蔽干扰、锁定环境,去单独量化每一个模块的变化对整体的影响。
只有通过这种严格的控制变量法,一步步摸索边界,才能真正驾驭 Agent 的复杂性。
简而言之:控制变量,大胆假设,小心求证
这也是过去物理人的经历所教会我的。
Read More
Agent Engineering: A New Discipline
Evals are a team sport: How we built Loop
langsmith: Evaluation concepts
deepeval: AI Agent Evaluation Quickstart
AI Safety vs AI Security in LLM Applications: What Teams Must Know
Mastering Agents: Evaluating AI Agents
LLM Evaluation 101: Best Practices, Challenges & Proven Techniques
LLM Agent Evaluation: Assessing Tool Use, Task Completion, Agentic Reasoning, and More