看着Tongyi Deep Research (TDR)用着30B的参数量能够跑出媲美闭源模型的效果,总是好奇究竟怎么做到的?
最近一个多月断断续续,总算读完了了Tongyi Deep Research 的一系列论文,虽说越往后,官方透露的技术细节越少,但细读下来,依然能一窥其背后的“门道”。
最大的感受是,TDR在训练算法上并没有太多黑科技,反倒是数据的合成、训练环境的设计和大量的工程化设计,或许才是其成功的关键,以及重点。
大概从以下3个角度出发,整理了下TDR系列论文中的最佳实践和创新点:
-
Agent的训练方式
-
训练所使用的数据合成管道和方法论
-
工程化优化和设计
训练方式
通过LLM+工程化实现agent,还是直接将agent能力内化至LLM中?TDL选择了后者,并提供了更完整的训练链路:Agentic Mid-training + Agentic post-training。
Agentic Mid-training
这一概念主要源于AgentFounder论文,其核心思想是在传统的后训练(Post-training)之前,增加一个Agentic Continual Pre-training (CPT) 阶段。
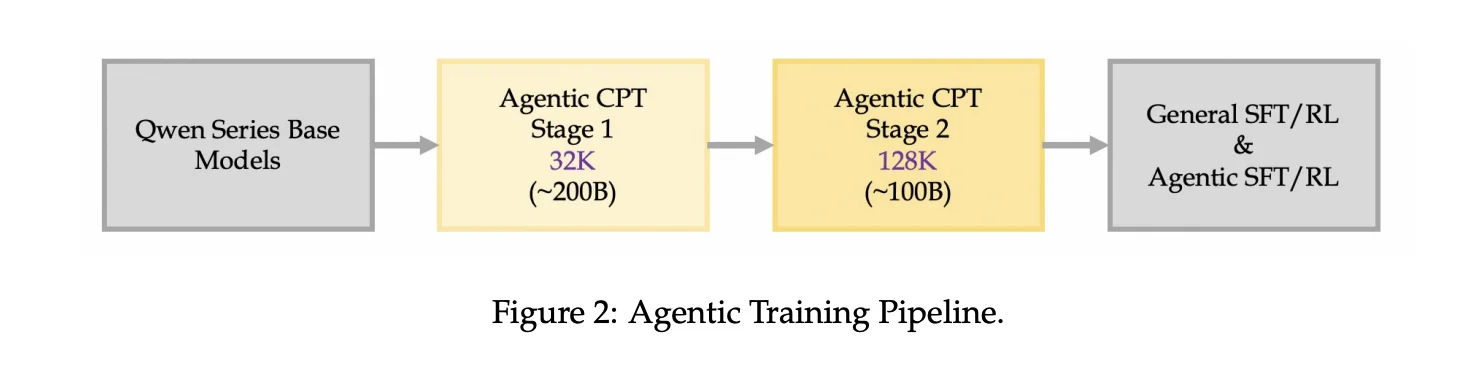
为什么需要CPT?
后训练流程面临一个核心困境:要求一个用来预测下一个token的LLM,在后训练阶段同时学习两件截然不同的事:
-
如何理解和调用工具、如何进行多步规划 (基础的agent能力)
-
如何在特定复杂任务上做出最优决策 (专家能力)
Agentic CPT的目标就是解决这一矛盾,先将一个通用的LLM转变为Agentic Foundation Model,将更强的工具调用和推理能力内化其中。
相比之下,后一个阶段(agentic post-training)方法基本上成为共识: SFT+RL,并没有太多新的东西。
在RL的环境构建,采用了双环境的设计, 针对web-agent场景, 一个虚拟环境确实可以节约大量的时间和成本:
-
模拟环境: 构建一个离线的搜索和查询环境,用于快速验证算法和策略
-
真实世界环境: 真实的外部API,用于训练和评估;采用5种工具(Search, Visit, Python Interpreter, Google Scholar, and File Parser);
数据合成
如何获得大量高质量的合成数据来支撑CPT、SFT和RL?
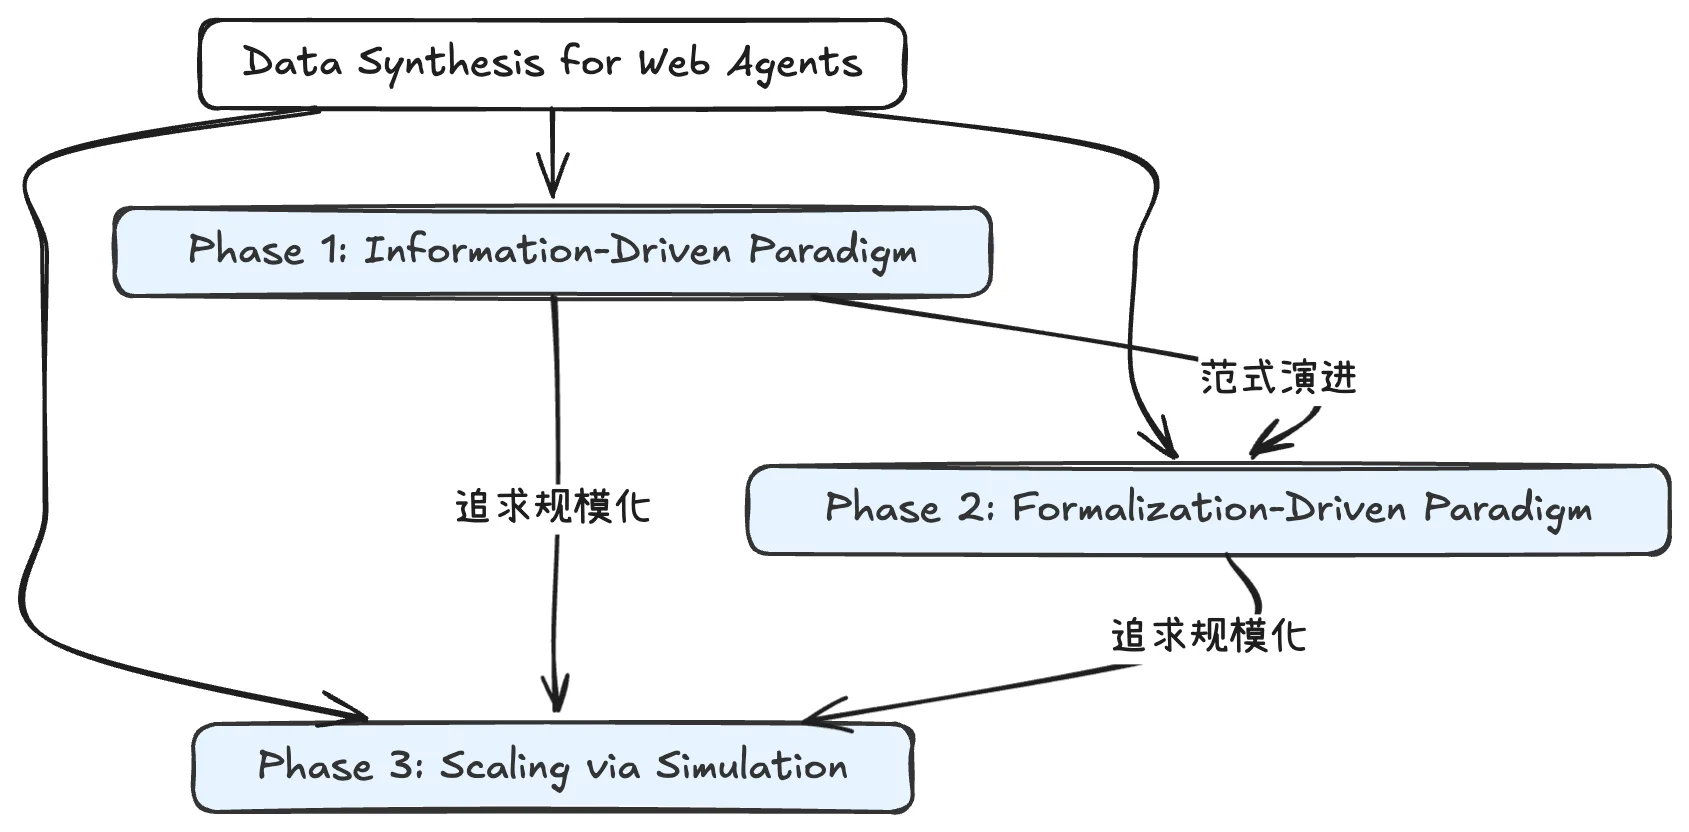
WebWalker & WebDancer
这两个工作中对应着几个benchmark和数据集的构建:WebWalkerQA 和 CRAWL QA (模拟浏览) & E2HQA(由易到难)
目的都是为了解决现有的QA对数据集太浅的问题;
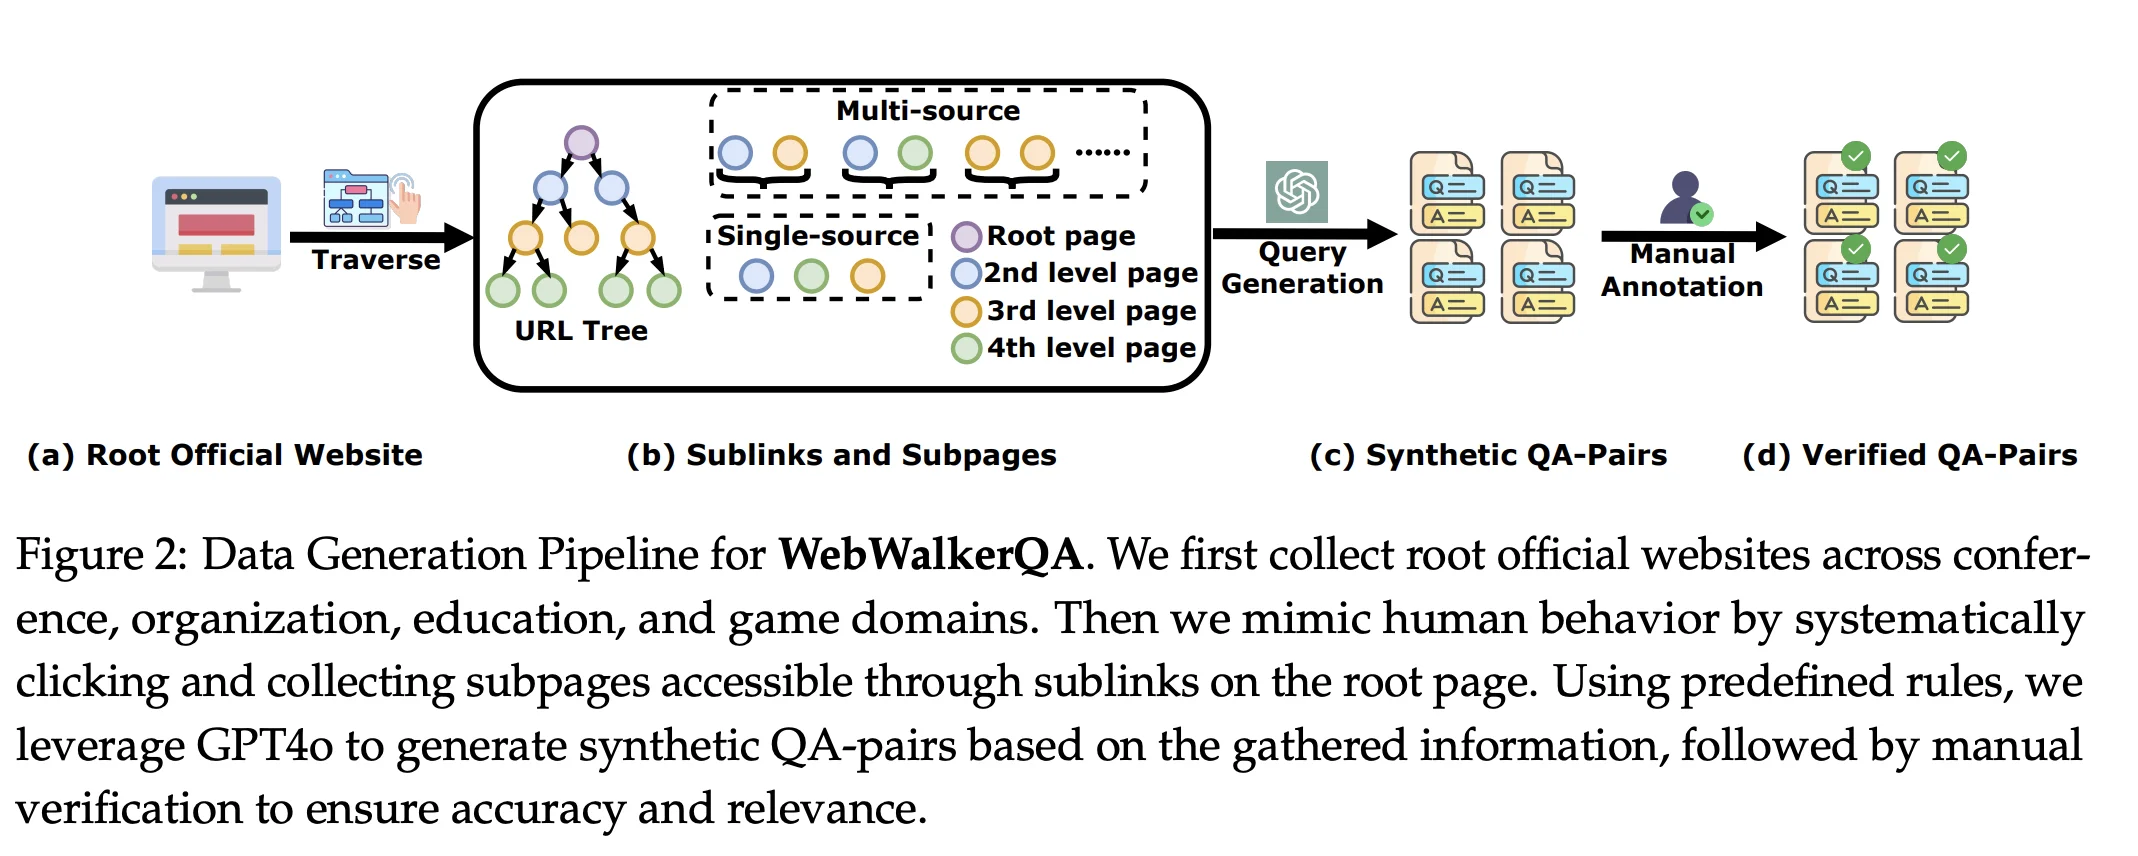
主流基于RAG的检索方式,是一种“横向搜索”,仅仅依靠关键词获取大量页面信息,缺乏像人类一样,深入点击、多页面联动的“深度搜索”。
WebWalkerQA: 通过递归遍历(从首页开始收集所有可访问子链接及其内容),然后结合预设角色让LLM生成查询问题,最后经过验证和过滤(剔除不自然、保留答案简短且含实体的QA)来生成数据
CRAWL QA:通过模拟人类浏览行为,从知识型网站(如维基、GitHub)上爬取多层页面信息,收集权威网站的根URL,程序化地点击链接、抓取子页面内容,然后使用GPT-4o根据收集到的信息生成需要整合多个页面信息才能回答的问题。
E2HQA (Easy-to-Hard QA):采用一种“由易到难”的逆向构建策略,将一个简单的问题通过迭代式地增加信息约束和子问题,逐步演化成一个复杂的多跳(multi-hop)问题; 具体而言,从一个简单问答开始,然后围绕答案实体搜索更多信息,并将这些信息改写成限定条件,融入原问题,使其变得更复杂。这个过程可以重复多次
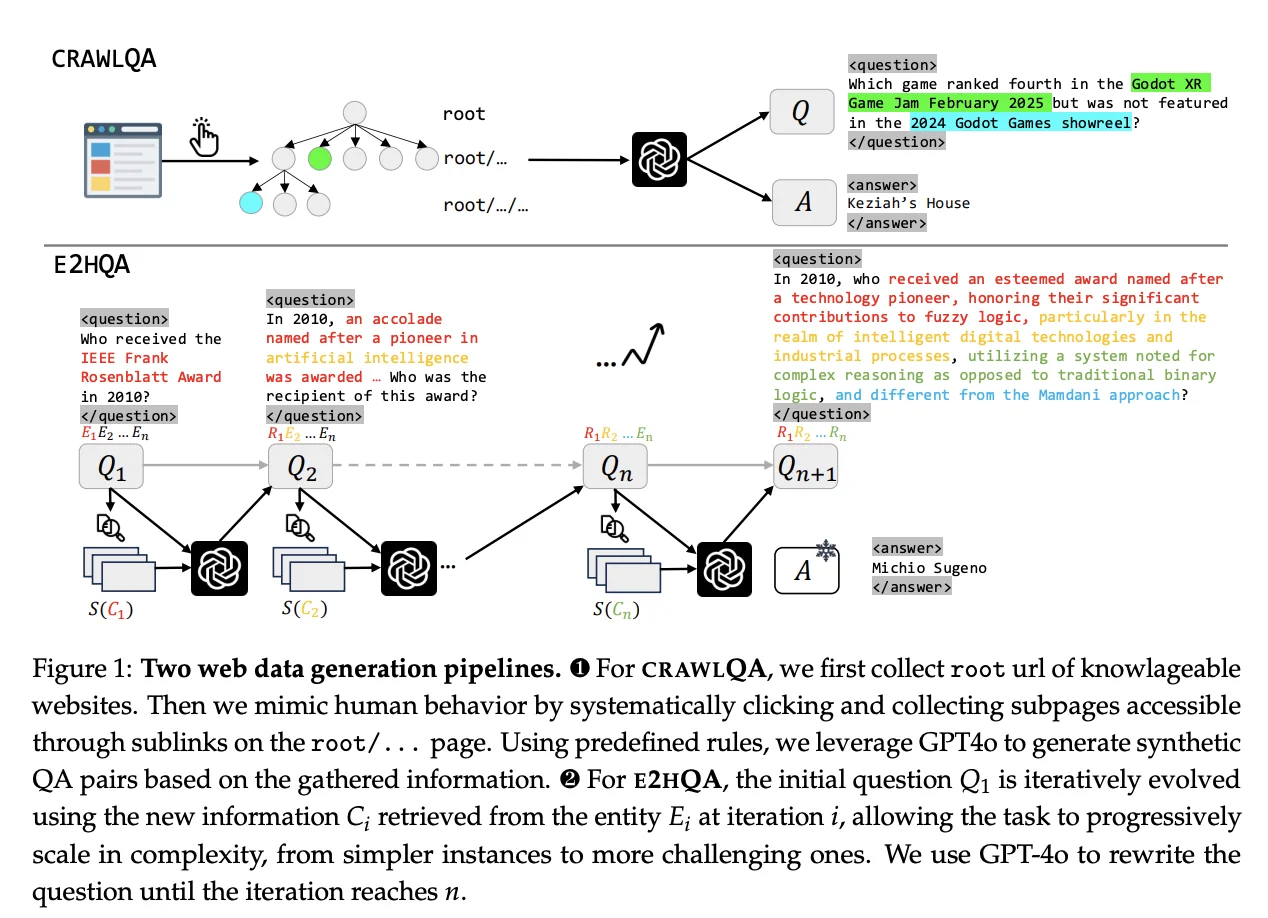
E2HQA的核心在于**“逆向构造”**:通常我们是从“描述”推理出“实体”,这里是反过来,利用LLM和搜索引擎,将问题中明确的“实体”替换为关于该实体的“描述性查询”。
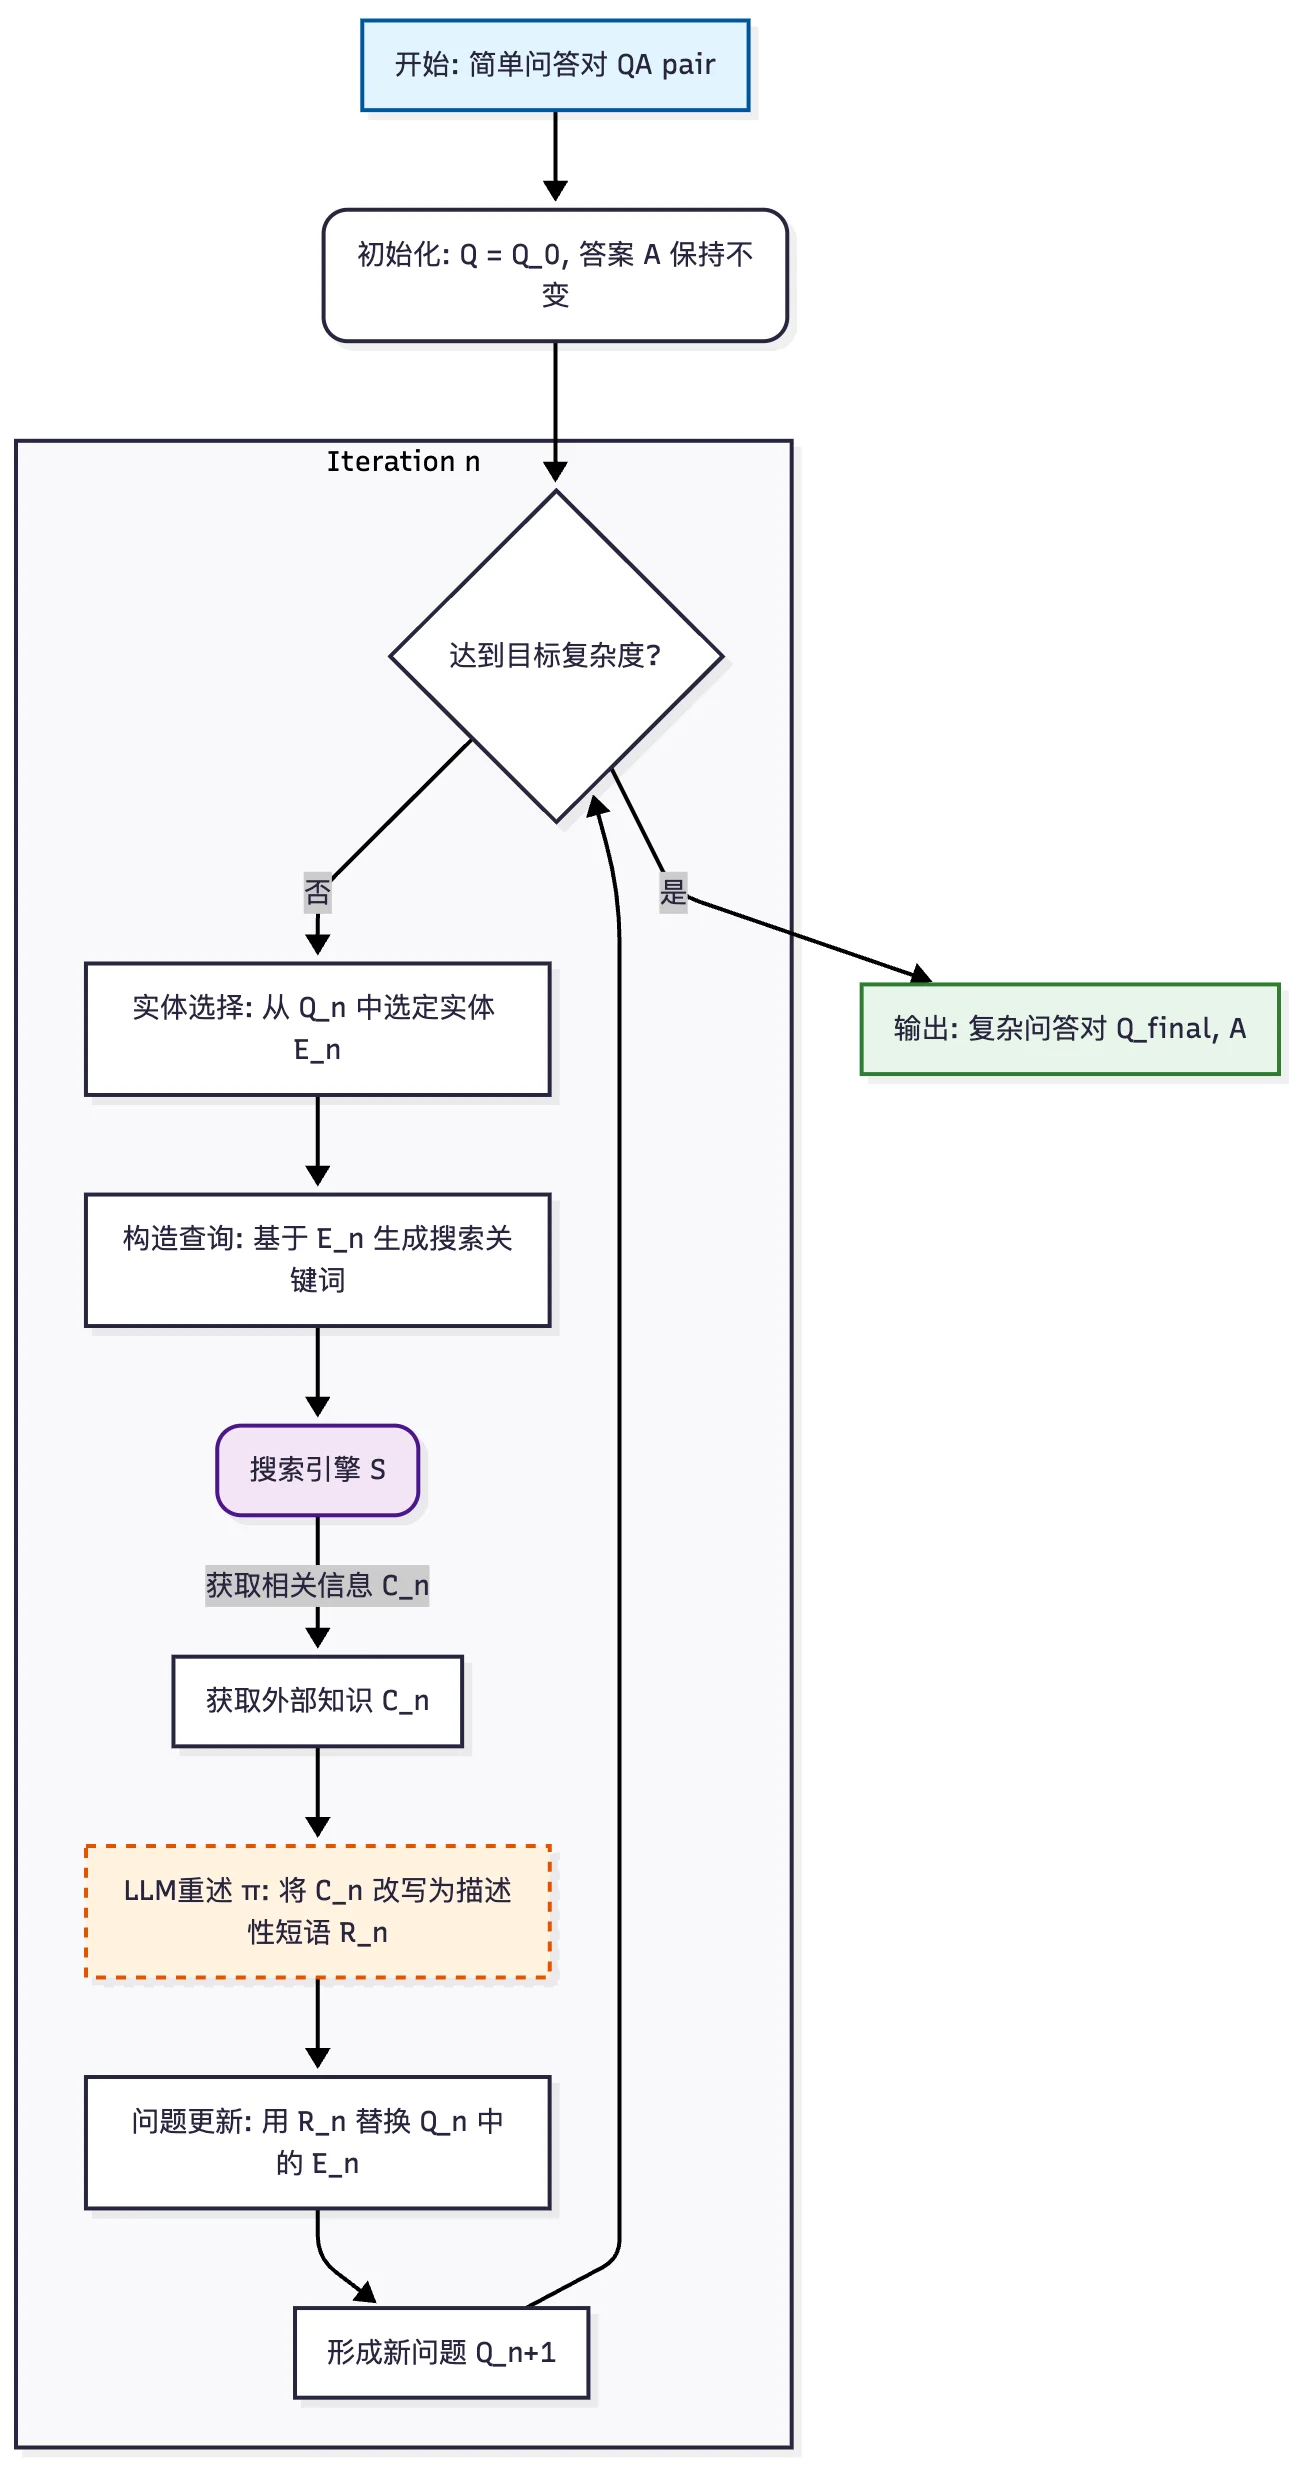
例子:
原始问题 ($Q_0$):爱因斯坦是哪里人?(答案:德国)
迭代 1:选中实体“爱因斯坦”。搜索并将其重述为“提出相对论的物理学家”。
- 新问题 ($Q_1$):提出相对论的物理学家是哪里人?
迭代 2:选中实体“相对论”。搜索并将其重述为“包含质能方程 E=mc² 的理论”。
- 新问题 ($Q_2$):提出包含质能方程 E=mc² 的理论的物理学家是哪里人?
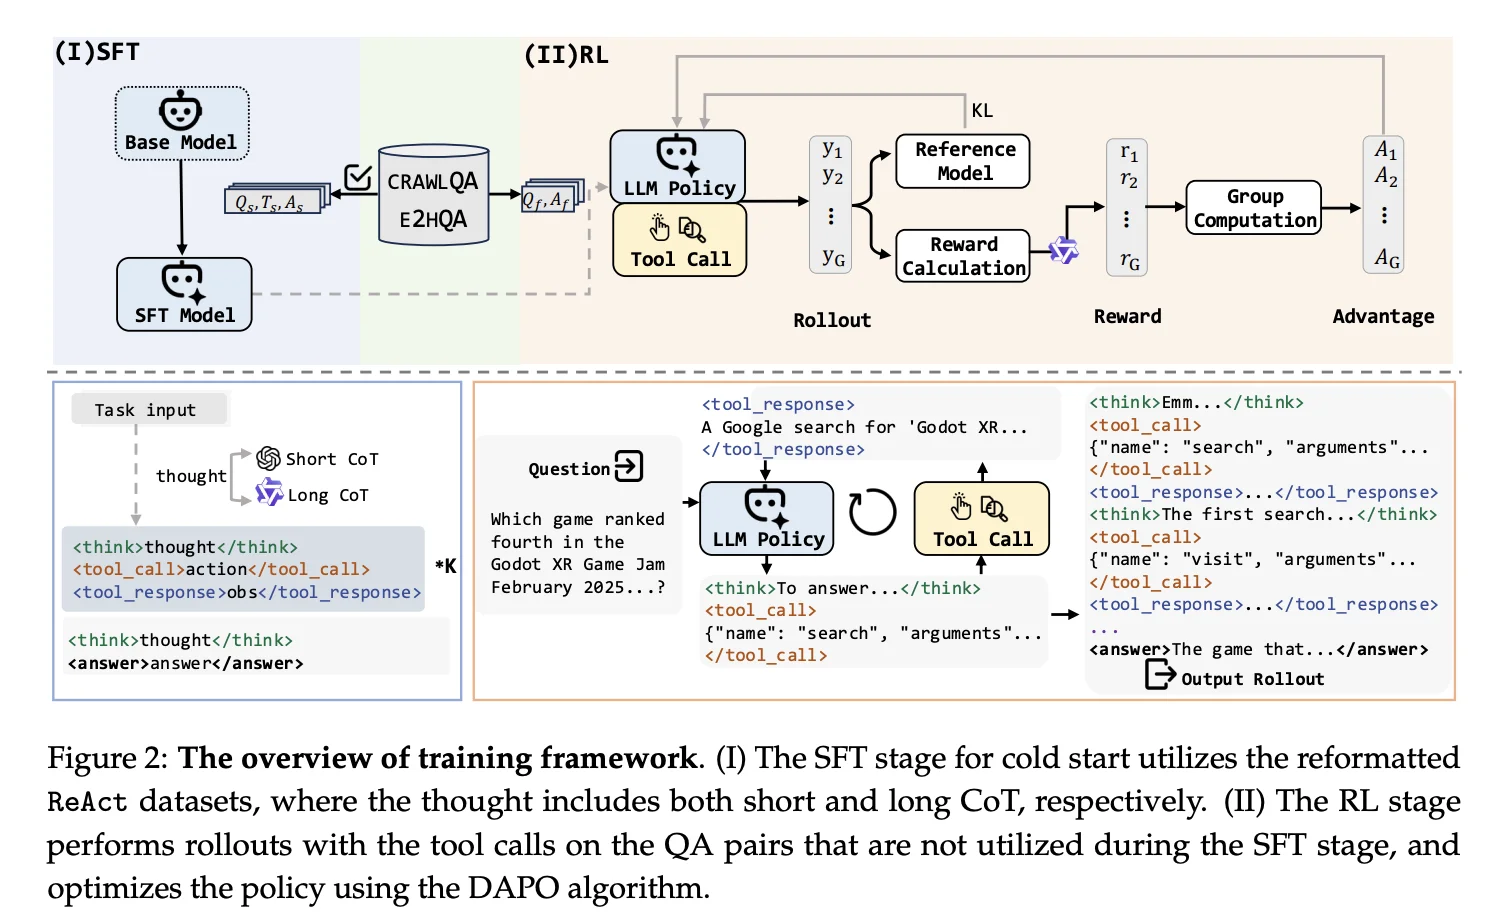
Agent Trajectories Rejection Sampling: 在构建了QA数据后,基于ReAct框架(只提供search和visit工具)来解决这些问题,并记录下完整的交互轨迹。通过一系列筛选(符合ReAct格式、答案正确、过滤幻觉和重复逻辑),保留下高质量的轨迹,用于SFT。
WebSailor
WebSailor的工作标志着一个重要的转折点:问题难度并非来自路径的长度,而是来自信息的不确定性。
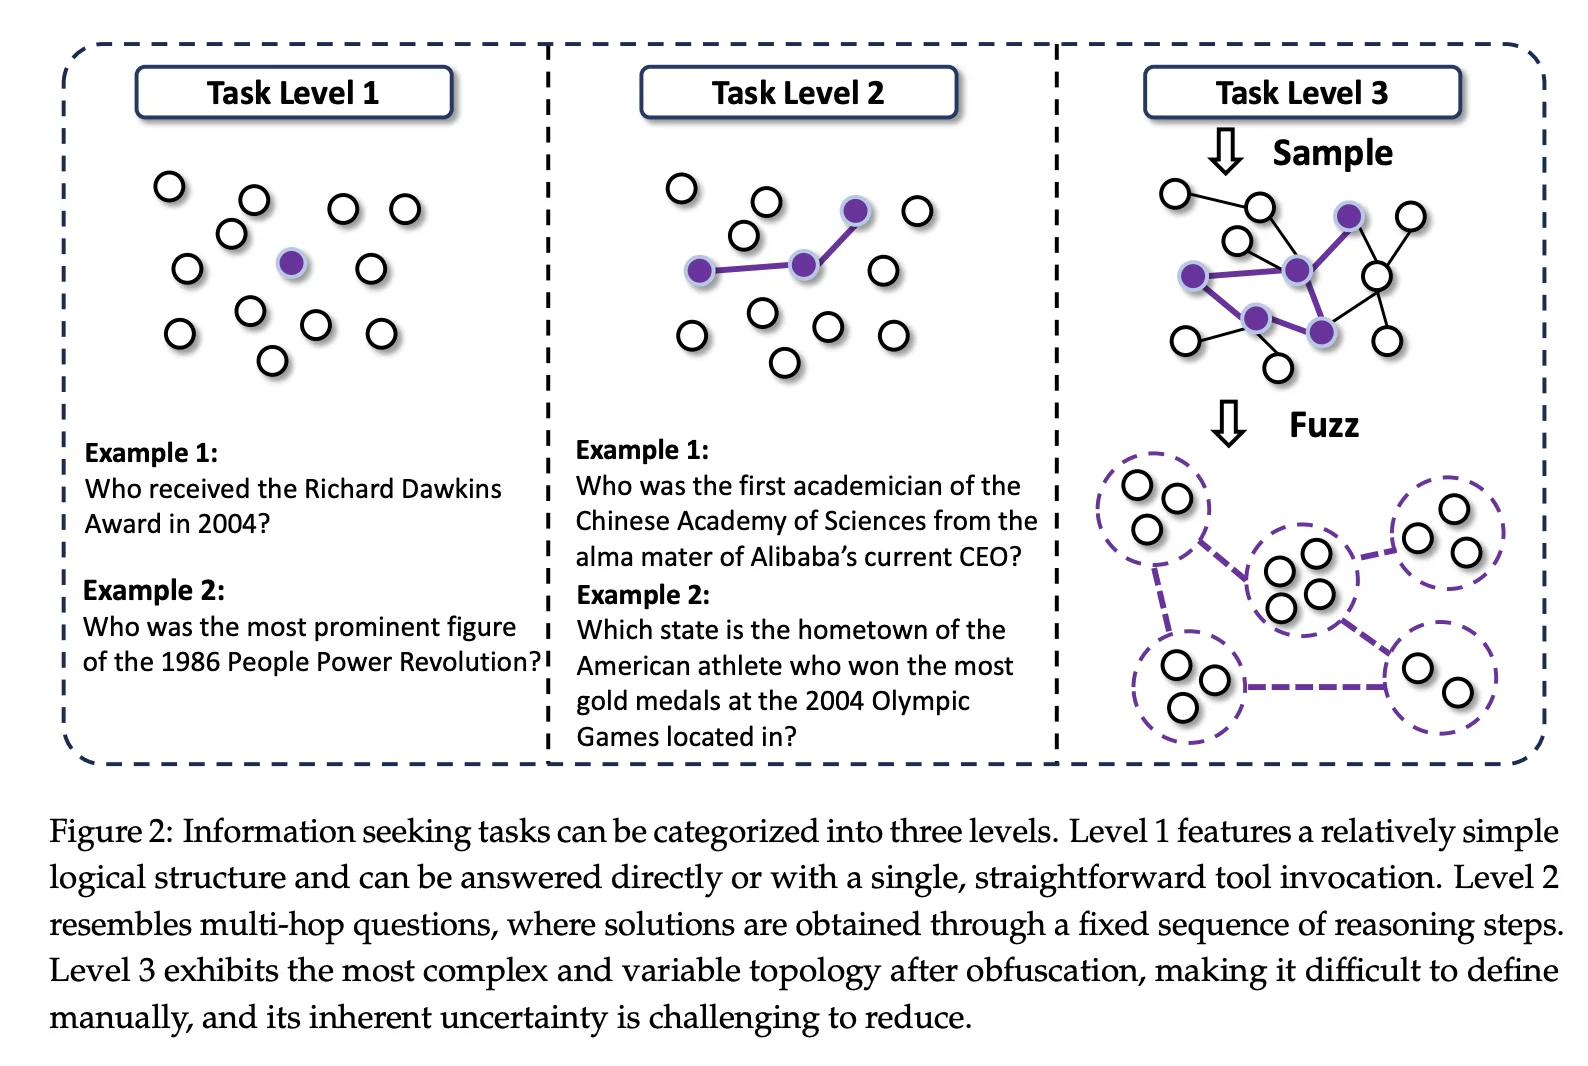
WebSailor提出了一种新的任务难度分类法,它真正要攻克的是Level 3:非结构化高不确定性任务。这类任务没有预设解决路径,Agent必须进行复杂的探索、比较、排除错误路径,并综合多方证据才能得出结论。
-
三种等级的任务难度分类法
-
Level 1: 低不确定性任务。这类任务可以通过单次搜索或利用模型自身的参数化知识直接解决。
-
Level 2: 结构化高不确定性任务。这类任务初始看不出答案,但存在一条清晰、结构化的解决路径,例如标准的多跳问答,每一步的目标都相对明确。
-
Level 3: 非结构化高不确定性任务。这是
WebSailor关注的核心。
-
在知识图谱中,通过Random Walk在图谱中生成长路径,这些长路径天然代表了多跳的推理路径;为此,WebSailor提出了SailorFog-QA,一种基于知识图谱和随机游走的高不确定性任务生成方法。
具体而言:
-
从一个模糊的实体(来自Wikidata)开始,通过模拟网页浏览(搜索、访问网页)进行随机游走,提取相关实体和关系,构建一个复杂的知识图谱
-
从图谱中随机采样一个子图,基于子图中的实体和关系,生成一个问题和答案
-
对问题中的关键信息进行模糊处理,增加其不确定性
而后采用一个推理模型回答SailorFog-QA的问题,生成完整的轨迹(Thought-Action-Observation),保留其中成功的Action-Observation,丢弃原始的Thought,并使用另一个模型为每一步重新生成简洁、精炼的Thought,形成最终的SFT数据。(这一步的原因是,直接用专家模型的COT进行SFT过于冗长)
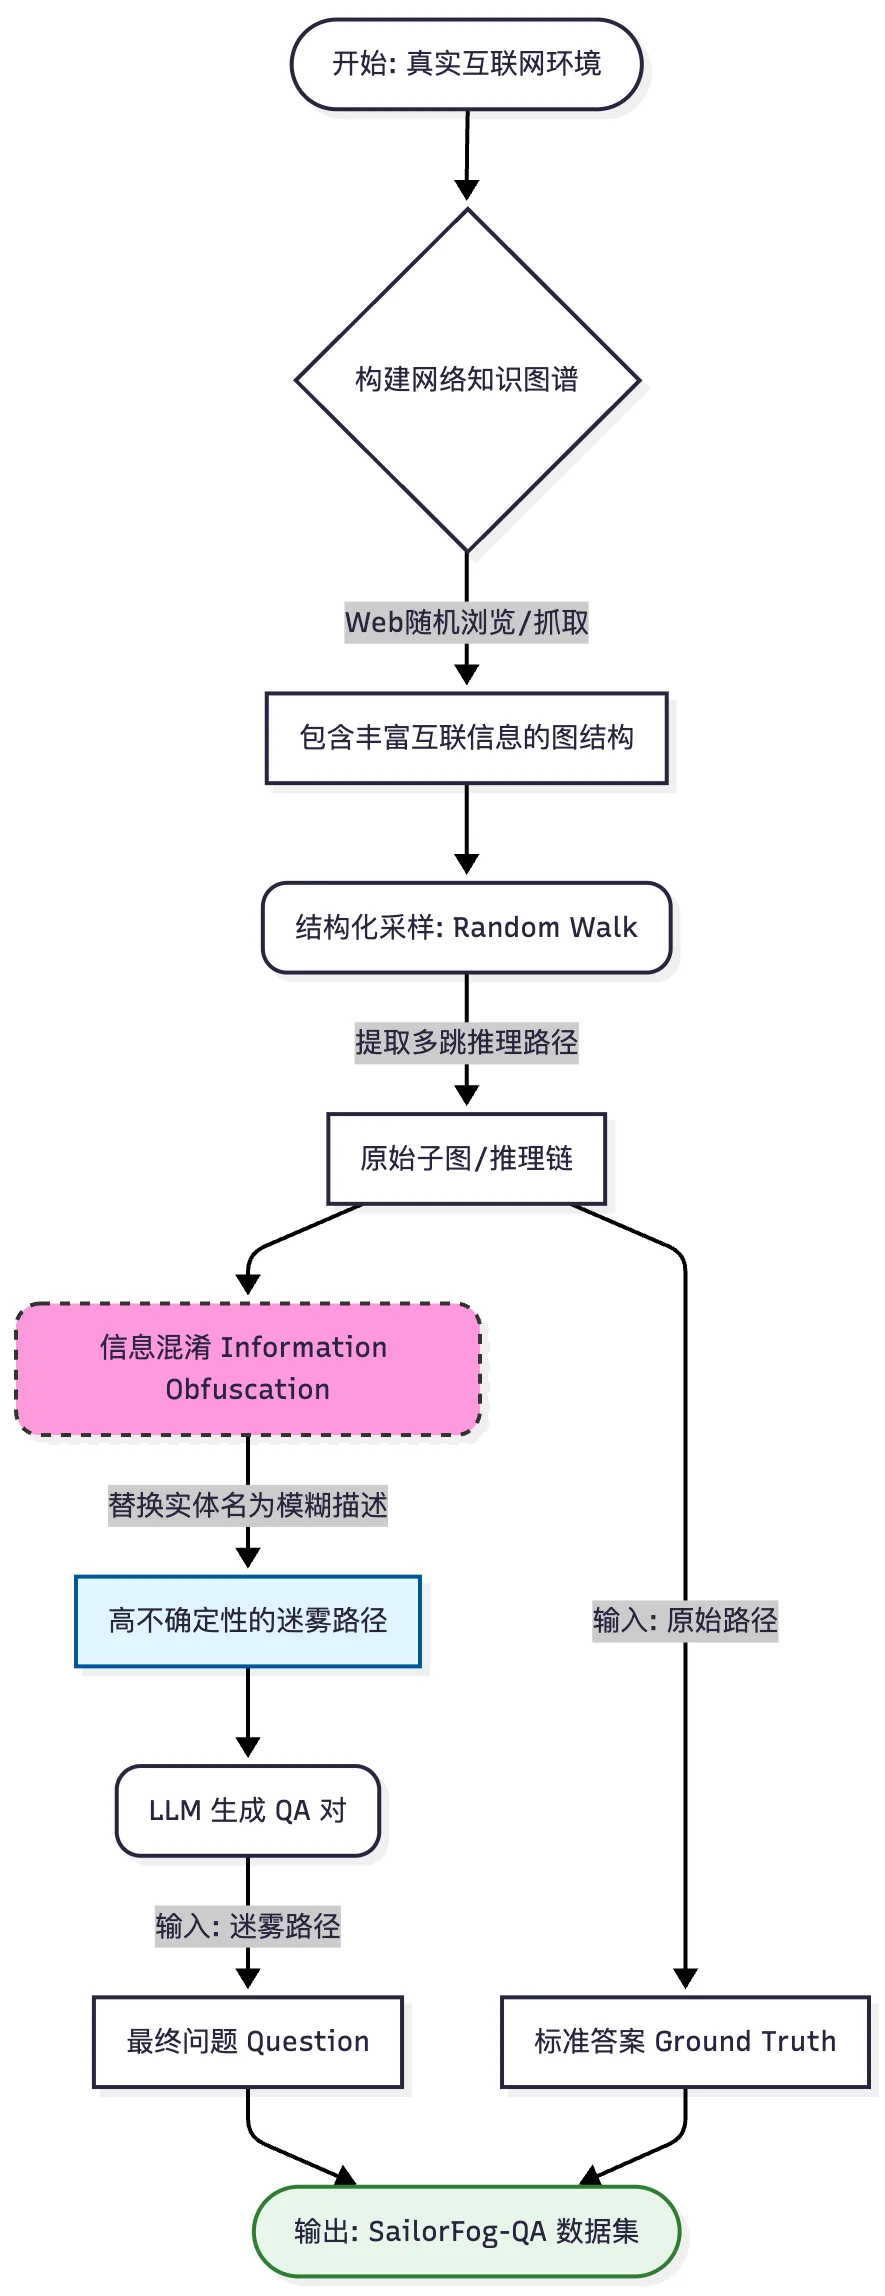
简而言之,就是通过在真实网站上随机游走构建复杂知识图谱,采样多跳路径,然后对问题中的关键信息进行模糊处理(例如,将实体名替换为描述),从而大幅增加任务的不确定性。
WebShaper
WebSailor虽然引入了不确定性,但合成过程还是“Information-Driven”(先搜集信息,再造问题),这可能导致问题结构和答案的不一致。
WebShaper则更进一步,提出了一种**“Formalization-Driven”的范式。其核心思想从“先有信息,再造问题”转变为“先定义问题的逻辑结构,再寻找信息填充”**。
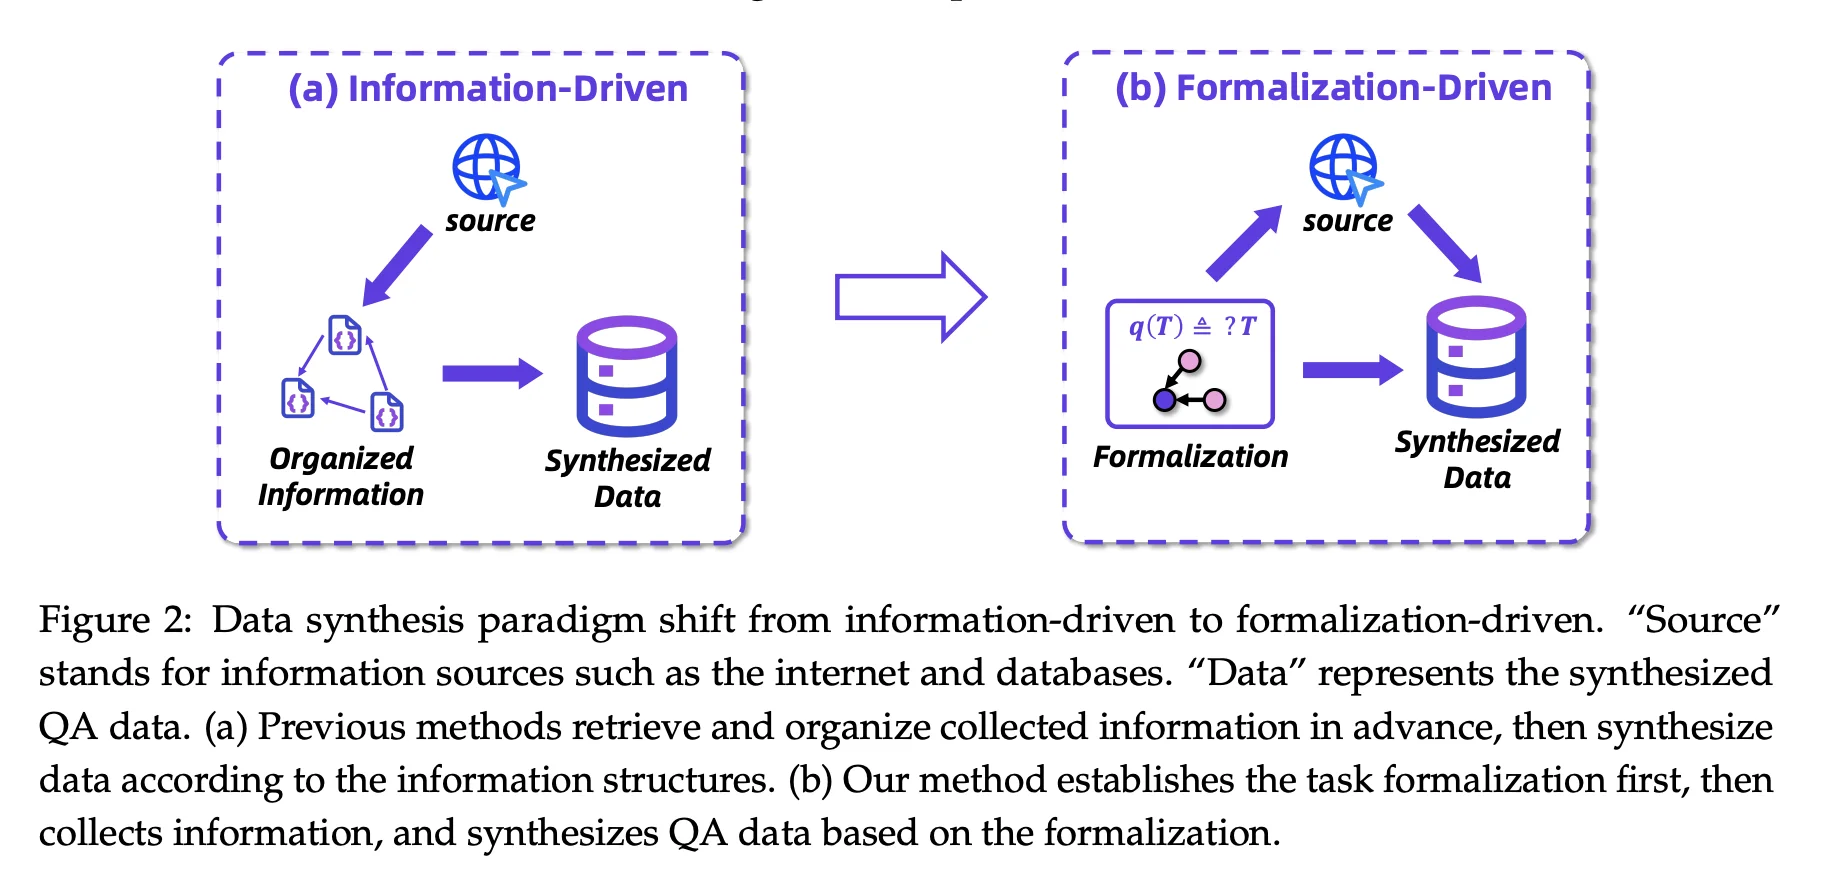
为此,WebShaper基于集合论提出了**知识投影(Knowledge Projections, KP)**的概念。
什么是KP? KP的本质是一个实体集合。这个集合里的所有实体,都通过一个特定的关系(R)与另一个已知实体集(V)相关联。例如,bornIn({90s}) 就是所有在90年代出生的人的集合;
同时KP定义了并集(∪)和交集(∩)来组合出更复杂的情况;如:
-
“寻找在2000年踢球并且出生于1990年代的球员” =
playAt({2000}) ∩ bornIn({1990年代}) -
“寻找在2004年或2005年效力于某支球队的球员” =
playAt({2004}) ∪ playAt({2005})
KP还支持递归构建,一个查询的条件(V)本身可以是另一个查询的结果
WebShaper 的数据合成流程
-
构建种子问题:通过在维基百科文章的链接网络上进行随机游走,收集大量相关联的文章内容,LLM基于这些内容生成一批初始的、相对简单的seeds,筛选,确保其质量和可解性
-
Agentic 扩展:
-
将形式化的任务结构(如
R1(T1) ∩ R2(T2))转换成一种 LLM 能理解的、基于三元组[变量, 关系, 变量/常量]的表示形式 -
对于一个已有的形式化问题,Expander Agent 会识别出其中的“叶子节点”
-
Expander 选取一个常量,通过调用工具(Search**、**Summarize、Validate)自主构建一个新的、更复杂的子问题,而这个子问题的答案恰好是原来的那个常量
-
将新生成的子问题替换掉原来的常量,从而使整个问题的推理链条变得更长、更复杂。这个过程可以迭代多次,以控制最终任务的难度
-
小结
从数据合成角度分析,能够看到思路的演化。
最初,难度被简单地等同于一个量化指标,即完成任务所需的点击次数或路径长度。然而,这种线性增加的路径可能依然由一系列简单的操作组成,并未触及更高级的认知挑战。也就是WebDancer中E2HQA方法的理念,通过增加迭代和约束增加推理长度。
WebSailor的工作标志着一个重要的转折点—问题难度并非来自路径的长度,而是来自信息的不确定性。通过构建复杂的知识图谱并对关键信息进行模糊化处理,agent不能再简单地沿着一条预设的路径前进,而必须在探索过程中维护多种可能性,对比和评估相互矛盾的证据,并最终综合出一个最可靠的结论。
WebShaper则更进一步,引入知识投影KP,从数学的角度给出形式化的描述,确保了每一个生成的任务都有可验证的逻辑基础,而不是随机的;同时难度也变得可量化,使得curriculum learning成为可能。
工程化优化
-
如何避免上下文爆炸:ReSum|IterResearch
-
如何让agent具备开放式报告撰写能力:WebWeaver
ReSum 与 IterResearch
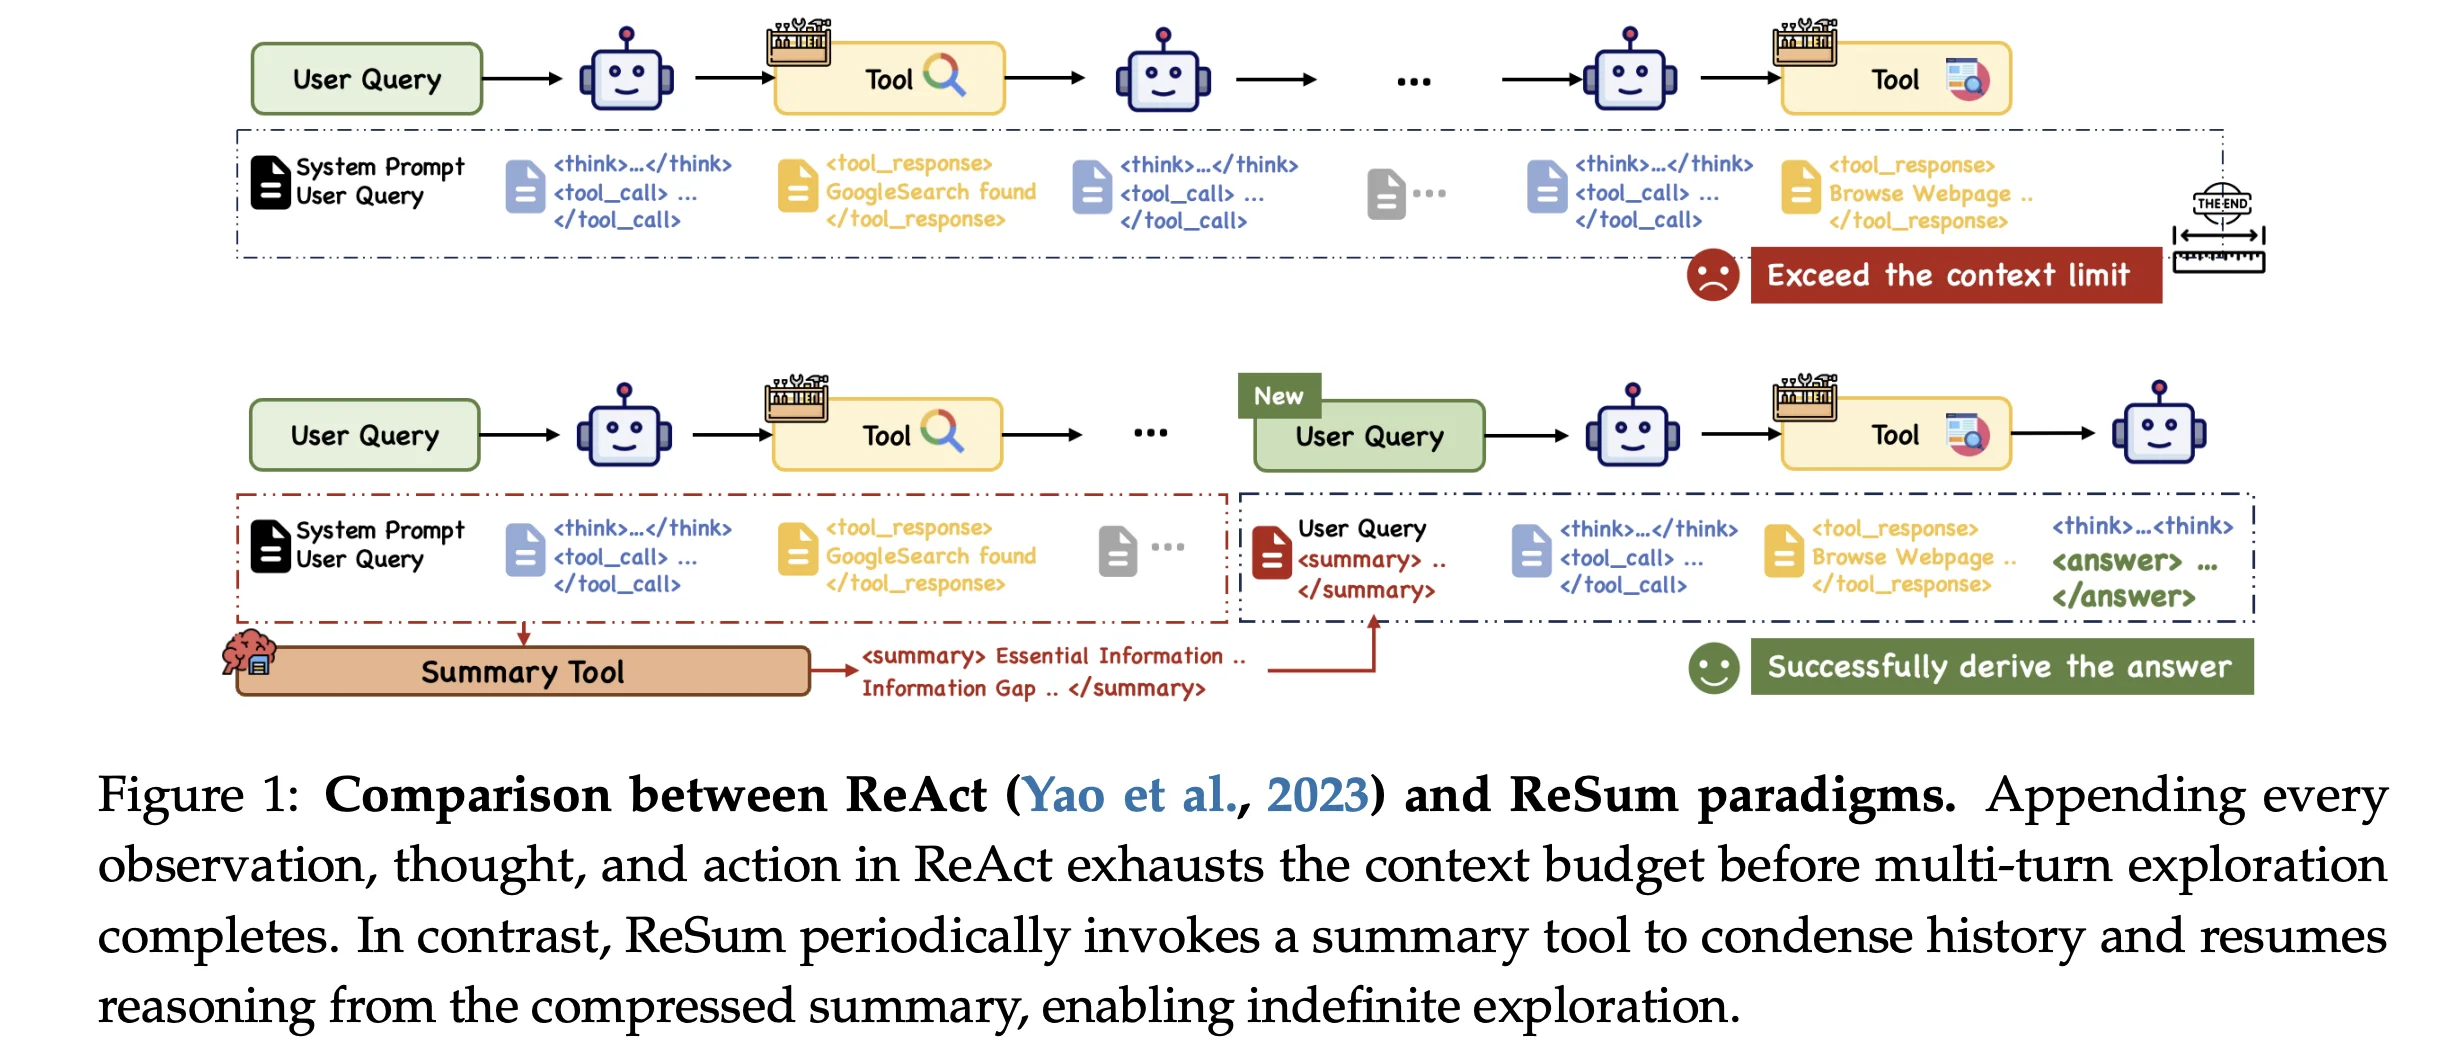
目前主流Agent采用的ReAct框架,会将每一轮的“think-action-observation”全部追加到上下文中。随着搜索轮次增加,上下文迅速膨胀,不仅超出模型上下文长度限制,累积的噪声还会干扰推理。
ReSum 的核心目标:通过周期性上下文压缩(摘要),让智能体在不丢失关键信息的前提下,突破上下文长度限制。
-
在 ReAct 基础上,周期性调用摘要工具,将历史对话压缩为结构化摘要(包含已确认证据 + 信息缺口 + 下一步方向),用摘要 + 原始问题组成“压缩状态”,重启推理,从而绕过上下文长度限制
-
不是直接用通用大模型做摘要,而是专门训练一个30B参数的模型
-
专门设计 ReSum-GRPO算法:自动将长轨迹按摘要点分段,每段作为独立训练样本,将整个轨迹的最终奖励(是否答对)广播到所有分段
相比ReSum的“压缩”,IterResearch更为彻底,将Deep Research建模为马尔可夫决策过程(MDP)。
在每一轮交互后,非简单地追加信息,而是重构其workspace,其中workspace只包含三个关键部分:原始问题、一个不断演进的**报告(evolving report)**作为记忆,以及上一步的直接交互上下文。
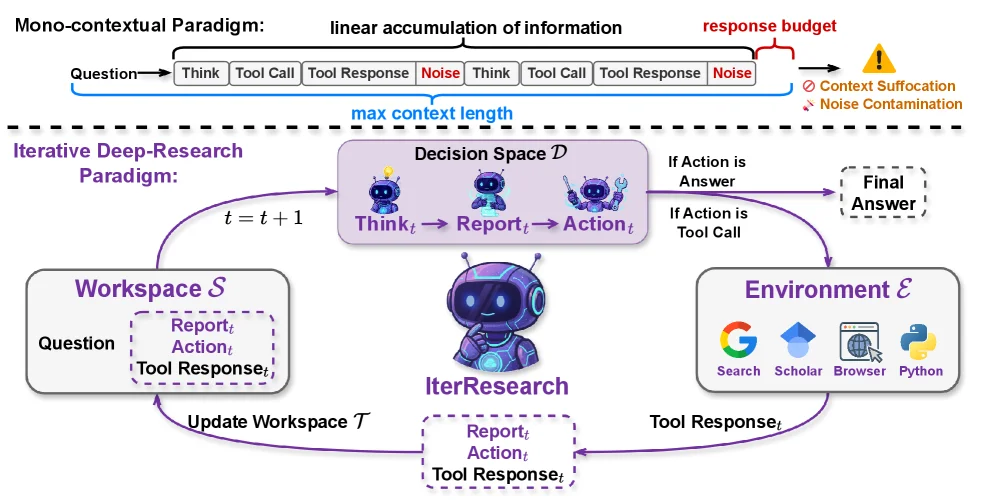
MDP:
-
State, S: 在第
t轮,状态s_t由三部分组成:{问题 q, 当前报告 M_t, 上一步的动作和工具响应 {a_{t-1}, TR_{t-1}}} -
Decision, D: 在每个状态
s_t,LLM生成一个结构化的决策d_t,包含三部分:{思考 (Think), 更新后的报告 (M_{t+1}), 下一步动作 (a_t)} -
Environment, E: 一系列工具,如谷歌搜索、谷歌学术、网页浏览器和Python解释器
-
Transition, T: 从
s_t到s_{t+1}的转移是重构而非累加。新的状态s_{t+1}由{问题 q, 智能体刚生成的更新报告 M_{t+1}, 当前动作和工具响应 {a_t, TR_t}}构成。历史信息通过M_{t+1}被压缩和提炼,旧的原始信息被丢弃。
两阶段训练:
-
SFT:用Qwen3-235B生成轨迹,教会30B模型这种迭代式思考格式
-
RL: 筛选出一批具有挑战性(成功率在20%-60%之间)的问题,采用GRSO,引入了基于轨迹长度的几何折扣奖励,鼓励模型学习更直接、更专注的解决路径。
WebWeaver
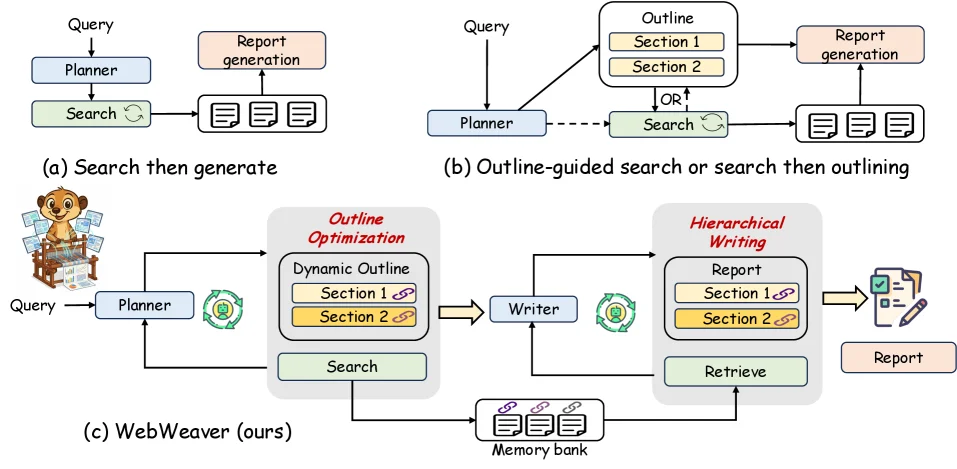
针对Open-Ended Deep Research (OEDR) 任务,即没有标准答案、需要自主生成长报告的场景,TDR提出了WebWeaver框架。
传统方法通常将“制定大纲”和“信息搜索”解耦,且一次性加载所有信息容易导致Lost-in-the-middle。WebWeaver的创新在于:
-
Dynamic Research Cycle: 不再采用静态的“规划-搜索”分离模式。新发现的证据会用来优化和扩展大纲,而优化后的大纲又会指导下一轮搜索。
-
Planner + Writer 双agent
Planner: 负责探索性研究。它在一个循环中不断通过Search工具获取URL、解析网页、提取详细证据并存入记忆库(分配唯一ID)。获取新证据后,Planner会重新审视并优化报告大纲(write_outline)
Writer: 负责报告合成。它按照大纲结构逐章生成。
首先根据大纲中的引用ID,从记忆库精确检索证据。(
retrieve);分析已写好的前文内容和新检索到的证据,形成一个连贯的写作思路(Think);基于思考结果,撰写当前章节的内容(write);完成一个章节后,用于该章节的证据会从上下文中移除,以保持上下文的简洁和高相关性,为写作下一章节做准备 (Pruning);当所有章节都完成后,writer执行
terminate,输出完整的报告
写在最后
一些思考:
-
工程化实现 vs. 训练内化 这并非非此即彼的选择,更多是基于场景和成本的权衡。 通用Agent目前仍难以通过训练实现,但在Web-Agent等垂直领域,通过训练让小参数模型(如30B)掌握特定工具的使用和特定格式输出,具有性价比;那么代价是什么呢?模型的泛化性会降低。TDR的成功很大程度上依赖于其预设的工具集,“TDR+预设工具”和“TDR+自定义工具”完全是两种不同的体验
-
mid-training | CPT 是否是必须的,业内暂时还没有共识,但显而易见的是,LLM必须经过针对多轮对话和工具调用的深度微调。如果缺乏这种专项训练,现阶段最稳妥的方案依然是使用最大参数量的基座模型来保证指令遵循能力。
-
个人认为TDR最值得借鉴是数据合成和工程化上的创新
参考
Tongyi DeepResearch Technical Report
附录:论文阅读笔记
WebWalker: Benchmarking LLMs in Web Traversal
https://arxiv.org/pdf/2501.07572
当前主流的检索增强生成(RAG)系统虽然能通过搜索引擎获取外部信息,但其检索方式通常是“横向搜索”(horizontal search),即在多个网页中找关键词匹配的内容,无法深入网站内部结构,难以处理需要“多层点击、多页面联动、深度推理”的复杂任务。
提出新任务:Web Traversal, 系统性地在网站内导航,挖掘深层信息,任务形式为QA
构建新基准:WebWalkerQA, 包含 680个高质量QA对,覆盖4个真实领域, 包含单源和多源 两种类型, 每个QA标注了深度、难度、路径
采用 “探索者(Explorer)+ 批判者(Critic)”双智能体架构: Explorer负责点击导航,Critic负责记忆和判断是否已收集足够信息
WebDancer
解决如何合成数据用于训练web-agent
现有的方法存在的问题:
-
数据质量和复杂性不足: “浅”问题,只需一两步搜索就能解决,高质量的复杂问答数据集数据量又太少
-
缺乏系统性构建方法
-
缺乏明确的训练方法
WebDancer 提出了一个四阶段的 cohesive paradigm, 将复杂的智能体构建过程分解为四个阶段:
-
第一步:高质量浏览数据构建
-
第二步:高质量轨迹采样
-
第三步:监督微调(SFT)进行有效冷启动
-
第四步:强化学习(RL)增强泛化能力
第一阶段:数据构建:
-
CRAWL QA:通过模拟人类浏览行为,从知识型网站(如维基、GitHub)上爬取多层页面信息,收集权威网站的根URL,程序化地点击链接、抓取子页面内容,然后使用GPT-4o根据收集到的信息生成需要整合多个页面信息才能回答的问题。
-
E2HQA (Easy-to-Hard QA):采用一种“由易到难”的逆向构建策略,将一个简单的问题通过迭代式地增加信息约束和子问题,逐步演化成一个复杂的多跳(multi-hop)问题; 具体而言,从一个简单问答开始,然后围绕答案实体搜索更多信息,并将这些信息改写成限定条件,融入原问题,使其变得更复杂。这个过程可以重复多次
第二阶段:轨迹采样
-
基于经典的ReAct框架, 只提供两个工具:
search(搜索)和visit(访问网页) -
使用GPT-4o(生成Short-CoT)和QwQ-Plus(生成Long-CoT)来解决第一阶段构建的QA问题,记录下完整的交互轨迹
-
轨迹筛选:符合ReAct格式,只保留最终答案正确的轨迹,通过规则和模型过滤掉存在幻觉、严重重复、逻辑不通的轨迹
第三阶段:Agent SFT
冷启动, 将筛选后的轨迹数据格式化为对话形式,包含think和工具调用标签,目的是让模型能够按照格式回答,为RL提供一个良好的初始模型。
计算损失时,屏蔽掉Observation部分,让模型专注于学习生成Thought和Action。
第四阶段: Agent RL
使用DAPO,采用SFT时未见过的数据进行rollout
Reward Design: score_format (权重0.1) 和score_answer (权重0.9,LLM-as-a-judge 评分)
WebSailor
WebSailor提出了一种基于知识图谱的高不确定性任务生成方法 (SailorFog-QA)
当前大多数训练数据都属于以下两类:
Level 1 任务:不确定性低,通过单次搜索或利用模型自身知识就能解决
Level 2 任务:初始不确定性高,但有清晰、结构化的解决路径(如标准的多跳问答)
真正需要且缺乏的**Level 3 任务:**不仅初始不确定性极高,而且没有预设的解决路径,需要智能体进行复杂的探索、推理和信息整合
SailorFog-QA: 通过在真实网站上进行随机游走,构建复杂的知识图谱,并从中采样拓扑结构多样的子图来生成问题。具体而言:
-
从一个模糊的实体(来自Wikidata)开始,通过模拟网页浏览(搜索、访问网页)进行随机游走,提取相关实体和关系,构建一个复杂的知识图谱
-
从图谱中随机采样一个子图,基于子图中的实体和关系,生成一个问题和答案
-
对问题中的关键信息进行模糊处理,增加其不确定性
而后采用一个推理模型回答SailorFog-QA的问题,生成完整的轨迹(Thought-Action-Observation),保留其中成功的Action-Observation,丢弃原始的Thought,并使用另一个模型为每一步重新生成简洁、精炼的Thought,形成最终的SFT数据。(这一步的原因是,直接用专家模型的COT进行SFT过于冗长)
训练阶段,依旧是两阶段:SFT冷启动+RL
Rejection Sampling,对轨迹进行过滤,只保留最终答案正确、长度在32k token以内、且工具调用次数超过5次的复杂轨迹
RL采用DUPO (Duplicating Sampling Policy Optimization):在训练前过滤掉过于简单的任务,然后在训练中,对于那些部分成功、部分失败的批次(通过随机复制批次内的有效样本来填满被过滤掉的空位。
WebShaper
https://arxiv.org/abs/2507.15061
提出了一种基于Formalization-Driven的数据合成方式。
主流的数据合成方法采用Information-Driven,即先从网络上搜集信息,然后基于这些信息生成问题,但会导致两个主要缺陷:生成的问题的推理结构可能与原始信息的组织结构不匹配(结构不一致) 和 生成的问题和对应的答案之间可能存在矛盾或错误 (答案不一致)
WebShaper 的数据合成范式,从“先有信息,再造问题”转变为“先定义问题的结构,再寻找信息填充”,基于集合论提出了知识投影的概念,为信息寻求任务建立了一套数学形式化语言,即;设计了一个名为 Expander 的自主智能体,用于系统性地将简单问题扩展为复杂问题;
Knowledge Projections, KP
核心思想:将一个复杂的信息查询问题,拆解成一系列基于集合论的“寻找实体集合”的操作
KP的本质是一个实体集合 。这个集合里的所有实体,都通过一个特定的关系 (Relation, R) 与另一个已知实体集 (V) 相关联,例如,bornIn({90s}) 就是所有在90年代出生的人的集合
定义了并集和交集两种操作来组合 KP; 如问题: “寻找在2000年踢球并且出生于1990年代的球员。”,则可以拆解成:第一个条件 “在2000年踢球” 可以构建一个KP playAt({2000})第二个条件 “出生于1990年代” 是另一个KP:bornIn({1990年代}),将这两个集合取交集,就得到了最终的目标集合:playAt({2000}) ∩ bornIn({1990年代})
或问题 “寻找在2004年或2005年效力于某支球队的球员。”,则KP写成:playAt({2004}) ∪ playAt({2005})。
除此之外,KP还支持递归构建,一个查询的条件(已知实体集V)本身可以是另一个查询的结果;对于问题 *“寻找一名球员,他所在的球队成立于1966年并且是一支东德球队,而他本人在2004-05赛季为该队效力,且出生于90年代。”,*第一层,先找出是哪支球队,T1 = foundIn({1966}) ∩ isA({East German football team})
第二层查询,寻找球员 T = playIn(T1) ∩ (playAt({2004}) ∪ playAt({2005})) ∩ bornIn({1990s})
WebShaper 的数据合成流程
-
构建种子问题:通过在维基百科文章的链接网络上进行随机游走,收集大量相关联的文章内容,LLM基于这些内容生成一批初始的、相对简单的seeds,筛选,确保其质量和可解性
-
Agentic 扩展:
-
将形式化的任务结构(如
R1(T1) ∩ R2(T2))转换成一种 LLM 能理解的、基于三元组[变量, 关系, 变量/常量]的表示形式 -
对于一个已有的形式化问题,Expander Agent 会识别出其中的“叶子节点”
-
Expander 选取一个常量,通过调用工具(Search**、**Summarize、Validate)自主构建一个新的、更复杂的子问题,而这个子问题的答案恰好是原来的那个常量
-
将新生成的子问题替换掉原来的常量,从而使整个问题的推理链条变得更长、更复杂。这个过程可以迭代多次,以控制最终任务的难度
-
-
agent训练
-
使用一个agent来解决这些新生成的复杂问题
-
记录下 Agent 解决问题的完整思考和行动轨迹(保留答案正确且合理的)
-
SFT冷启动+RL
-
ReSum
arXiv:2509.13313
ReAct会将每一轮的“思考-动作-观察”全部追加到上下文中,导致随着搜索轮次增加,上下文迅速膨胀,最终超出模型的上下文长度限制
ReSum 的核心目标:通过周期性上下文压缩(摘要),让智能体在不丢失关键信息的前提下,突破上下文长度限制。
创新点:
-
在 ReAct 基础上,周期性调用摘要工具,将历史对话压缩为结构化摘要(包含已确认证据 + 信息缺口 + 下一步方向),用摘要 + 原始问题组成“压缩状态”,重启推理,从而绕过上下文长度限制
-
不是直接用通用大模型做摘要,而是专门训练一个30B参数的模型
-
专门设计 ReSum-GRPO算法:自动将长轨迹按摘要点分段,每段作为独立训练样本,将整个轨迹的最终奖励(是否答对)广播到所有分段
IterResearch: Rethinking Long-Horizon Agents via Markovian State Reconstruction
https://arxiv.org/html/2511.07327v1
目前deep-research agent主流所采用的ReAct的框架,把所有历史信息、思考过程和工具调用结果不断累加到同一个上下文中,容易导致:
-
上下文爆炸
-
噪声干扰
提出**IterResearch,**用“周期性综合”和“策略性遗忘”取代“线性累积”
将deep-research 建模为马尔可夫决策过程(MDP),在每一轮交互后,非简单地追加信息,而是重构其workspace,其中workspace只包含三个关键部分:原始问题、一个不断演进的**报告(evolving report)**作为记忆,以及上一步的直接交互上下文
WebWeaver
https://arxiv.org/abs/2509.13312
Open-Ended Deep Research, OEDR 任务要求AI智能体在面对一个没有标准答案的开放性问题时,能够自主地从海量的网络信息中进行搜索、筛选、整合,并最终生成一份结构清晰、内容深刻、引用准确的深度研究报告
现有方法通常将制定大纲和信息搜索这两个阶段解耦,单向流程无法根据新发现动态调整研究方向, 同时,在写作阶段一次性加载至context中,容易造成lost-in-the-middle的问题
WebWeaver框架上的创新:
-
Dynamic Research Cycle,不再采用静态的“规划-搜索”分离模式,而是让大纲优化与信息搜索一同进行,新发现的证据会用来优化和扩展大纲,而优化后的大纲又会指导下一轮的搜索
-
双智能体设计, Planner 负责探索性研究阶段,最终产出一个带有精确引用的、结构完整的研究大纲; Writer负责报告合成阶段,依据规划器提供的大纲进行写作,逐个章节地写作
Planner
在一个循环中不断做出决策,提供三种工具:search, write_outline, terminate;
执行search时,返回URL、标题和摘要,Planner筛选相关URL,然后进一步解析网页,提取与查询相关的摘要和详细证据, 摘要被送回Planner上下文中, 详细证据被存入记忆库并分配一个唯一的ID
在获取新证据后,Planner会重新审视和优化报告大纲(write_outline)
Writer
按照大纲的结构,一个章节一个章节地生成报告
首先识别当前要写的章节,并根据大纲中为该章节提供的引用ID,从记忆库中精确检索出相关的证据(retrieve)
分析已写好的前文内容和新检索到的证据,形成一个连贯的写作思路(Think)
基于思考结果,撰写当前章节的内容(write)
完成一个章节后,用于该章节的证据会从上下文中移除,以保持上下文的简洁和高相关性,为写作下一章节做准备 (Pruning)
当所有章节都完成后,写作者执行 terminate 行动,输出完整的报告
WebWatcher
https://arxiv.org/abs/2508.05748
多模态深度研究设计的智能体框架
提出一个新的基准测试集BrowseComp-VL,和数据合成pipeline, QA-to-VQA转换pipeline 和自动化的轨迹生成与筛选
BrowseComp-VL 构建
在前作CRAWL-QA(WebDancer)基础上,加入WebSailor中采用的实体模糊化,构建出纯文本的QA数据
QA到VQA的转换,采用:
-
针对QA对中的核心实体,使用搜索引擎检索相关的真实网络图片
-
使用GPT-4o将原文本问题中的实体指代词改写为指向图片的描述,如“图片中的这个物体”
-
通过一个三阶段的筛选流程(包括Selector和Examiner),利用GPT-4o评估图片与问题的相关性、问题的清晰度以及答案的可验证性,确保最终生成的VQA数据质量
-
其中Selector包含两阶段,初步完整性检查和图文相关性评估;自动化检查包括检查问题是否被改写,检查实体是否被成功掩码 (实体是否被“图中的物体”之类代词取代);图文相关性评估阶段,将原始QA对+VQA问题+检索到的候选图像 给到GPT-4o,从三个角度评估(上下文对齐, 语义匹配 和视觉推理的合理性)
-
Examiner视觉可回答性验证,模拟了一个真实的VQA场景,以验证仅凭图像是否足以识别出问题的核心实体;在QA-to-VQA转换过程中,系统会为每个实体生成一个专门的“图像查询字符串”,如“图中的人物是谁?”,将字符串和图像给到GPT-4o做回答;如果GPT-4o无法根据提供的有限信息正确回答,被认为是“视觉基础薄弱”的,会被最终丢弃 (确保图像本身是自洽且信息丰富的)
WebWatcher Agent训练
-
配备了五种工具:Web Image Search;Web Text Search;Visit;Code Interpreter;OCR
-
使用GPT-4o为每个训练VQA样本生成解决问题的完整轨迹
-
保留那些最终答案正确、每一步逻辑一致且工具使用次数不少于三次的轨迹
-
训练阶段依旧是SFT冷启动加RL(GRPO)
AgentFounder
https://arxiv.org/abs/2509.13310
单纯使用Post-training训练Agent存在局限性,需要在post-training 前增加一步Agentic Continual Pre-training(CPT),以提升LLM在agent方面的基础能力(工具使用和推理能力)
提出两种无需真实调用外部API的数据合成方法:
-
First-order Action Synthesis, FAS : 从网页、文档中自动生成(问题-规划-行动)数据对;用于训练模型的初始规划和逻辑推理能力
-
Higher-order Action Synthesis, HAS: 将agent解决问题的轨迹,重塑为一系列的多步决策问题,通过在每一步生成多个备选方案,而非单一路径
第一阶段使用大量FAS数据和短的HAS数据在32K上下文中进行训练,初步建立智能体能力;
第二阶段则使用高质量的长HAS数据在128K长上下文中进行精调,提升模型处理长程、复杂任务的能力
WebSailor-V2
https://arxiv.org/abs/2509.13305
一个完整的agent post-training方案
数据构建创新:SailorFog-QA-V2
从种子实体出发,利用网络工具进行扩展,并特意建立节点间的密集连接和循环结构,使其更接近真实世界的知识网络,构建了一个comprehensive knowledge graph,密集的图结构以更好地模拟真实世界知识
由于图谱变得密集,放弃了计算量巨大的暴力枚举,转而采用基于“随机游走”(random-walk)的方法来高效地采样出结构多样的子图。
在生成问答任务时,系统性地将问题中的实体、日期、数值等关键信息替换为模糊的描述和范围,引入多种不确定性来生成需要复杂推理才能解决的QA pairs。
RL框架创新
创建了一个“模拟环境+真实环境”的双轨制训练框架
模拟环境基于离线的维基百科数据库从零开始构建,专门用于快速的算法实验和数据筛选;真实环境即可真实调用的API;
dual-environment RL framework
模拟环境: 基于一个**大规模的离线维基百科知识库,**还配备了“一套相应的网络工具”;用于快速迭代和算法验证
Real Environment: 与真实世界网络 API 相连接的训练设置,包括多个工具(search,visit,Google Scholar,Python interpreter);用于agent训练
AgentScaler
https://arxiv.org/abs/2509.13311
如何获得高质量agent 与环境交互的完整轨迹
提出:
-
可扩展的全模拟环境构建框架
-
**两阶段Agent学习策略:**通用领域提升工具调用和交互能力 + 垂直领域专门训练以提升具体场景能力
环境构建
-
收集了超过3万个来自真实世界的API,并对其进行清洗和标准化
-
将每个API视为图中的一个节点。通过计算API之间参数的相似性,来判断它们之间是否存在调用依赖关系,从而构建一个庞大的“工具依赖图”
-
使用社区发现算法(Louvain)对工具图进行聚类,将功能相近、依赖关系紧密的API划分到同一个Domain,
-
在每个领域内,根据所有工具的参数,自动生成一个该领域专属的Schema
-
将该领域内的每个工具都转换成可执行的Python代码,使其能够对这个数据库进行真实的读写操作
Agent Experience Learning
-
在特定领域的工具图中,通过遍历图来采样一条逻辑上连贯的工具调用序列。然后,为这个序列生成相应的参数和初始数据库状态,并将它们整合成一个高级的用户意图Intent
-
实例化一个“模拟用户”和一个“智能体”。模拟用户提出高级意图,智能体则需要通过多轮对话和工具调用来完成任务
-
智能体每次调用工具,都会在程序化实现的环境(数据库)中执行,并获得真实的返回结果。 . 整个交互过程被记录下来,形成一条原始的交互轨迹
-
轨迹过滤: format → 筛选数据库的最终状态与预设的golden状态完全一致的轨迹 → 工具调用序列和参数筛选
-
两阶段微调