写在前面
本文是前段时间部门内技术分享的文字稿整理;
主要包含2个方面:对于R1模型的简单科普,和开发团队的gen-AI使用指南;
原以为春节假期能稍作休整,未曾料想deepSeek-R1在春节期间引发行业关注。节后复工,各层级领导便密集展开AI技术进展问询。
原计划的"二月摸鱼指南"彻底落空,既要向管理层科普大语言模型技术原理,又要指正领导们被各种营销号洗脑所形成的错误认知;既要推进部门AI应用培训,又要加速系统上线进程;简直了,真是TM的谢谢 DeppSeek了。
About DS R1
什么是Reasoning model
何为推理(reasoning):是对信息进行处理和推断,形成判断或结论的过程;推理通常是一个包含多个推断步骤的过程。推理通常被认为需要抽象思维——也就是说,推理的能力不局限于具体的例子,而是更为普遍的。
In Thinking, Fast and Slow, Daniel Kahneman defined System 1 as the automatic, intuitive mode of thinking, and System 2 as the slower, more analytical mode. In the context of autoregressive language models, the usual inference process is akin to System 1 — models generate answers directly. Reasoning is System 2 thinking - models or systems takes time to deliberate to solve more complex problems.
LLMs本质上是一个根据上文预测下一个token的自回归模型,那么这样的模型是否具备逻辑推理能力呢?从表现特征来看,LLMs更类似于"文科生"的思维模式——在应对需要复杂推理的数学演算、自然科学问题解析及代码编写等场景时,其表现往往力不从心。
如何让模型的推理能力提升呢?CoT(Chain of Thought, Wei et al. 2022)即“思维链”,是一种使LLM“逐步思考”的方法。它通过要求模型展示解决问题的中间步骤来加强其逻辑推理能力,从而提高决策的质量和准确性。
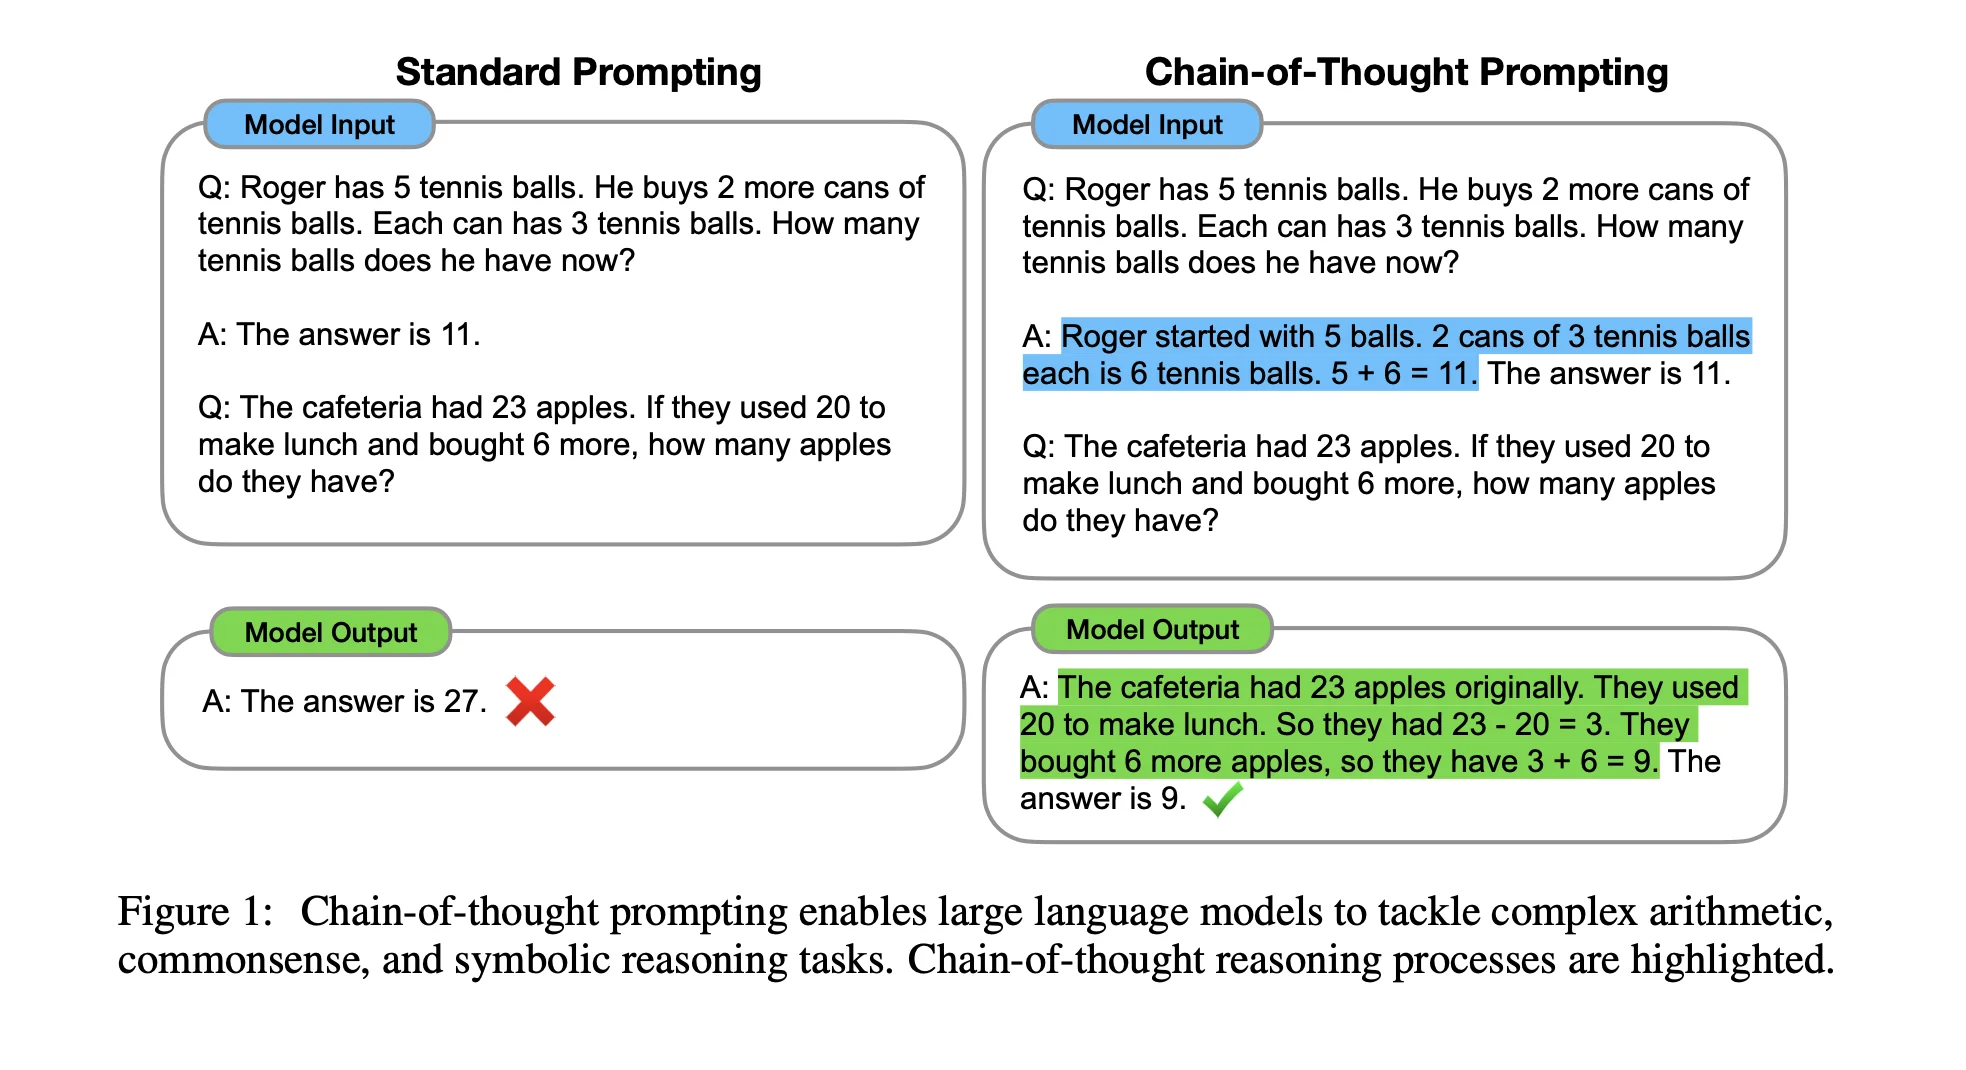
CoT更多是从prompting角度, 要求LLM以一定的格式进行回答(“think step by step”),模型对于没有在pre-training中涉及的内容时,效果并不太好,因为过去的LLM训练过程中, 不论是pre-training(预测下一个token)还是SFT(要求模型按照一定的格式输出),都与模型的reasoning 无关,CoT所所展示出的效果,及模型展现出的“推理”,更像是某种程度的“涌现”,而非专门针对性训练,当然也有认为LLMs似乎是在背答案而非真正的推理Can Large Language Models Reason?
自2024年9月后, OpenAI推出了 o-1 系列模型,也就是世界上第一个推理模型,同时也是第一个专门针对推理任务的模型, 只是“CloseAI” 所提供的信息非常有限, 并没有人知道其如何实现的,大家对其猜测五花八门。
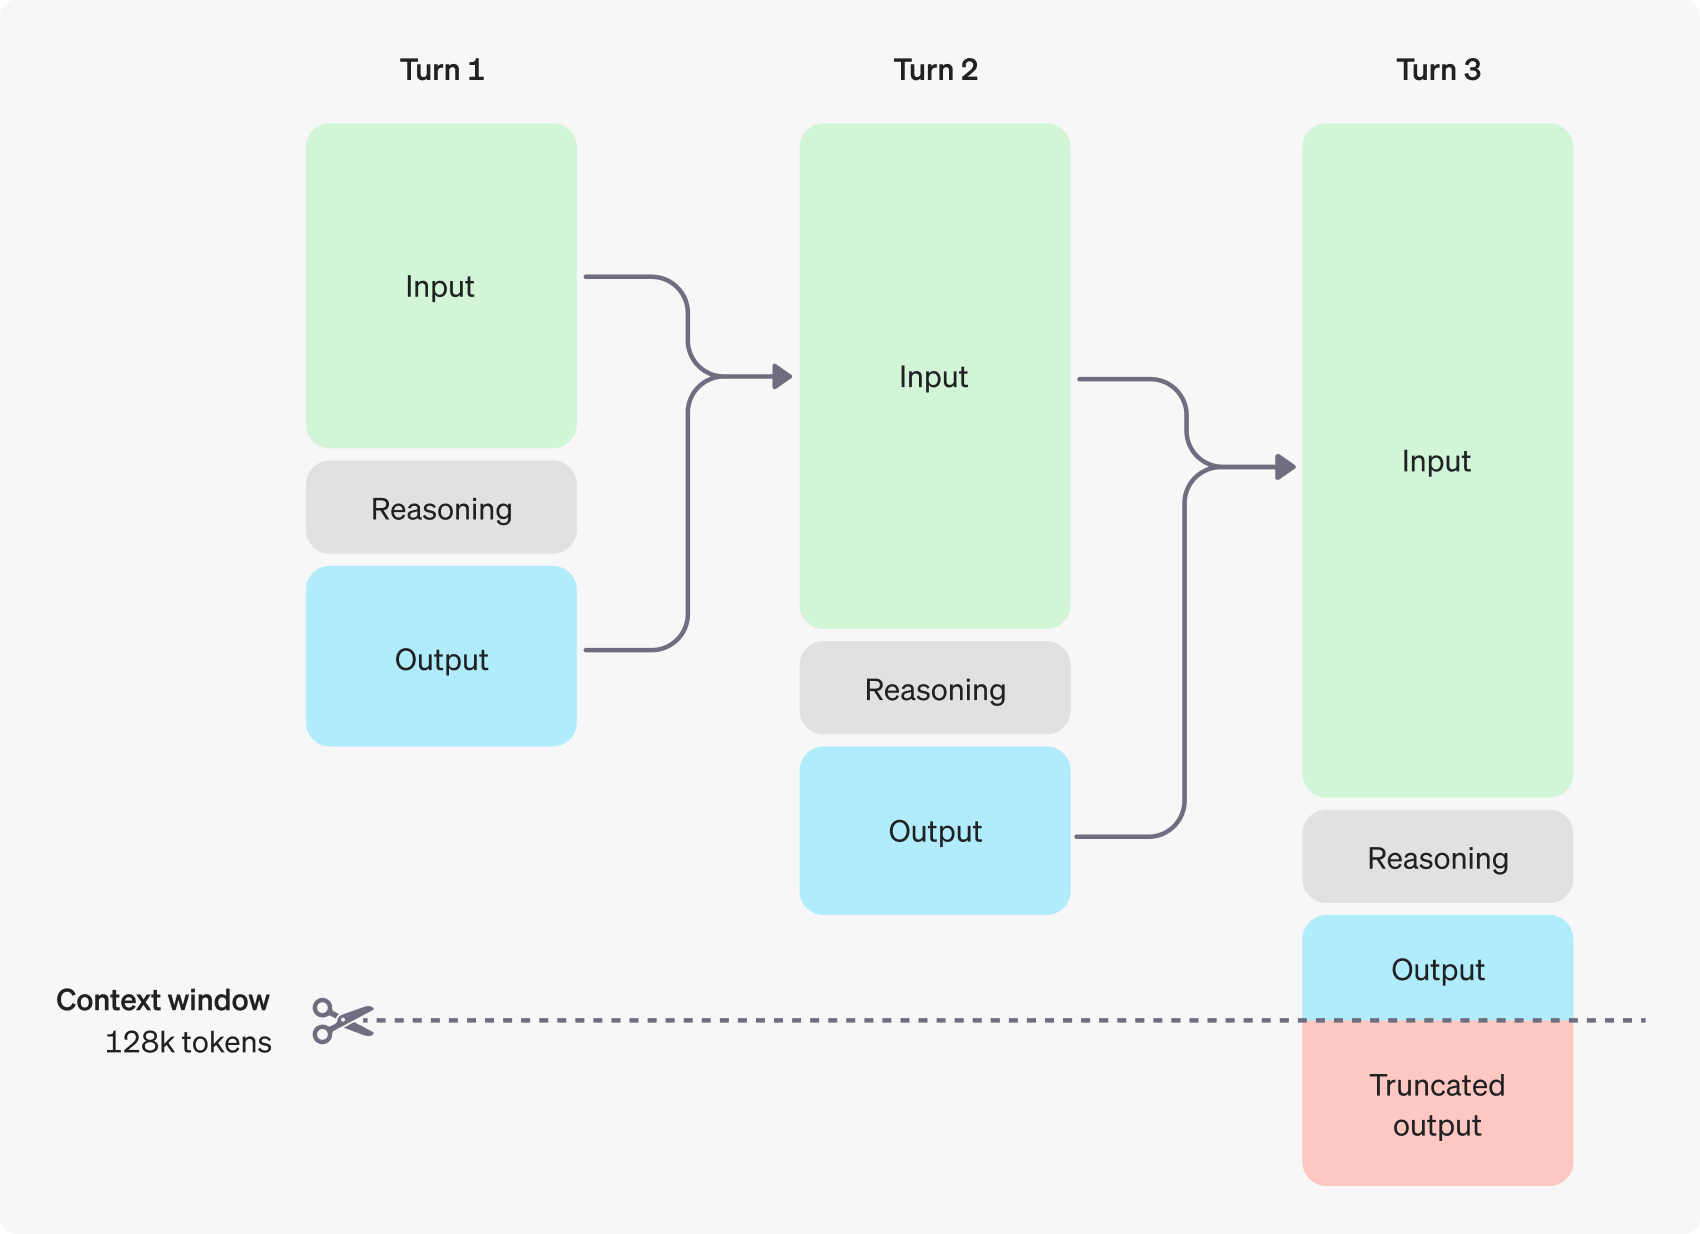
(from openAI)
这一切,直到DS R1的出现,才似乎尘埃落定。
DS R1做了什么
一切,从DS提供的论文出发。
主要贡献有3点:
-
如何通过纯RL训练提升模型的推理能力(DeepSeek-R1-Zero): 直接在基础模型(DeepSeek-V3-Base)上应用大规模RL,无需SFT作为预热,首次验证纯RL可激励LLM的推理能力,而非采用Reward model 或MCTS。
-
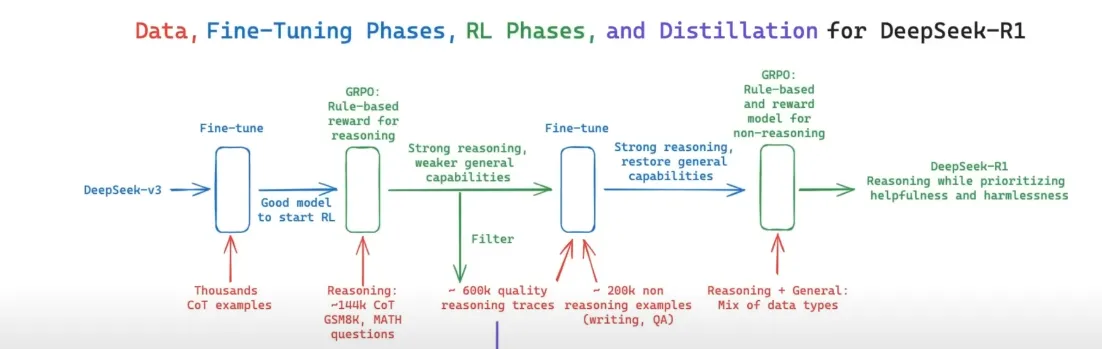
如何通过冷启动数据和多阶段训练优化模型的可读性和综合性能(DeepSeek-R1):引入少量冷启动数据(数千条长CoT示例)进行微调,再通过两阶段RL(推理优化+人类偏好对齐)和SFT提升性能与可读性
-
如何将大模型的推理能力高效迁移到小模型: 将大模型(DeepSeek-R1)生成的80万条数据蒸馏到小模型(如Qwen、Llama系列),显著提升小模型推理能力,甚至超越直接对小模型应用RL的效果
具体而言,对于DeepSeek-R1-Zero,采用了GRPO(Group Relative Policy Optimization,正是DS团队在其另一篇工作DeepSeekMath中所开发的方法),不同于PPO,GRPO无需critic model,降低的显存使用,同时更简化训练过程也让训练过程更高效和稳定。
此外, 采用FP8(8位浮点数)精度进行训练,也降低了显存占用。
在奖励机制设计上,采用了rule-based的设计,兼顾Accuracy reward(正确的coding或数学推理结果)与Format rewards(遵循指定输出格式,语言一致性、标记使用等)。
通过强制模型输出结构化内容(如
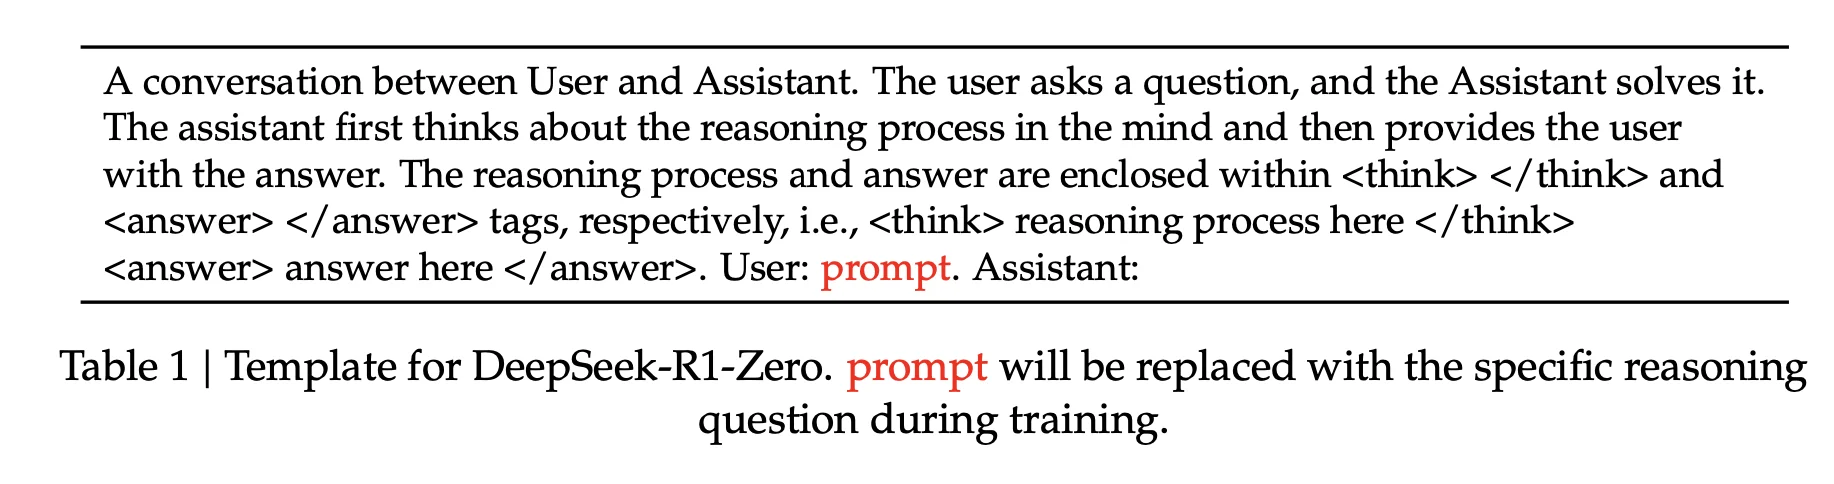
DeepSeek-R1-Zero 因采用base-model RL获得,存在Language Mixing ,以及可读性差,对特定任务泛化能力差(因训练目标单一)等问题
DeepSeek-R1为了解决以上问题:
→ 引入了语言一致性奖励
→ 使用从RL阶段生成的checkpoint,通过拒绝采样来筛选出高质量的推理样本
大致流程:
SFT(用高质量COT启动RL,以避免早期不稳定性) → 推理强化学习 → SFT(推理+通用领域数据) → 对齐强化学习
同时, 将DeepSeek-R1生成的80万条数据用于微调小模型,小模型直接继承大模型的推理模式,性能远超直接对小模型应用RL。
意义和需要澄清的内容
从意义上讲,这是首个在推理能力上与OpenAI o1系列商业模型达到同等水平的开源模型(开源模型权重和公开部分训练细节);同时,个人认为R1-zero的意义会比R1来的更加重要,因为其完全是基于rule-base RL训练的reasoning 模型, 具备了自我纠错反思的“aha moment“,为开源社区探明了道路,而不是遮遮掩掩的(说的就是你__);此外, 对于小模型直接用大模型蒸馏从而提升reasoning能力,而不是直接在小模型上RL,为资源受限场景下的模型优化提供了极具参考价值的技术路径。
一些需要澄清的点:
-
Nvidia股价大跌,不需要Nvidia了吗:从模型推理的角度,可能有其他的选择,但对于开发运维人员角度,因其生态位和开源社群,Nvidia依旧是首选;训练方面依旧是不可撼动的;
-
DS是通过chatGPT蒸馏出来的?:并没有证据能够证明这一点,任何模型对于“自己是谁”的回答都是不具备任何参考价值的,往往都是幻觉。
-
赢?不太希望将这件事上升到这样的高度,保持理智,不要捧杀DS,AGI的路还挺长的,任何看完之后心潮澎湃的文章多半都是新闻学的胜利和对于民族主义情绪之利用;但必须承认一点,无论是中美,还是开源闭源的差距都没有想象中的大,似乎差距正在不断缩小。
-
**教你本地部署满血版DS-R1?只要99入门到精通?少焦虑,多接触优质信息源,如Twitter(X)上一线研究员的发言讨论和TA们的blog,huggingface上的论文推荐,以及更新:2024年AI领域最值得关注的博主和一手信息源盘点;对于DS- R1所需要的推理硬件参数会在后面专门聊,这里先不展开了。
泼一些冷水
DS R1的幻觉挺严重的,不论是使用体验上,还是从Vectara’s HHEM的幻觉评测指标上看。
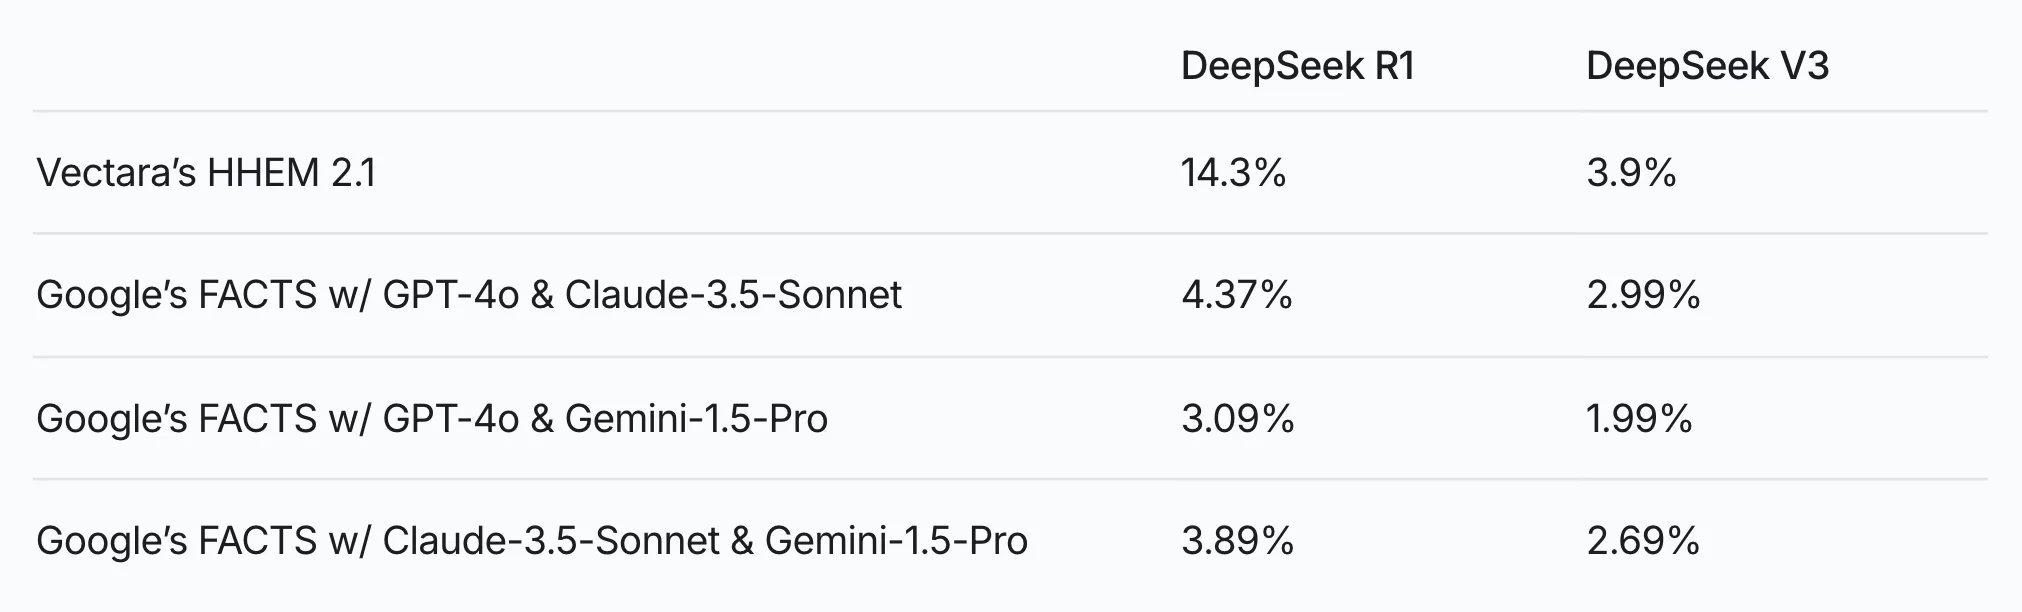
(from DeepSeek-R1 hallucinates more than DeepSeek-V3)
对齐不足。从现有的工作和实际效果上来看,DS在模型的对齐方面做的可能还不够。当然,这是把双刃剑,没有了限制,使其表现的更像人类的回答而不是AI,甚至有些细思极恐的回答,于是DS能够火出圈。关于reasoning model的安全性和对齐方面工作,大家也都还在摸索阶段,可以参考OpenAI的Deliberative Alignment 相关工作。
R1解题coding可以,但follow-instruction 有点问题; 于是,更多是将R1作为planner用于任务规划和意图识别,从成本上考虑,短期不会替换之前的workflow和RAG设计,当然长期来看,一定会有超出workflow范畴的真正agent出现。
DS R1所带来的影响
-
更高的回答准确率,代码质量等
-
大大降低prompting的门槛,用户意图识别效果更好(如果不考虑成本的话)
-
给推理模型加上工具调用,而不仅仅是思考(这不就有deep research出现了嘛)
-
指明了RL范式:只要给问题和答案, 中间过程交给RL,大力飞砖
相关资料汇总
技术报告:https://arxiv.org/abs/2501.12948
Huggingface:https://huggingface.co/deepseek-ai/DeepSeek-R1
一些关于R1的开源复刻工作&信息汇总:
-
RAGEN: RAGEN: A General-Purpose Reasoning Agent Training Framework
-
Open Thoughts: https://github.com/open-thoughts/open-thoughts?tab=readme-ov-file
-
https://xcn2d971vuw4.feishu.cn/wiki/RaC2w1iiFijAa1kVJUjcp3agn8e
开发团队的Gen-AI使用指南
这是一些关于一个开发团队如何使用,和高效使用Gen-AI的不完全指南
大体而言, 开发者使用AI通常有以下几个场景:
-
高质量,有效率的coding
-
完善的开发文档,设计文档,测试用例
-
快速完成想法验证
当然,一切的前提是,你有LLM可用
Prerequisite:模型API服务
当下模型服务有两大类 付费LLM-API 和基于本地私有化部署的方案(基于CPU或基于GPU)
采用在互联网上模型服务商所提供的模型API服务(如openAI,等),该方案适合绝大多数开发者,毕竟好的硬件设备并不是所有人都负担的起,其次,对于数据隐私有执念的,或是有足够硬件设备者,可以尝试采用本地模型部署,但由于本地硬件条件有限,一般只能部署开源的,参数量不大的模型;
具体而言,对于绝大多数模型服务商提供的模型服务,一般都支持统一的openAI chat-completion API 格式,支持tool-using,多模态使用,均可以使用openAI client调用;这对于Gen-AI应用开发而言是非常方便的事情,切换模型供应商唯一需要修改的只有API-KEY和BASE_URL;
而模型服务商又可分为3大类(或者更多?)
-
闭源模型的API服务(openAI,Anthropic)
-
开源模型的Maas 服务商 (Groq,SiliconFlow和各大云厂商)
-
LLM-API 聚合平台 (OpenRouter)
以下是整理的常见模型服务商:
| 分类 | 服务商 | 说明 | 链接 |
|---|---|---|---|
| 官方版本(数据安全) | OpenAI | o3 系列(推理模型适合用于 bug 和问题分析)o1 系列,GPT-4o | - |
| Anthropic | Claude-3.5-Sonnet(代码质量高) | Anthropic | |
| Azure OpenAI | 已停止对境内个人开发者开放服务,需要同合作伙伴商公对公签合同 | - | |
| Gemini | 提供一定的免费额度可使用 | Gemini | |
| DeepSeek | DS R1(个人信息认证后可使用,貌似还未恢复服务) | DeepSeek | |
| 阿里云 | Qwen2.5-max | 阿里云 | |
| Maas 服务商 | Groq | 速度飞快,开源模型 | Groq |
| SiliconFlow | 国内的 Maas 服务商,支持大多数开源模型 | SiliconFlow | |
| 非官方 API 聚合平台 | OpenRouter | 最大的 API 聚合平台之一,支持市面上绝大多数模型服务(安全性、隐私性需自行考虑) | OpenRouter |
Prerequisite:私有化部署
对于本地推理方案,推荐 ollama (cpu)和vllm,sglang (GPU);
ollama:https://ollama.com/;
vllm:https://docs.vllm.ai/en/latest/getting_started/quickstart.html
sglang:https://github.com/sgl-project/sglang
不过在采用私有化部署之前,需要确认的一件事是:判断硬件所支持的最大参数量模型?
LLM推理时,显存占用来源有:推理精度,模型大小,context长度
简化计算:在FP16精度推理时,显存占用约为模型参数量的2倍(考虑中间激活值后可能接近2.5倍)。例如,7B参数的模型,纯参数显存占用约14GB(7B×2bytes),实际使用中因激活值等开销可能达到14-17GB;若采用int8量化,参数显存可减半。
推荐:分析transformer模型的参数量、计算量、中间激活、KV cache
此外,还需要搞清楚有哪些模型是DeepSeek R1?所谓满血版R1指的是谁?
从DS在HF的官方仓库可以看到:
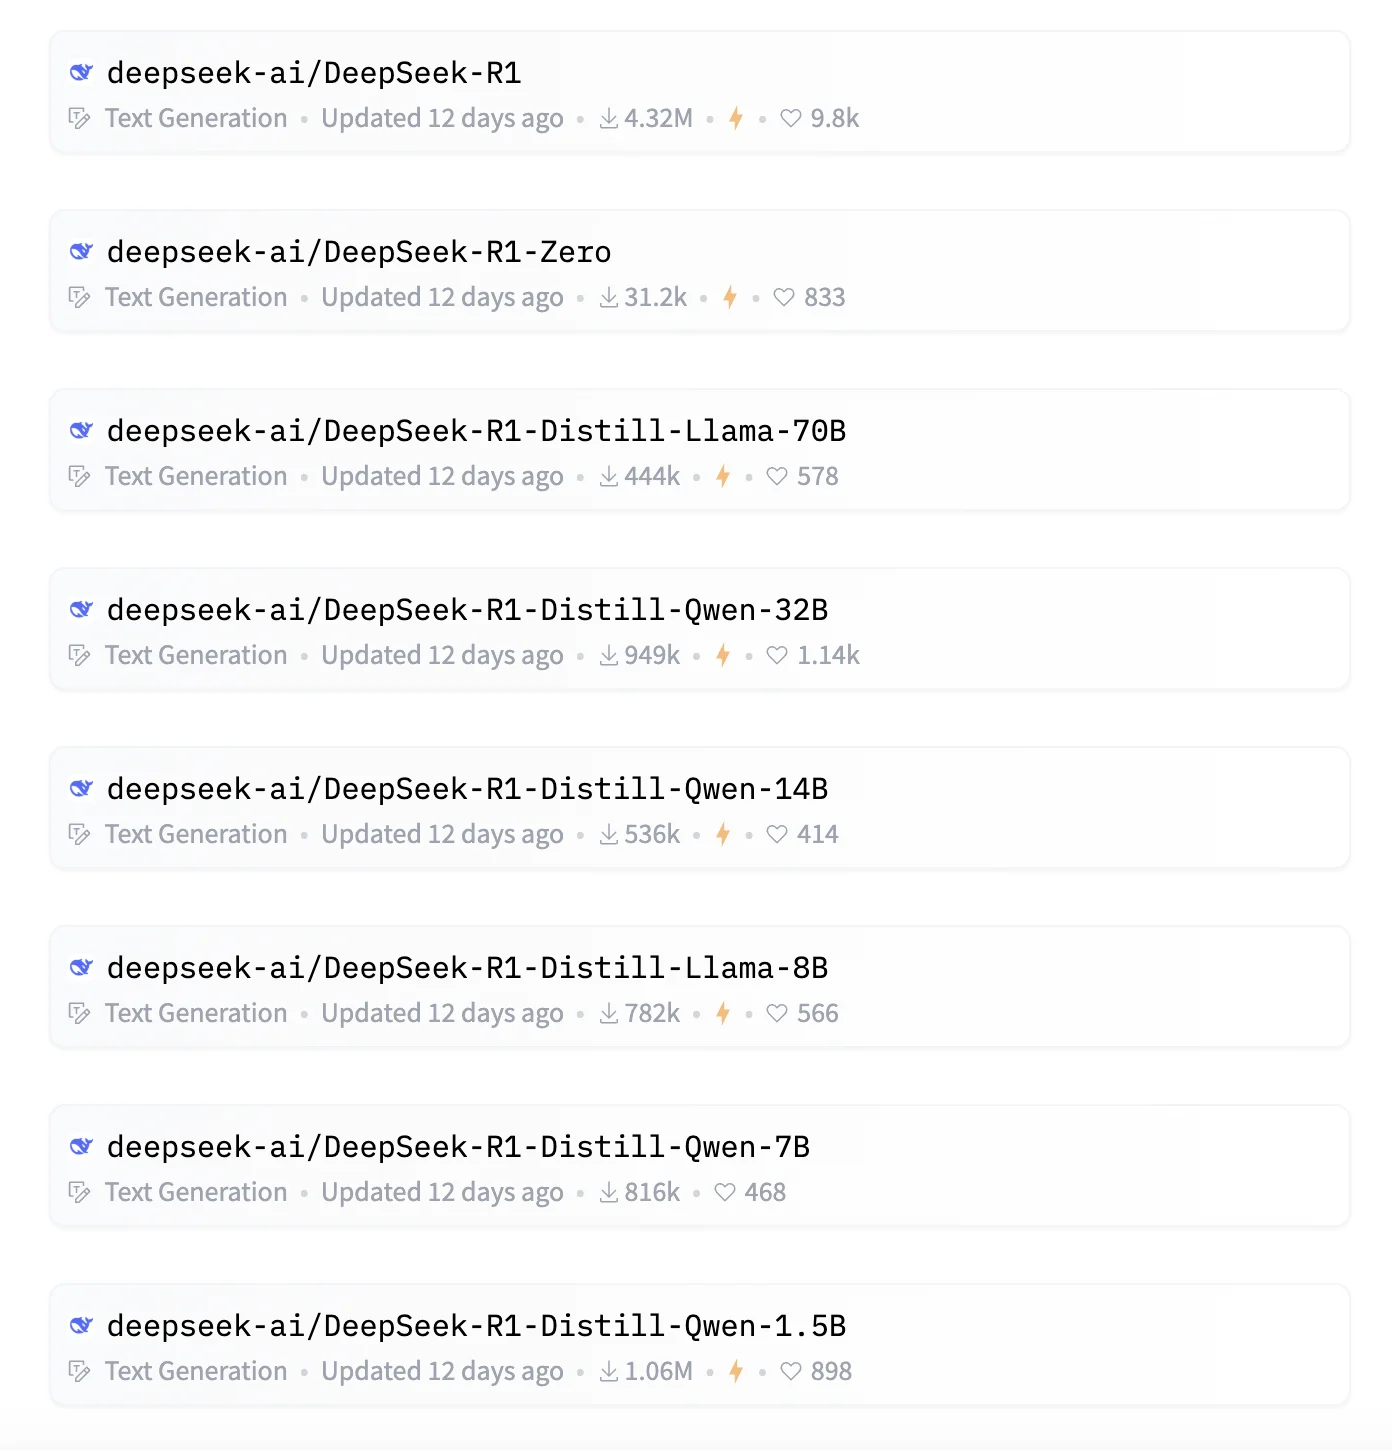
满血版本指的是FP16精度下推理的DeepSeek-R1
剩下的除了R1-zero是实验产物外,剩下都是通过R1在不同参数量的Qwen和Llama上蒸馏出来的reasoning模型;
对于满血版本,在FP16上推理,至少需要两台8卡H20服务器
而GGUF、AWQ、GPTQ 等则是适用于不同设备、不同框架的量化版本权重(Quantization)
以Ollama为例,在mac M3电脑上启动 DS-R1 14B的蒸馏模型
ollama run deepseek-r1:14b
这里选择的原始模型是deepseek-ai/DeepSeek-R1-Distill-Qwen-14B
不过是基于GGUF的Q4_K 版本,需要至少9GB的内存;
基于本地ollama启动的deepseek R1(蒸馏版本)对话:
from openai import OpenAI

client = OpenAI(
    base_url = 'http://localhost:11434/v1',
    api_key='ollama', # required, but unused
)

response = client.chat.completions.create(
  model="deepseek-r1:14b",
  messages=[
    {"role": "system", "content": "You are a helpful assistant."},
    {"role": "user", "content": "Who won the world series in 2020?"}
  ]
)
print(response.choices[0].message.content)
若采用vllm在GPU上推理模型时,需要额外增加参数--enable-reasoning --reasoning-parser deepseek_r1来支持R1 系列模型的Reasoning Outputs。
一些支持自定义API的chatbot UI工具:
-
openChat
-
…
常见的AI-coding 编辑器
代码自动补全,基于代码对话,自动错误识别,项目级别代码阅读和修改,代码建议
| 工具名称 | 功能概览 | 主要特点 | 收费情况 | 开源情况 |
|---|---|---|---|---|
| Cursor AI | 基于VS Code的AI编辑器,集成GPT-4、Claude 3.5等模型 | 多行编辑与智能重写、自然语言编程、全局代码库问答、图像支持等 | 免费版、Pro版(20美元/月)、Business版(40美元/用户/月),额外收费(按次计费) | 客户端非完全开源,旧版本部分代码可见,依赖专有AI模型 |
| GitHub Copilot | 代码补全、PR支持、智能聊天、企业级功能(知识库集成、定制模型) | 支持多IDE、跨文件修改、Copilot Chat、PR生成等 | 免费版、Pro版(10美元/月)、Business版(19美元/用户/月)、Enterprise版(39美元/用户/月) | 非开源,提供FauxPilot、Tabby等开源替代方案 |
| Codeium | AI代码补全、上下文感知、多语言支持、智能聊天 | 支持40+开发环境、GPT-4优化、隐私与安全保障 | 免费版、团队版(12美元/用户/月)、企业版(定制化定价) | 部分IDE插件开源(MIT协议),核心服务闭源 |
| Continue | 代码补全、上下文感知聊天、代码重写、自定义模型集成 | 本地部署方案、低延迟、隐私保护、多语言支持 | 基础功能免费,企业版定制化定价(需联系销售) | 开源,Apache 2.0协议,支持自定义模型接入 |
| Cline | 支持多模型、终端命令执行、浏览器自动化、智能上下文管理 | 支持本地模型、API成本监控、沙盒安全机制、跨平台开发 | 开源(Apache 2.0协议),API成本自行承担,企业版(79美元/月起) | 完全开源,Apache 2.0协议,支持自定义工具服务器(GitHub) |
| TabbyML | 本地化代码补全、问答引擎、AI实时交互 | 本地部署、支持多语言和IDE插件,定制化模型集成和GPU部署 | 社区版免费、团队版(19美元/用户/月)、企业版定制化计费 | 完全开源,Apache 2.0协议,支持自定义模型集成与本地GPU部署 |
| Windsurf | Cascade Flow系统、多文件编辑、智能代码辅助、终端指令生成 | AI代理、上下文感知、Supercomplete预测、实时错误修复、隐私保护 | 免费版、Pro版(15美元/月)、Pro Ultimate版(60美元/月);新用户可免费试用2个月 | 当前版本未开源,基于VS Code架构,核心AI功能为闭源实现 |
一些推荐阅读:
AI Coding 编辑器没有那么神秘 - How Cline works
如何Coding with AI:正确打开方式
如何使用AI,方法论比工具重要
The reality is that AI is like having a very eager junior developer on your team. … The more you know, the better you can guide them.
I’ve watched senior engineers use AI to: Rapidly prototype ideas they already understandGenerate basic implementations they can then refineExplore alternative approaches to known problemsAutomate routine coding tasks … Meanwhile, juniors often: Accept incorrect or outdated solutionsMiss critical security and performance considerationsStruggle to debug AI-generated codeBuild fragile systems they don’t fully understand
(from How AI-assisted coding will change software engineering: hard truths)
Senior 工程师更能从AI 辅助编程中获益,而非初学者。
Senior 工程师能够判断AI的结果是否正确,和更加有针对性的提问,从而更好的发挥出AI的作用
最重要的是,senior工程师更多是利用AI作头脑风暴和原型验证,在1小时内完成过去3天的原型验证,从而大大减少走弯路的时间;这种"加速已知,探索可能"的范式转变,正在重构传统研发流程的边界
相反的,Junior工程师往往无法很好的判断AI给出的代码是否正确或者何时,往往只是AI代码的搬运工,同时,往往无法很好的向AI进行提问
再者,开发工程师的工作不只是开发,约占1/6左右,剩下还有大量的撰写文档、设计、沟通交流、看文档、code review等,AI虽然可以帮助完成部分简单和重复的任务,很显然,AI远没有达到替代人的程度,至少是当下,AI仍然需要人类的指导和判断。
只是当下,对于Junior工程师的培养将会是个问题。
My beehive-kicking post’s main premise is pretty simple and can be visualized in terms of two different kinds of task that arise on software projects.
We often give these leaf node tasks to junior developers because the scope is small. … LLMs can now execute most of the leaf tasks and even some higher-level interior tasks … Which are not the kind of task that you typically give junior developers. … Junior devs are deeply affected, though, and it’s a concern.
You are getting left behind if you do not adopt chat-based programming as your primary modality.
(from The Death of the Stubborn Developer)
过去培养新人时,通常安排其承担简单且独立的"leaf node"任务,通过项目实践积累经验,实现能力提升。然而,随着AI技术普及,这些基础任务已可被高效且精准地完成,新人面临的处境变得愈发尴尬,失去通过基础任务积累系统认知的机会。
当前企业面临双重挑战,既要维持业务效率,又需保障工程师培养体系的可持续性,二者并非绝对对立,但需重新设计技术成长阶梯以实现平衡。
技术债管理能力正成为团队竞争力的关键分水岭。AI技术将加剧低技术债务团队与高技术债务团队间的马太效应。
that generative AI dramatically widens the gap in velocity between ‘low-debt’ coding and ‘high-debt’ coding.
In other words, the penalty for having a ‘high-debt’ codebase is now larger than ever.
However, in ‘high-debt’ environments with subtle control flow, long-range dependencies, and unexpected patterns, they struggle to generate a useful response.
Day-to-day feature work should then be done on top of this foundation with maximum leverage from generative AI tooling.
(from AI Makes Tech Debt More Expensive)
-
高技术债务团队因代码结构混乱、模式不统一(如多重继承滥用、接口定义缺失),导致AI难以有效解析上下文逻辑。开发人员不得不耗费大量精力处理历史遗留问题(如兼容性适配、脆弱性修补),形成技术维护的恶性循环。
-
低技术债务团队凭借清晰的架构设计(模块化、标准化接口),使AI辅助开发工具能准确识别代码意图,快速完成功能扩展与问题定位。这种优势使其可将资源集中投入创新性工作,形成技术演进的正向循环。
个人的一些建议:
-
明确LLM的认知边界,用结构化指令替代模糊需求
-
用生成结果反推思维盲区,意识到想法中的不足之处(stay humble)
-
对存疑输出实施交叉验证,批判性接受
-
新人学习策略:利用AI工具学习代码而不是复制代码,多追问为什么
在未来,人机协同范式将重塑人才能力评价体系,一些核心素养将成为关键竞争力。
重中之重是语言表达和写作能力。从当前实践和身边的例子中,发现一个典型困境:诸多理工科从业者虽具备缜密的逻辑分析能力,却难以将复杂需求转化为精准的指令表述。这种表达能力缺失导致其在使用生成式AI时频繁遭遇预期偏差,既影响工作效率,又易形成对技术效能的误判。或许这已经是这个社会的通病了。即便是具有一定“读心”能力的R1模型出现,Gen-AI的使用依旧还是有一定门槛的。
再者,批判性思维的培养也非常重要;当前Gen-AI使用者呈现明显的认知极化现象:部分因遭遇AI失误而全盘否定其应用价值,表现为技术抗拒倾向;另一极端则对AI输出盲目采信,缺乏基本的内容鉴别能力。真正科学的态度应当是在理解AI能力边界的基础上,合理利用其优势,同时保持独立思考和批判性判断。这正是批判性思维的核心价值所在——面对AI生成内容时,能够主动分析、质疑、验证信息的真实性和可靠性,从而在技术应用中保持理性、客观的态度。
除此之外,并不需要去害怕和担心AI取代人,开发者群体应建立正确的工具认知:编程能力本质上是解决问题的工具而非目的本身。AI作为效率倍增器,其价值在于辅助人类突破效率边界。真正需要持续积累的是问题抽象能力、解决方案架构能力以及行业专有知识库——这些通过实践沉淀的思维链(CoT)构成了人类认知的护城河,是当前AI技术难以企及的领域。保持开放的技术观,聚焦能力提升而非技术替代焦虑,避免因FOMO(Fear of missing out)而被人割韭菜。
AI赋能的超级个体正在重构生产组织方式。在过去,企业依赖层级架构,和明确的分工,随着AI工具的广泛应用, 个体的生产力得到了指数级提升,许多过去需要团队协作才能完成的任务,如今单个个体借助AI即可高效完成。这种能力的跃迁,使得传统组织架构的效率优势逐渐被削弱,甚至在某些场景下变得冗余。在这种背景下,生产力关系的重构成为必然趋势。组织形态向更加扁平化、小型化的方向演进,扁平化意味着组织内部的决策链条缩短,信息流转更加高效,个体拥有更大的自主权和决策空间,而非将大量时间用于无效的沟通上。未来,个人或小型团队借助AI工具,可以像过去的大型企业一样高效运作,甚至在某些领域超越传统组织的效率。
一些补充
领域Benchmark构建非常重要。当前针对法律、医疗等垂直领域已形成专业评估体系,但多数行业仍缺乏系统的LLM评估标准,导致在模型选型时过度依赖个体经验判断。
重新审视专业壁垒:预训练模型可能已覆盖领域基础知识体系,现存"专业门槛"或存在人为构建的术语壁垒;领域内高质量的CoT数据,思考方式才是关键
随着LLM能力的提升,过去我们精心设计的许多工程方案可能会变得不再必要,甚至过时。不断学习和适应,不要固步自封,技术迭代是以天为单位的;拥抱和参与开源,而不是技术封建主义。
LLM reasoning 能力提升后,短期内,RAG,Agent, workflow不会有太大变化
Post-training很重要
同时间段开源的Qwen/Qwen2.5-VL-72B-Instruct 也值得关注