写在前面
决定开启一个新系列,是时候系统性地学习一下 Alignment、RLHF 等相关内容了。
学习过程中,经常会在一些公式推导上卡住,可能是因为之前的基础不够扎实,加上学过的内容遗忘较多。 于是,希望通过这一系列的笔记,帮助自己系统地回顾RL、和学习RLHF等内容。(顺带把之前手写的笔记电子化)
主要的教材来自:
-
B站UP主 shuhuai008 的系列推导视频
本篇笔记将包含以下的内容:
-
MDP
-
DP
-
Monte Carlo Methods
-
TD方法
马尔可夫决策过程(Markov Decision Process,MDP)
MDPs are meant to be a straightforward framing of the problem of learning from interaction to achieve a goal.
相关概念
随机变量(Random Variance): ( $X, \ y, \ x \perp y$),随机变量之间存在的独立性。
随机过程(Stochastic Process): ${S_t}_{t=1}^{\infty}$ 一个时间序列的随机变量集合,通常用来描述随着时间变化的状态。
Markov链/过程(Markov Chain/Process):强调了Markov性质(Markov Property),即未来的状态仅依赖于当前状态而与过去无关,形式化地表示为:
$$ P(S_{t+1}|S_t, S_{t-1}, …,S_1) = P(S_{t+1}|S_{t}) $$
状态空间模型(State Space Model): Markov Chain + Observation; 如 HMM, Kalman Filter,particle Filter。
Markov奖励过程(Markov Reward Process, MRP):Markov chain + Reward;在Markov链的基础上加入奖励函数,以描述智能体在每个状态下获得的即时奖励。
Markov决策过程(Markov Decision Process, MDP): Markov Chain + Reward + Action;MRP的进一步扩展,在Markov链和奖励基础上再加入动作选择。
$$ S: \rm{State \ set} \to s_t $$
$$ A: \rm{action \ set}, \forall s\in S, \ A(s) \to A_t $$
$$ R: \rm{reward \ set} \to R_t, R_{t+1} $$
动态特性
the state-transition probabilities
在MDP模型中,如何根据状态、动作和奖励来计算系统的转移概率
状态转移概率 $P: \ p(s’, r| s,a) \triangleq P_r{S_{t+1}=s’, R_{t=1}=r|S_t=s, A_t=a}$ 状态转移函数:
$$ p(s’|s,a) = \sum_{r\in R}p(s’, r|s,a) $$
-
状态转移概率 $p(s’, r | s, a)$ 定义了在某个状态执行某个动作时转移到下一状态并获得特定奖励的概率。
-
状态转移函数 $p(s’ | s, a)$ 则是对奖励进行求和,得到仅与状态和动作相关的转移概率。
价值函数
That all of what we mean by goals and purposes can be well thought of as the maximization of the expected value of the cumulative sum of a received scalar signal (called reward).
MDP目标:找到最优策略
policy:$\pi$
-
确定性策略: $a \triangleq \pi(s)$
-
随机性策略: $\pi(a|s) \triangleq pr(A_t=a|S_t=s)$
策略(Policy)是智能体在给定状态下选择动作的规则。策略决定了智能体在每个状态下应该采取什么行动。
强化学习的主要任务之一就是学习一个最优策略,使得智能体在长期内能够获得最高的累计奖励。
什么样的策略是好策略,如何找到好策略 → 回报
Reward: 奖励是智能体在特定状态下执行某个动作后立即收到的反馈信号,用来衡量动作的好坏。
奖励通常用函数 $R(s, a)$表示,表示在状态 $s$ 下执行动作 $a$ 所得到的即时奖励。
Return: 累积回报;通过对未来的奖励进行累积并引入折扣因子 $\gamma$ 来计算,从而衡量在一个状态或时间步开始后,智能体在长期内的收益。目的是让较近的奖励比未来的奖励更有权重,即智能体更关注短期内的回报。
$G_t = R_{t+1} + \gamma R_{t+2}+\gamma ^2R_{t+3}…+\gamma ^{T-1}R_T = \sum_{i=0}^{\infty}\gamma^iR_{t+i+1} \ (T\to \infty)$
$\gamma \in [0,1]$
累积回报 $G_t$ 是强化学习中最优化的目标,即智能体通过学习找到一个策略,使得每个时间步的累积回报 $G_t$ 最大化。这个值衡量了从时间步 $t$开始,智能体在长期内可以期望获得的总奖励。
Bellman Expectation Equation
It expresses the value of a decision problem at a certain point in time in terms of the payoff from some initial choices and the value of the remaining decision problem that results from those initial choices.
状态值函数(State-Value Function) $v_{\pi}(s)$ :
- 定义:状态值函数 $v_{\pi}(s)$ 表示在策略 $\pi$ 下,从状态 $s$ 开始时期望的回报,即:
$$ V_{\pi}(s) = \mathbb{E}_{\pi} [G_t | S_t = s] $$
- 含义:该函数衡量了在状态 $s$ 下遵循策略 $\pi$ 时,智能体能够获得的期望总回报。
动作值函数(Action-Value Function) $q_{\pi}(s, a)$ :
- 定义:动作值函数 $q_{\pi}(s, a)$ 表示在策略 $\pi$ 下,从状态 $s$ 开始、采取动作 $a$ 后期望的回报,即:
$$ q_{\pi}(s, a) = \mathbb{E}_{\pi} [G_t | S_t = s, A_t = a] $$
- 含义:该函数衡量了在状态 $s$ 下执行动作 $a$ 后,并继续遵循策略 $\pi$ 时,智能体能够获得的期望总回报。
状态值函数 $V_{\pi}(s)$ 可以用动作值函数 $q_{\pi}(s, a)$ 表示为:
$$ V_{\pi}(s) = \sum_{a \in A(s)} \pi(a|s) q_{\pi}(s, a) $$
等于在该状态下执行不同动作的期望回报之和(加权平均 ),权重是执行每个动作的概率 $\pi(a | s)$。
同样,动作值函数 $q_{\pi}(s, a)$ 可以通过立即奖励和后续状态的折扣值计算:
$$ q_{\pi}(s, a) = \sum_{r, s^{\prime}} p(s^{\prime}, r | s, a) \left( r + \gamma V_{\pi}(s^{\prime}) \right) $$
其中, $p(s^{\prime}, r | s, a)$ 是状态 $s$ 下执行动作 $a$ 后转移到状态 $s^{\prime}$ 并获得奖励 $r$ 的概率。
Bellman期望方程的状态值函数形式:
$$ V_{\pi}(s) = \sum_{a \in A} \pi(a|s) \sum_{s^{\prime}, r} p(s^{\prime}, r | s, a) [r + \gamma v_{\pi}(s^{\prime})] $$
当前状态值 $V_{\pi}(s)$ 和后续状态值之间的关系
Bellman期望方程的动作值函数形式:
$$ q_{\pi}(s, a) = \sum_{s^{\prime}, r} p(s^{\prime}, r | s, a) \left[ r + \gamma \sum_{a{\prime}} \pi(a^{\prime} | s^{\prime}) q_{\pi}(s^{\prime}, a^{\prime}) \right] $$
-
Bellman期望方程将当前状态(或状态-动作对)的值递归地表示为与后续状态值的关系
-
通过递归地计算这些期望值用于在策略评估
To recap, the idea of the Bellman equation is that instead of calculating each value as the sum of the expected return, which is a long process, we calculate the value as the sum of immediate reward + the discounted value of the state that follows.
Bellman Optimality Equation
the optimal state-value function
$V_{*}(s) \triangleq \max_{\pi} V_{\pi}(s)$ the optimal action-value function
$q_*(s,a)\triangleq \max_{\pi}q_{\pi}(s,a)$
For the state-action pair $(s,a)$, this function gives the expected return for taking action $a$ in state $s$ and thereafter following an optimal policy. to write $q_$ in terms of $v_$ as follows: $q_(s,a) = E[R_{t+1}+\gamma v_(S_{t+1})|S_t = s, A_t = a]$
…
$V_{\pi *}(s)=\max q_{\pi *}(s,a)$
…
The Bellman optimality equation:
$$ \begin{align*} v_(s) &= \max_{a \in \mathcal{A}(s)} q_(s, a) \ &= \max_a \mathbb{E}{\pi} \left[ G_t \mid S_t = s, A_t = a \right] \ &= \max_a \mathbb{E}{\pi} \left[ R_{t+1} + \gamma G_{t+1} \mid S_t = s, A_t = a \right] \ &= \max_a \mathbb{E} \left[ R_{t+1} + \gamma v_(S_{t+1}) \mid S_t = s, A_t = a \right] \ &= \max_a \sum_{s’, r} p(s’, r \mid s, a) \left[ r + \gamma v_(s’) \right]. \end{align*} $$
$$ \begin{align*} q_(s, a) &= \mathbb{E} \left[ R_{t+1} + \gamma \max_{a’} q_(S_{t+1}, a’) \mid S_t = s, A_t = a \right] \ &= \sum_{s’, r} p(s’, r \mid s, a) \left[ r + \gamma \max_{a’} q_(s’, a’) \right]. \end{align} $$
在理论上,我们定义了最优值函数和最优策略,并且可以通过贝尔曼最优性方程来解决。
但:
-
计算成本
-
过于复杂而无最优的解析解
直接计算最优策略或值函数既不现实,也没有必要。有时只能通过逼近来寻找次优解,而非真正的最优解。
动态规划
如何求解Bellman Optimality Equation
采用动态规划DP;虽然动态规划要求环境模型(如 $p(s^{\prime}, r \mid s, a)$)是已知的,因此在强化学习中直接应用可能受到限制,但它仍是理论基础。强化学习中的许多方法都可以被视为在没有模型的情况下逼近动态规划的效果。
动态规划:通过将问题分解为更小的子问题,逐步解决并保存每个子问题的结果,以避免重复计算,从而高效地求解问题。
策略迭代(Policy Iteration) = 策略评估(Evaluation)+策略改进
价值迭代 (Value Iteration):直接通过Bellman最优方程迭代更新状态值函数 $V(s)$,直到收敛
策略评估公式推导
已知MDP $p(s’,r|s,a)$ , 给定$\pi$ 求 $v_{\pi} \ (\forall s \in S)$ 记
$$
V_{\pi} = \begin{pmatrix}
v_{\pi}(s_1) \
v_{\pi}(s_2) \
. \
. \
.\
v_{\pi}(s_{|s|})
\end{pmatrix}_{|s|\times 1}
$$
通过递归公式:$v_{\pi}(s) = \mathbb{E}{\pi}[G_t \mid S_t = s]$
代入回报的定义 $G_t = R_{t+1} + \gamma G_{t+1}$ 得到:
$$ V_{\pi}(S)=E_{\pi}[G_t|S_t=s] \ =E_{\pi}[R_{t+1}+\gamma V_{\pi}(s_{t+1})]\=\sum_a\pi(a|s)\sum_{s’,r}p(s’,r|s,a)[r+\gamma V_{\pi}(s’)] $$
有两个部分:
奖励部分(即期望即时奖励)
$$ \sum_a \pi(a \mid s) \sum_{r} r \cdot p(r \mid s, a) = \sum_a \pi(a \mid s) E_{\pi}[R_{t+1}|S_{t}=s,A_t=a]= \ \sum_a \pi(a \mid s) r_{\pi}(s,a) = r_{\pi}(s). $$
这里 $r_{\pi}(s)$ 是策略 $\pi$ 下的状态 $s$ 对应的期望收益。
未来价值部分(即折扣后的期望价值)
$$ \gamma \sum_{s^{\prime}} p_{\pi}(s, s^{\prime}) \cdot v_{\pi}(s^{\prime}), $$
其中 $p_{\pi}(s, s^{\prime}) = \sum_a \pi(a \mid s) p(s^{\prime} \mid s, a)$ 是策略 $\pi$ 引导下的状态转移概率。
综合这两个部分,价值函数满足递归关系:
$$ v_{\pi}(s) = r_{\pi}(s) + \gamma \sum_{s^{\prime}} p_{\pi}(s, s^{\prime}) v_{\pi}(s^{\prime}). $$
策略评估(Policy Evaluation)——解析解
用矩阵 $V_{\pi}$、 $r_{\pi}$ 、和 $P_{\pi}$ 表示上述关系:
-
$V_{\pi}$ : 状态价值向量($|S|×1$)
-
$r_{\pi}$ : 状态的期望奖励向量($|S|×1$)
-
$P_{\pi}$ : 策略引导的转移概率矩阵($|S|×|S|$),第 $(i, j)$ 项为从状态 $i$ 到 $j$ 的转移概率
则递归关系可以写为:
$$ V_{\pi} = r_{\pi} + \gamma P_{\pi} V_{\pi}. $$
化简为线性方程:
$$ (I - \gamma P_{\pi}) V_{\pi} = r_{\pi}. $$
求解:
$$ V_{\pi} = (I - \gamma P_{\pi})^{-1} r_{\pi}. $$
矩阵求逆 ($I - \gamma P_{\pi})^{-1}$ 的时间复杂度是 $O(|S|^3)$,其中 $|S|$ 是状态的数量。这对于大规模状态空间是不可行的。
迭代方法(动态规划思想):避免直接求解矩阵逆,使用迭代更新 $V_{\pi}$ 的方式:
$$ V_{\pi}^{(k+1)} = r_{\pi} + \gamma P_{\pi} V_{\pi}^{(k)}. $$
通过 $O(|S|^2)$ 的复杂度更高效地计算近似解。
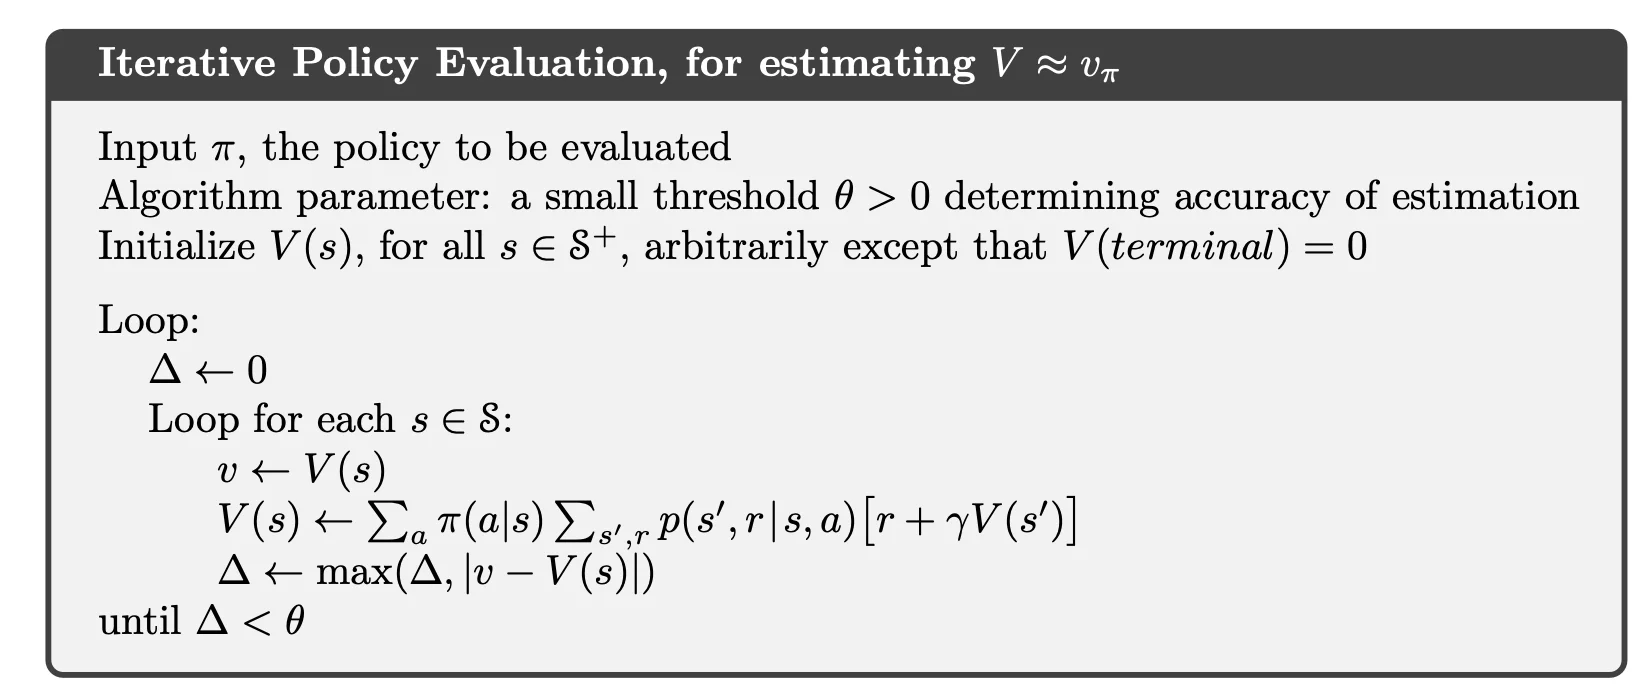
策略评估(Policy Evaluation)—— 迭代解
迭代方法使用 Bellman 方程作为递归关系,通过不断更新 $V_k(s)$ 的近似值,逐步收敛到真实的 $V_{\pi}(s)$ 。
更新公式为:
$$ V_{k+1}(s) = \sum_a \pi(a|s) \sum_{s^{\prime},r} p(s^{\prime},r|s,a) \left[ r + \gamma V_k(s^{\prime}) \right]. $$
具体实现
随机初始化 $V_0(s)$
对每个状态 $s$,使用 Bellman 方程更新价值函数:
$$ V_{k+1}(s) \leftarrow \sum_a \pi(a|s) \sum_{s^{\prime},r} p(s^{\prime},r|s,a) \left[ r + \gamma V_k(s^{\prime}) \right]. $$
当两次迭代的最大差异(例如$\max_s |V_{k+1}(s) - V_k(s)|$ )小于某个阈值 $\theta$ 时停止。
伪代码
Policy Improvement
策略改进是 策略迭代算法(Policy Iteration) 的一个关键步骤,其目标是利用当前策略 $\pi$ 的价值函数 $V_\pi$ 或 $Q_\pi$ 推导出一个更优的策略 $\pi^{\prime}$ 。
-
基于当前策略的价值函数,找到一个更优的策略 $\pi^{\prime}$ 。
-
核心是保证新策略的价值 $V_{\pi^{\prime}}$ 至少不低于当前策略 $V_\pi$。
策略改进定理(Policy Improvement Theorem)
给定两个策略 $\pi$ 和 $\pi^{\prime}$ ,若:
$$ q_\pi(s, \pi^{\prime}(s)) \geq V_\pi(s), \quad \forall s \in S, $$
则有:
$$ V_{\pi^{\prime}}(s) \geq V_\pi(s), \quad \forall s \in S. $$
-
若新的策略 $\pi^{\prime}$ 的价值函数 $V_{\pi^{\prime}}(s) \geq V_\pi(s)$ 对所有状态 $s$ 都成立,那么策略 $\pi^{\prime}$ 至少与 $\pi$ 一样好。
-
若在某些状态 $s$ 上严格成立 $V_{\pi^{\prime}}(s) > V_\pi(s)$ ,则 $\pi^{\prime}$ 是更优的策略。
-
也就是说,无需再计算$V_{\pi^{\prime}}(s)$
证明(略)
Greedy 策略
如何找到一个比当前策略更优的策略? — 贪心策略, 在当前状态 $s$ 选择短期收益和长期期望回报的最优动作。
具体而言 $\pi^{\prime}(s)$ 是在每个状态 $s$ 下选择一个动作 $a$ ,使得当前的动作价值函数 $Q_\pi(s, a)$ 最大化:
$$ \pi^{\prime}(s) = \arg\max_a Q_\pi(s, a). $$
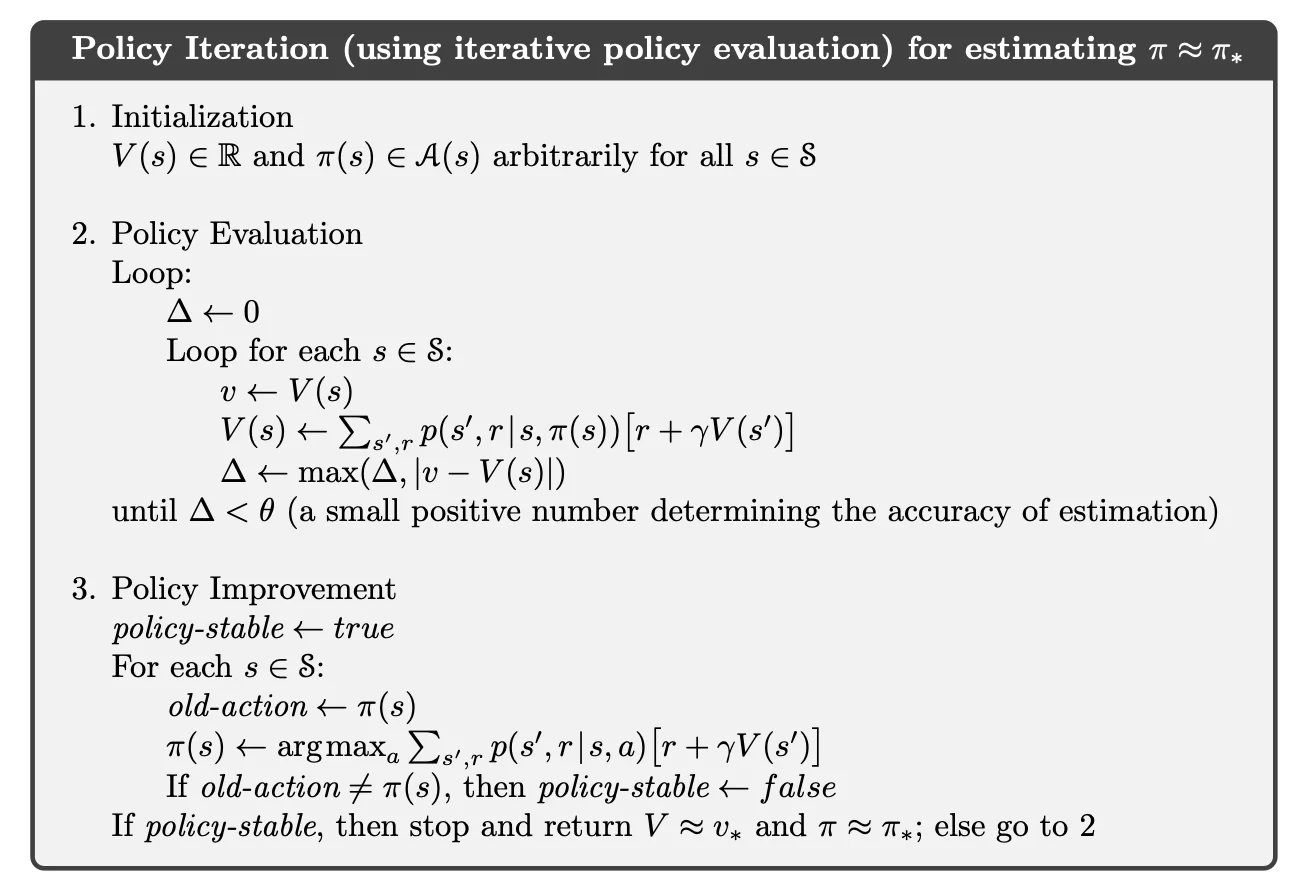
Policy Iteration
通过 策略评估 和 策略改进 两个交替步骤,逐步优化策略,最终收敛到最优策略 $\pi^*$ 。
-
Policy Evaluation: 计算当前策略 $\pi$ 的价值函数 $V_\pi(s)$ 或动作价值函数 $Q_\pi(s, a)$,使用贝尔曼方程,得到策略下每个状态的长期回报
-
Policy Improvement: 基于当前策略的价值函数,找到一个更优的策略 $\pi^{\prime}$ , 核心是保证新策略的价值 $V_{\pi^{\prime}}$ 至少不低于当前策略 $V_\pi$
重复交替执行 策略评估 和 策略改进,直到策略不再变化(收敛)
Value Iteration
Policy Iteration 的简化形式,通过截断策略评估的过程,直接利用Bellman方程递推更新值函数,逐步逼近最优值函数 $V^$ 和最优策略 $\pi^$ 。
价值迭代的目标是直接计算最优值函数 $V^{(s)}$ ,然后通过值函数导出最优策略 $\pi^{(s)}$ 。
策略迭代 vs. 价值迭代
Policy Iteration: Policy Evaluation+Policy Improvement, Policy Evaluation 需要通过多次迭代对当前策略的值函数 $V_\pi$ 进行精确求解
Value Iteration: 对策略迭代的优化,截断了策略评估过程,不需要完全求解当前策略 $\pi$ 的值函数 $V_\pi$ ,而是直接使用近似值 $V_k$ 来更新,结合策略改进一步完成
递推公式:
$$ V_{k+1}(s) = \max_a \sum_{s^{\prime}, r} P(s^{\prime}, r \mid s, a) \left[ r + \gamma V_k(s^{\prime}) \right]. $$
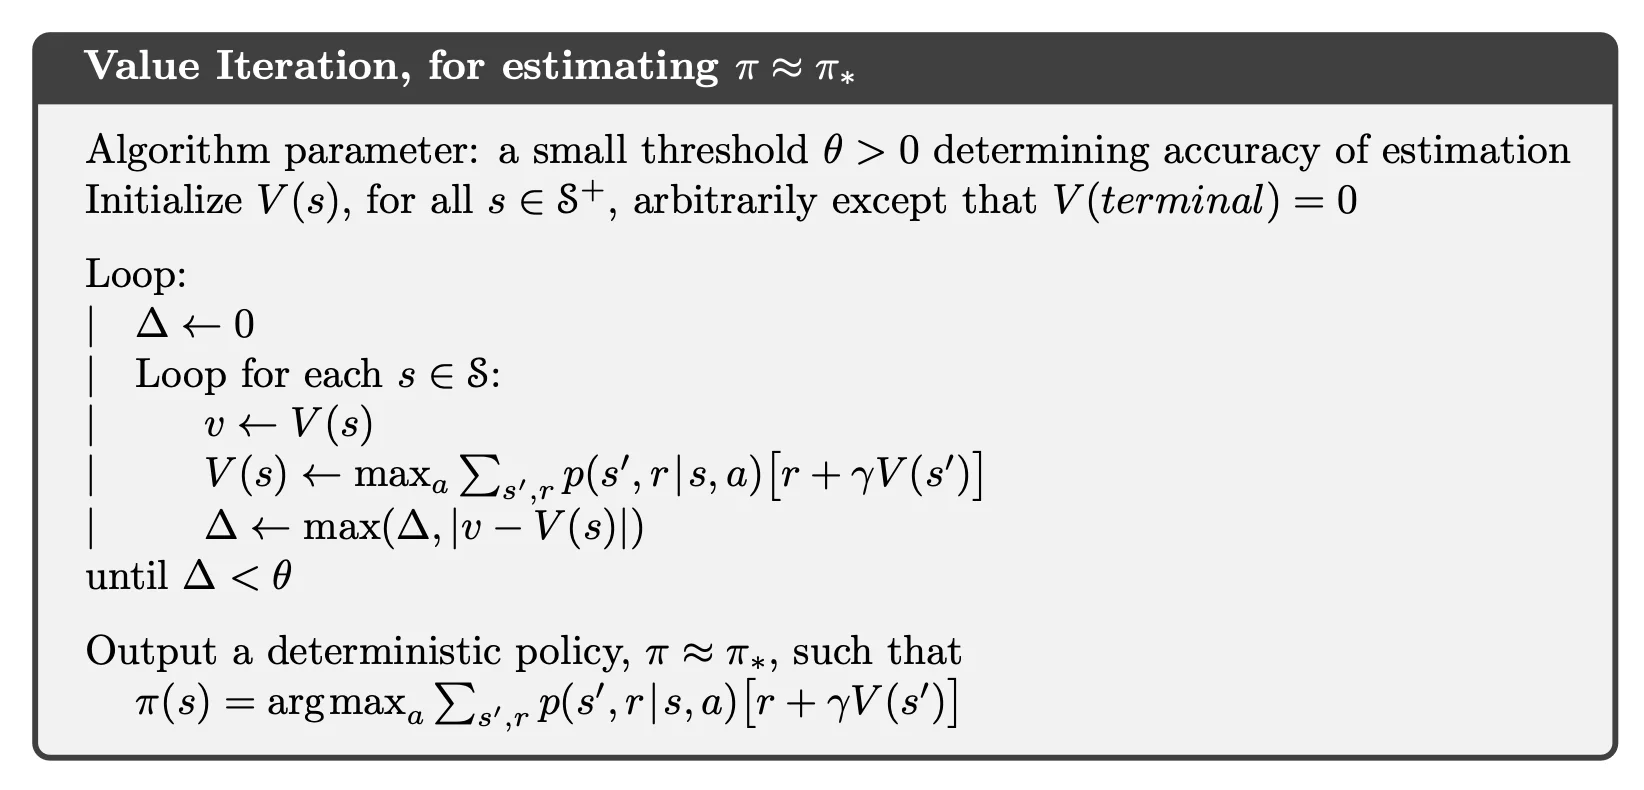
价值迭代是极端情况下的策略迭代
策略迭代 –> 价值迭代 –> 就地策略迭代(异步策略迭代)
Monte Carlo Methods
回顾RL:
两个主体: Agent, Environment 一个框架: MDP 五大元素:$S$, $A$, $R$, $\pi$, $p(s,‘r|s,a)$ 核心问题: 如何找到最优策略
-
引入价值函数的概念: $v_{\pi}$, $q_{\pi}$
-
策略迭代: 策略评估,策略改进
对于动态规划(DP)方法,策略评估和改进会通过递归迭代逐渐逼近:${v_k} \to V_{\pi}$
蒙特卡洛方法的引入:与动态规划不同,蒙特卡洛方法无需明确知道环境的动态特性(即$p(s^{\prime}, r \mid s, a)$ 的分布)。它基于实际或模拟的经验,通过采样得到值函数和最优策略。即model-free。
**关键思想:**平均多个 episode 的回报,来估计每个状态或动作的价值;通过不断采样和学习,实现状态值函数和策略的逼近。
非平稳性问题: 由于策略和环境的动态性,导致奖励或状态分布随着时间发生变化。具体而言, 在强化学习中,智能体会随着经验的积累不断调整其策略,策略的变化会导致智能体访问的状态分布和奖励的期望值随时间变化,这些变化导致采样数据的分布在整个学习过程中不是固定的,这与传统监督学习中的**独立同分布(i.i.d.)**假设冲突。
蒙特卡洛方法不依赖某一时刻的单次采样,而是基于整个 episode 的累计回报 $G_t$ 进行估计,对于某个状态 $s$ ,通过采样多个 episode 的平均值来估计其值函数:
$$ v(s) = \text{average}(G_t \mid s_t = s) $$
基于多个完整 episode 的平均能够有效减少单次采样波动。
蒙特卡洛方法不需要知道 $p(s^{\prime}, r \mid s, a)$的显式形式,不关心状态转移和奖励分布的具体形式,只需要能通过采样得到状态-动作-奖励序列。
| 特性 | 动态规划(DP) | 蒙特卡洛方法 |
|---|---|---|
| 环境模型需求 | 需要明确的动态模型 | 不需要动态模型(基于采样) |
| 数据需求 | 全部状态-动作-奖励的概率分布 | 采样得到的状态-动作-奖励序列 |
| 适用范围 | 对环境已知、问题明确的场景 | 适合实际应用和无法明确建模的环境 |
| 更新方式 | 基于Bellman方程的递归更新 | 基于完整episode的采样平均 |
-
当无法获得环境的动态模型(即状态转移概率 $p(s^{\prime}, r \mid s, a)$),无法通过动态规划直接计算价值函数和最优策略时,可以使用蒙特卡洛方法。
-
蒙特卡洛方法通过采样数据(而非模型)来估计价值函数和改进策略,适合于与环境交互而无需明确模型的场景。
Monte Carlo Prediction & Estimation
在策略评估中,我们希望估计给定策略 $\pi$的状态价值函数 $V_\pi(s)$或者动作价值函数 $Q_\pi(s, a)$
由于我们无法直接求解 Bellman 方程:
$$ V_\pi(s) = \sum_a \pi(a \mid s) \sum_{s^{\prime}, r} p(s^{\prime}, r \mid s, a) \big[r + \gamma V_\pi(s^{\prime})\big] $$
所以蒙特卡洛方法通过对每次访问的回报 $G_t$ 进行平均来近似 $V_\pi(s)$:
$$ V_\pi(s) \approx \frac{1}{N} \sum_{i=1}^N G_t^{(i)} $$
其中 N 是轨迹数量,大数定律保证当 $N \to \infty$ 时,估计值会收敛到真实的值。
存在两种策略评估方法:
-
首次访问(First-visit MC):仅使用轨迹中某状态第一次出现时的回报来更新该状态的估计值。
-
每次访问(Every-visit MC):轨迹中每次访问某状态时都使用其回报更新该状态的估计值。
| 差异点 | First-visit MC | Every-visit MC |
|---|---|---|
| 回报的使用 | 只使用状态在一个 episode 中的第一次访问 | 使用状态在一个 episode 中的所有访问 |
| 更新次数 | 每个 episode 中最多更新一次 | 每次访问状态时都更新 |
| 数据独立性 | 更高:使用的回报较少,数据相关性低 | 较低:回报相关性高 |
| 收敛速度 | 较慢(舍弃部分数据) | 较快(充分利用所有回报) |
| 计算开销 | 较低:更新次数少 | 较高:更新次数多 |
| 理论分析难度 | 较容易 | 较复杂 |
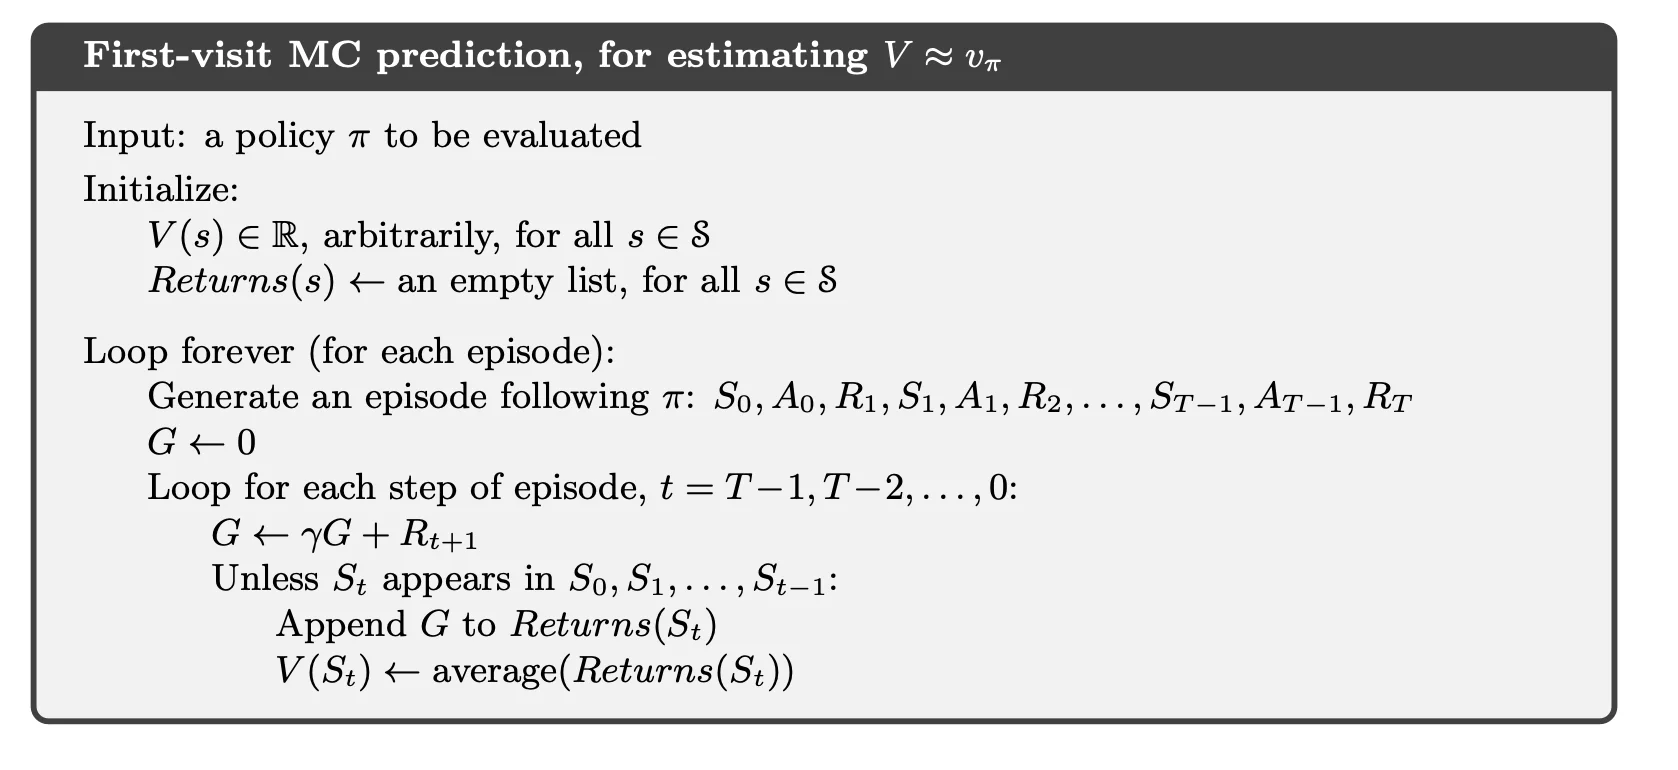
蒙特卡洛方法需要保证所有状态都能被充分访问,否则某些状态可能永远不会在采样中出现,导致对应的值函数无法被估计。为解决这个问题,假设:**Exploring Starts(试探性出发)**即每个状态都有被访问的可能性。
但这种假设在真实环境中很难实现,实际中可能需要使用随机策略保证探索性,或者采用其他方法(如$\epsilon$-贪婪策略)来实现状态空间的充分覆盖。
基于试探性出发假设的MC控制
在策略评估中使用了两个假设: 无限幕,和试探性出发假设;
无限幕可通过GPI(广义策略迭代)方式解决
在实际中,满足试探性出发假设往往不现实,因此需要替代方法(如软策略或离轨方法)
基于 ES 的 MC 控制
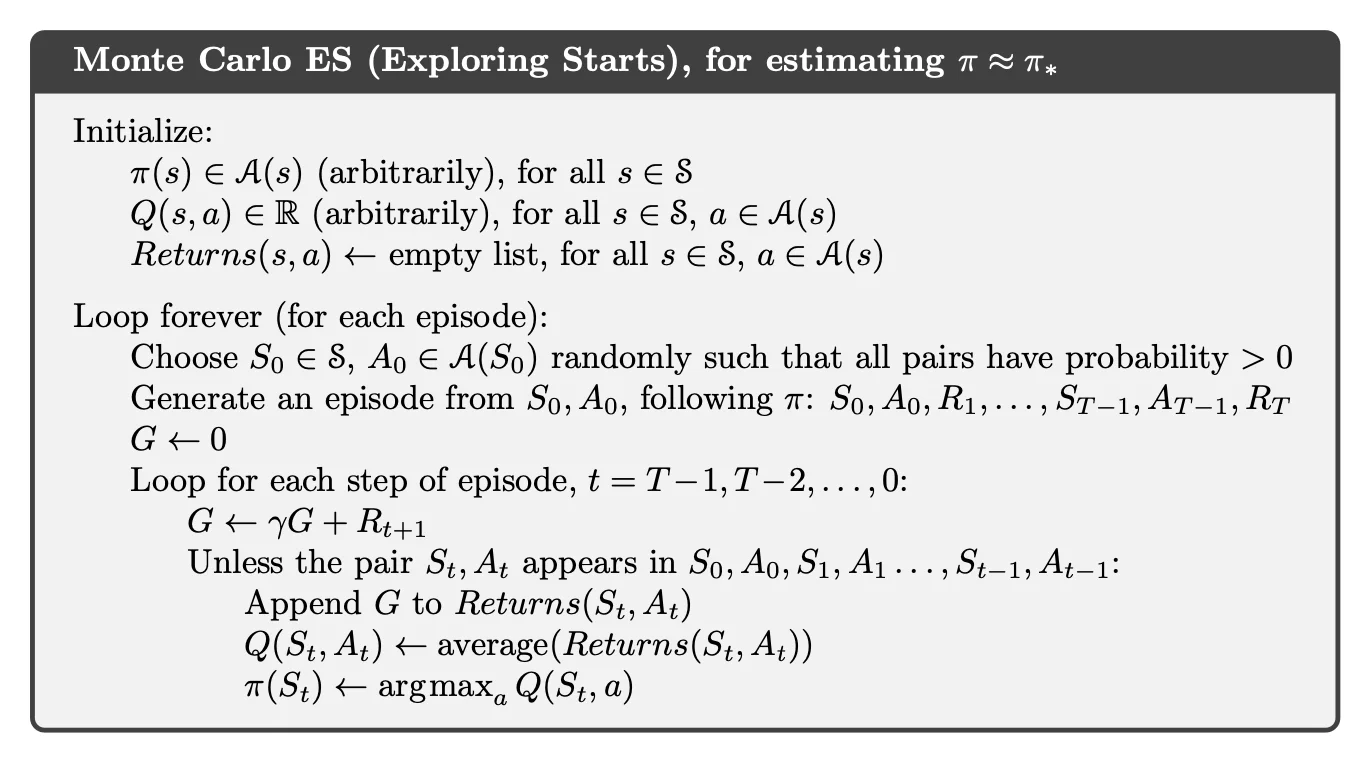
同轨和离轨
由于试探性出发假设难以满足,可以通过其他方法保证所有状态-动作对都被探索。
如何避免试探性出发假设?
-
用来生成样本的策略,简称行动策略 $b$ 必须是软策略:$\forall s \in S, \ a\in A(s),$有 $b(a|s)>0$
-
待评估,待改进的策略,简称 目标策略 $\pi$
⇒
同轨策略方法: $\pi =b$, 且为软性策略
离轨策略方法:$\pi \neq b$
方法 1:同轨策略方法(On-policy Methods)
在同轨 MC 控制中, 采样和评估使用的是同一个策略 $\pi = b$, 每次迭代后,基于 $\epsilon$-greedy策略更新。
$\epsilon$-greedy策略是一种常用的软性策略(Soft Policy,即保证所有动作都有非零概率被选择),以概率 $1 - \epsilon$ 选择当前最优动作(贪婪选择),以概率 $\epsilon$ 随机选择任意动作。更新方式:
$$ \pi(a|s) = \begin{cases} 1 - \epsilon + \frac{\epsilon}{|A(s)|}, & a = \arg\max_a Q(s, a) \ \frac{\epsilon}{|A(s)|}, & a \neq \arg\max_a Q(s, a) \end{cases} $$
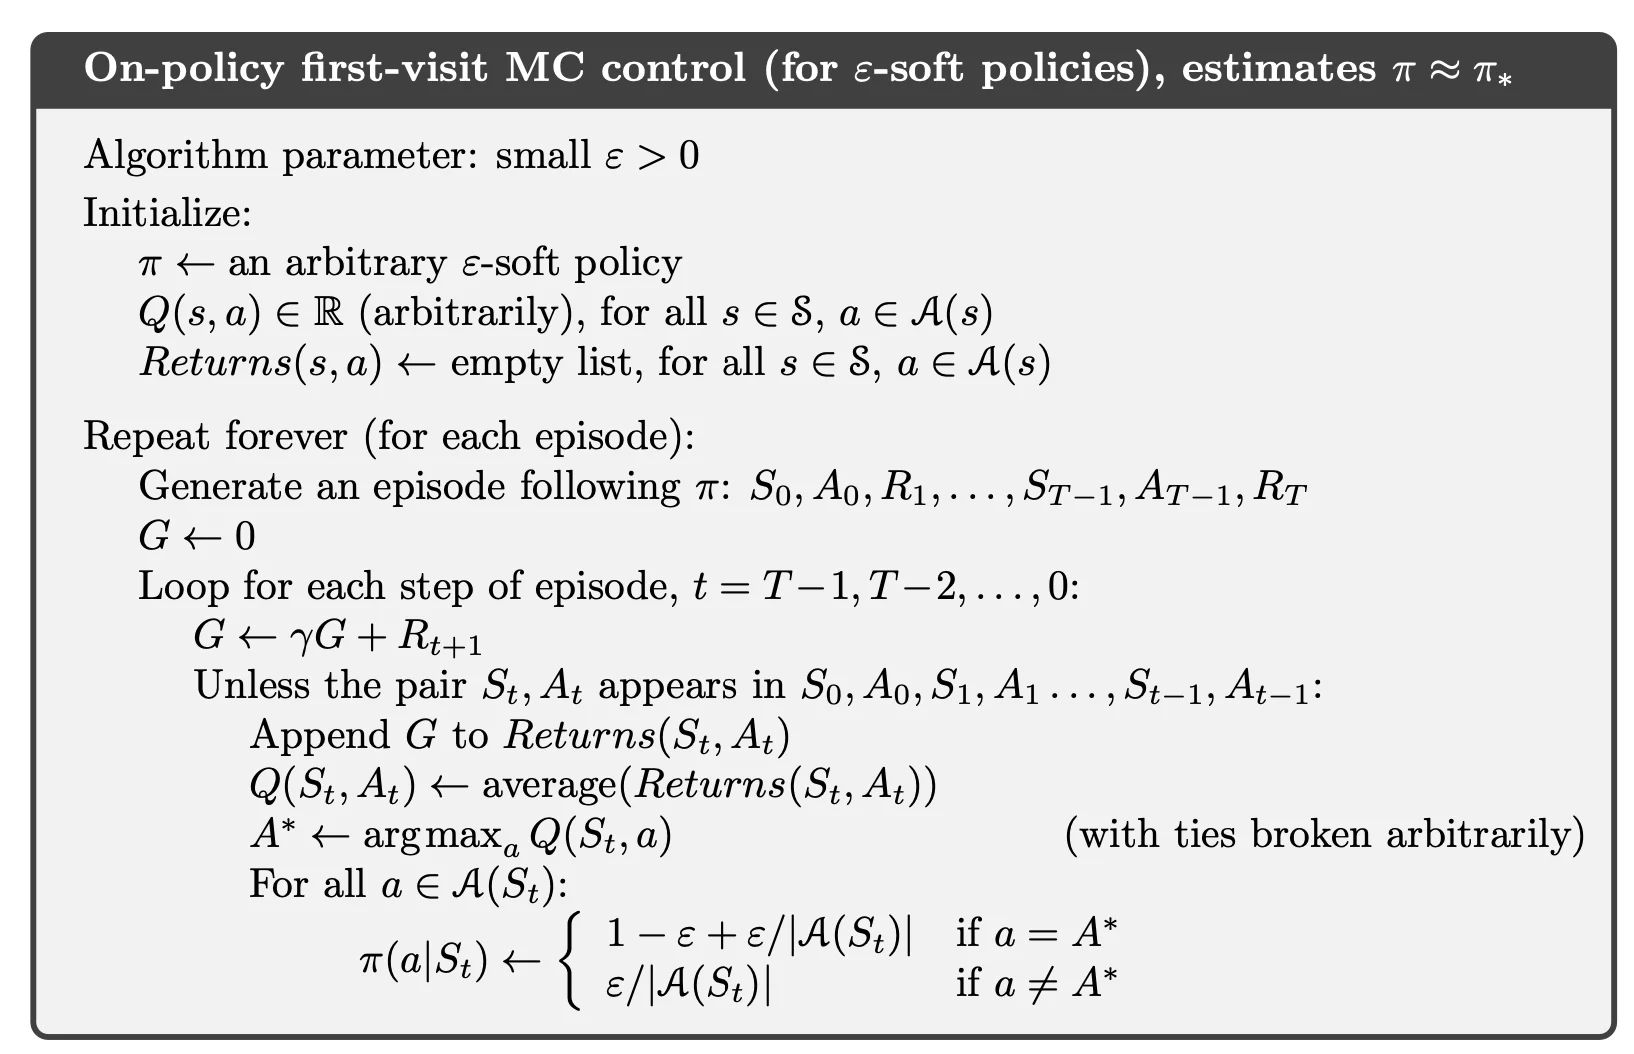
方法 2:离轨策略方法(Off-policy Methods)
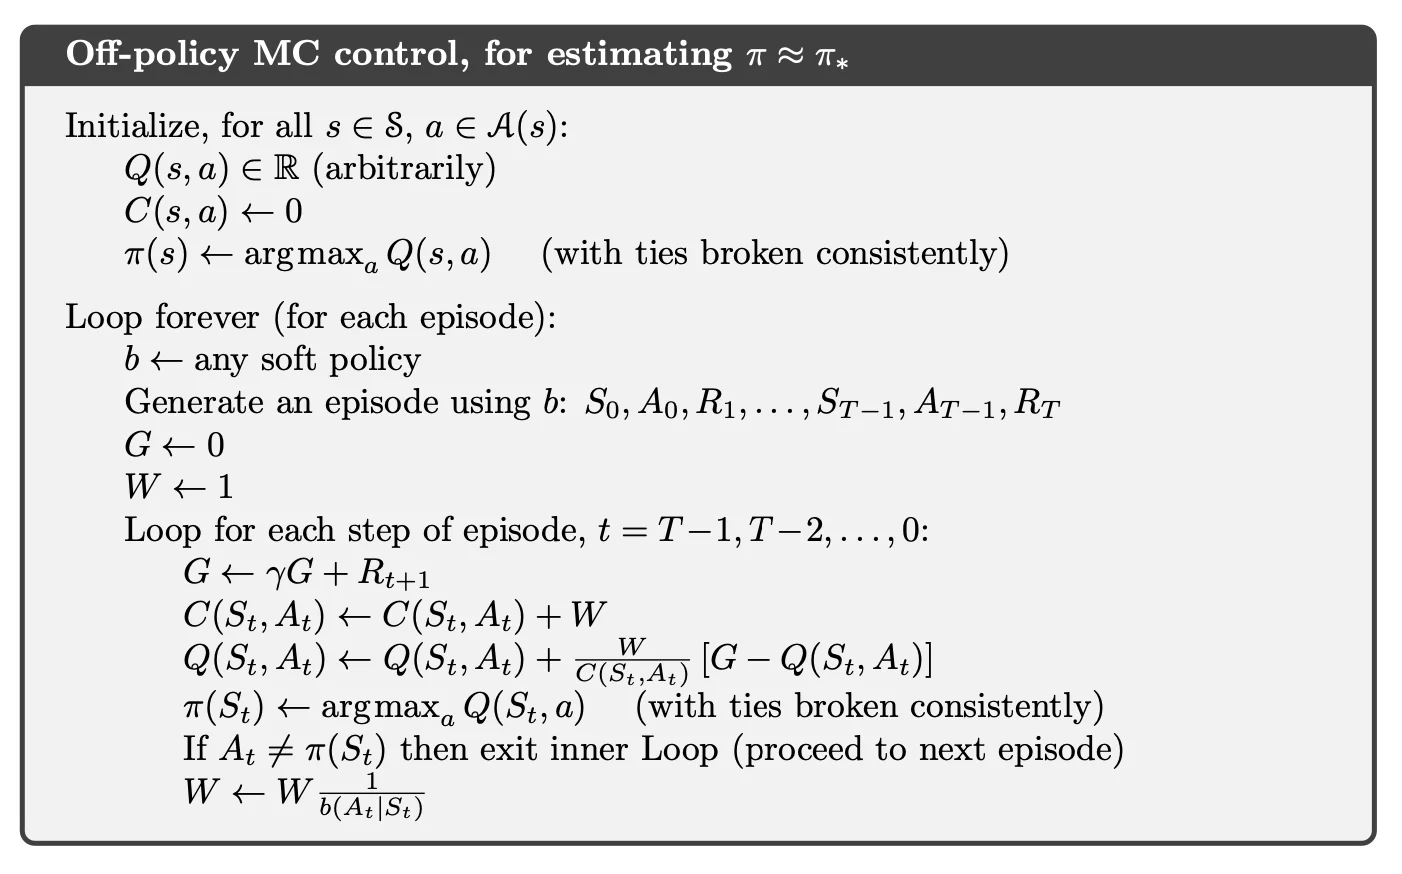
使用两个策略,
-
行动策略 $b$:随机性更高,保证探索性。
-
目标策略 $\pi$:逐渐优化到最优。
行动策略 $b$ 和 目标策略 $\pi$ 不同, 行为策略 $b$ 用于生成数据,必须是软性策略,目标策略 $\pi$ 是被评估和改进的策略,通常是贪婪或接近贪婪的策略。
这种方法与同轨(On-policy)方法的关键区别在于,数据并非直接来源于目标策略,而是来源于行为策略。这种差异导致以下两个问题:
数据分布不同:行动策略和目标策略不一致。 在 Monte Carlo 中,我们需要根据目标策略 $\pi$来估计其对应的值函数 $v_\pi(s)$ 或 $q_\pi(s, a)$,但是,在 Off-policy 方法中,采样数据是由行动策略 $b$ 生成的, $\mathbb{E}b[G_t \mid S_t = s] \neq \mathbb{E}\pi[G_t \mid S_t = s]$,因此,我们无法直接使用行为策略生成的回报 $G_t$ 来估计目标策略的值。
**如何校正数据分布。**为了让行为策略生成的数据 $G_t$ 能用于估计目标策略的值,需要校正数据的分布,使其符合目标策略 $\pi$。重要性采样通过对回报进行加权,能够将行动策略的数据分布调整为目标策略的数据分布。
importance-sampling ratio:
$$ \rho_t = \frac{\pi(A_t \mid S_t)}{b(A_t \mid S_t)}. $$
通过将回报 $G_t$ 按照 $\rho_t$ 加权,即可校正行为动策略的回报,使其在数学期望上等价于目标策略的回报。
$$ \begin{aligned} V_{\pi}(s) = E_{\pi}[G_t|S_t=s] \\ =\sum G_t \cdot Pr{A_t,R_{t+1},S_{t+1},…S_t|S_t = s,A_{t:T-1} \sim \pi} \\ = \sum G_t \cdot \pi(A_t|S_t) \cdot p(R_{t+1},S_{t+1}|S_t,A_t) …p(R_{t},S_{t}|S_{t-1},A_{t-1}) \\ =\sum G_t \cdot \prod_{k=t}^{T-1} [\pi(A_k|S_k)p(R_{k+1},S_{k+1}|S_k,A_k)] \\ = \sum G_t \prod_{k=t}^{T-1}[\frac{\pi(A_k|S_k)}{b(A_k|S_k)}b(A_k|S_k)\cdot p(R_{k+1},S_{k+1}|S_k, A_k)] \\ = \sum \prod_{k=t}^{T-1} \frac{\pi(A_k|S_k)}{b(A_k|S_k)} G_t \cdot \prod_{k=t}^{T-1} [b(A_k|s_k)\cdot p(R_{k+1},S_{k+1}|S_k, A_k)] \\ = \sum \rho_{t:T-1} \cdot G_t \cdot Pr{A_t,R_{t+1},S_{t+1},…S_t | S_t=s,A_{t:T-1}\sim b} \ = E_b[\rho_{t:T-1}|S_t=s] \\ \approx \frac{1}{N} \sum_N^{i=1} \rho_{t:T-1} G_t^{(i)} \end{aligned} $$
(普通重要性采样)
增量更新
| 方法 | 特点 | 优缺点 |
|---|---|---|
| 基于试探性出发(ES) | 所有状态-动作对都有非零概率被访问。 | 假设不现实,难以在实际中满足。 |
| 同轨控制(On-policy) | 使用 (\epsilon)-贪婪策略,策略生成和评估一致。 | 简单易实现,但可能需要更长时间才能达到最优策略。 |
| 离轨控制(Off-policy) | 行为策略和目标策略不同,通过重要性采样校正回报。 | 灵活且更强大,但重要性采样可能导致高方差。 |
Temporal-Difference Learning
策略评估
TD learning is a combination of Monte Carlo ideas and dynamic programming (DP) ideas.
Unlike MC methods, temporal-difference (TD) does not require the episodes are complete. TD methods can learn from incomplete episodes by bootstrapping.
即它根据部分观察到的信息(当前的奖励和下一步状态的估计值)来更新值函数,而不是等待整个序列的结束。
TD 核心思想是(结合了MC和DP)
-
MC-like:TD 利用实际经验(state-transition 和 reward)直接学习
-
DP-like:使用对状态值的估计(bootstrap)来更新
TD 的核心任务:Prediction 问题。 即给定一个策略 $\pi$,估计状态值函数 $v_\pi(s)$,即策略 $\pi$ 在状态 $s$ 上的期望回报
在DP中, 使用环境模型计算期望值 $\mathbb{E}[G_t | S_t = s]$ 来更新值函数;在MC中,完全依赖实际回报 $G_t$ 来更新值函数。需要等待整个 episode 结束,计算从 $t$ 时刻开始的完整回报。
但考虑到,环境的状态转移概率分布是未知的,无法直接应用 DP 方法,且计算开销较大,同时MC 方法需要等待一个 episode 结束才能计算累积回报,很难进行在线更新;
于是乎,TD 方法 仅使用当前的奖励 $R_{t+1}$ 和对下一状态的估计值 $V(S_{t+1})$来更新值函数,从而避开以上两种方法的弊端;
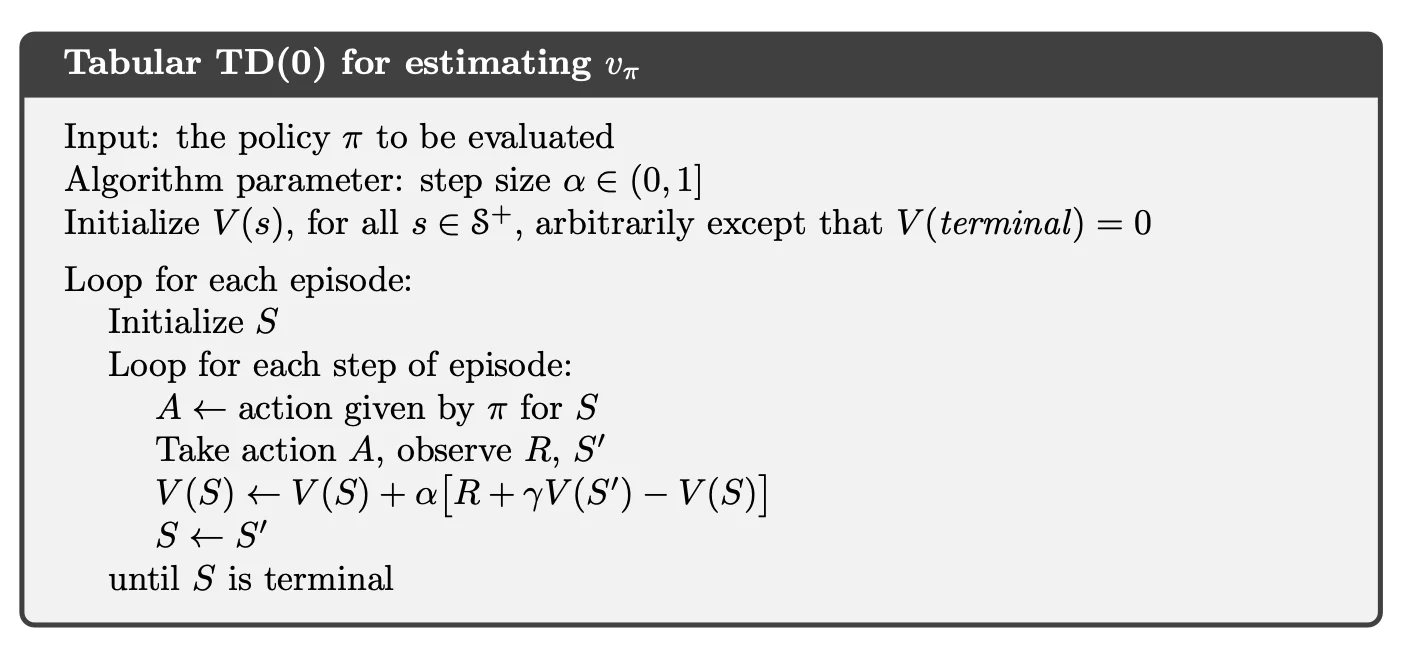
以 TD(0) 为例,TD(0) 是最简单的一步 TD 方法(直走一步,之后的步骤就不走了):
$$ V(S_t) \leftarrow V(S_t) + \alpha \left[ R_{t+1} + \gamma V(S_{t+1}) - V(S_t) \right] $$
TD 方法的target是 $R_{t+1} + \gamma V(S_{t+1})$
$R_{t+1}$ 采样获得;$V(S_{t+1})$ 自举得到。
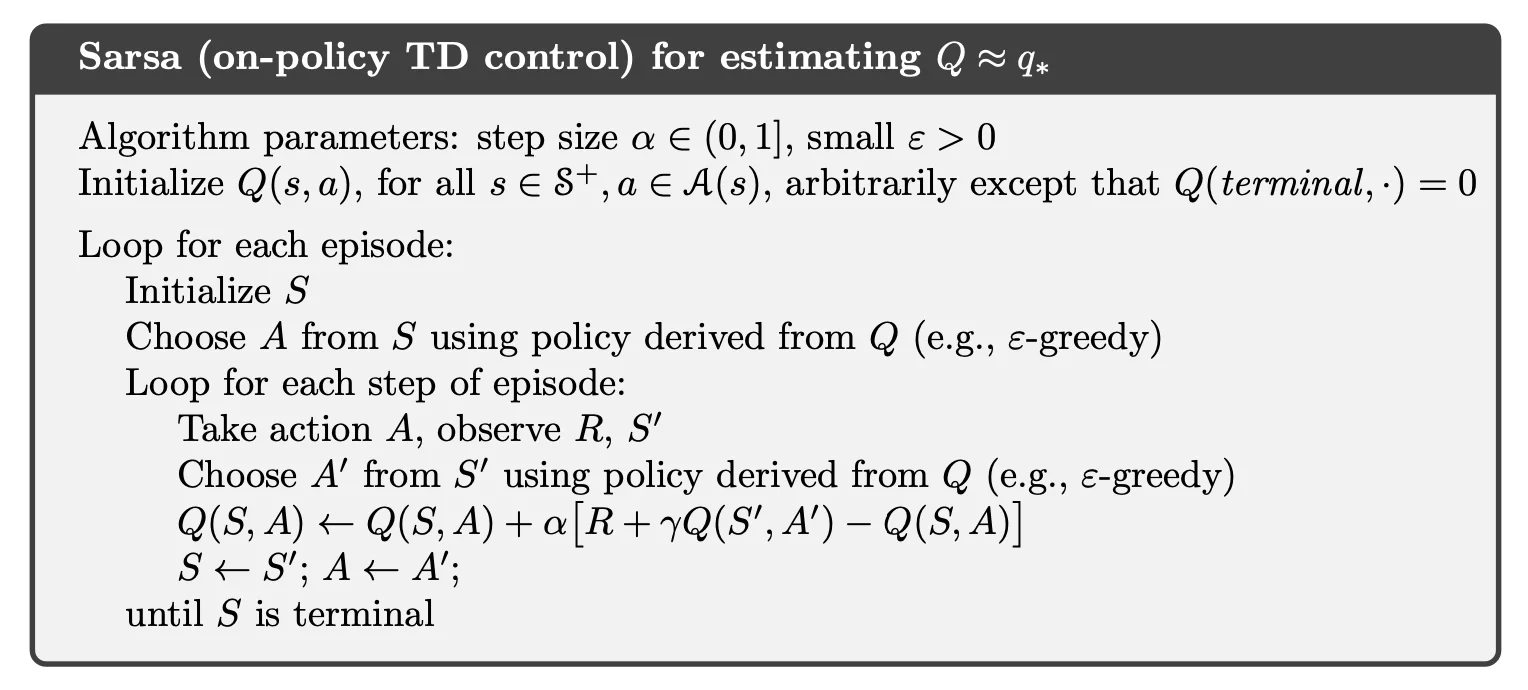
SARSA (On-Policy)
State (S), Action (A), Reward (R), next State (S’), and next Action (A’)
同轨策略下的TD控制
基于当前执行的策略(policy)
更新公式来更新动作值函数 $Q(s, a)$
$$ Q(S_t, A_t) \leftarrow Q(S_t, A_t) + \alpha \left[ R_{t+1} + \gamma Q(S_{t+1}, A_{t+1}) - Q(S_t, A_t) \right] $$
-
更新值函数时基于当前执行的策略
-
遵循当前策略来选择下一步的动作 $A_{t+1}$
-
on-policy,更倾向于避免过于激进的探索
Q-Learning (Off-Policy)
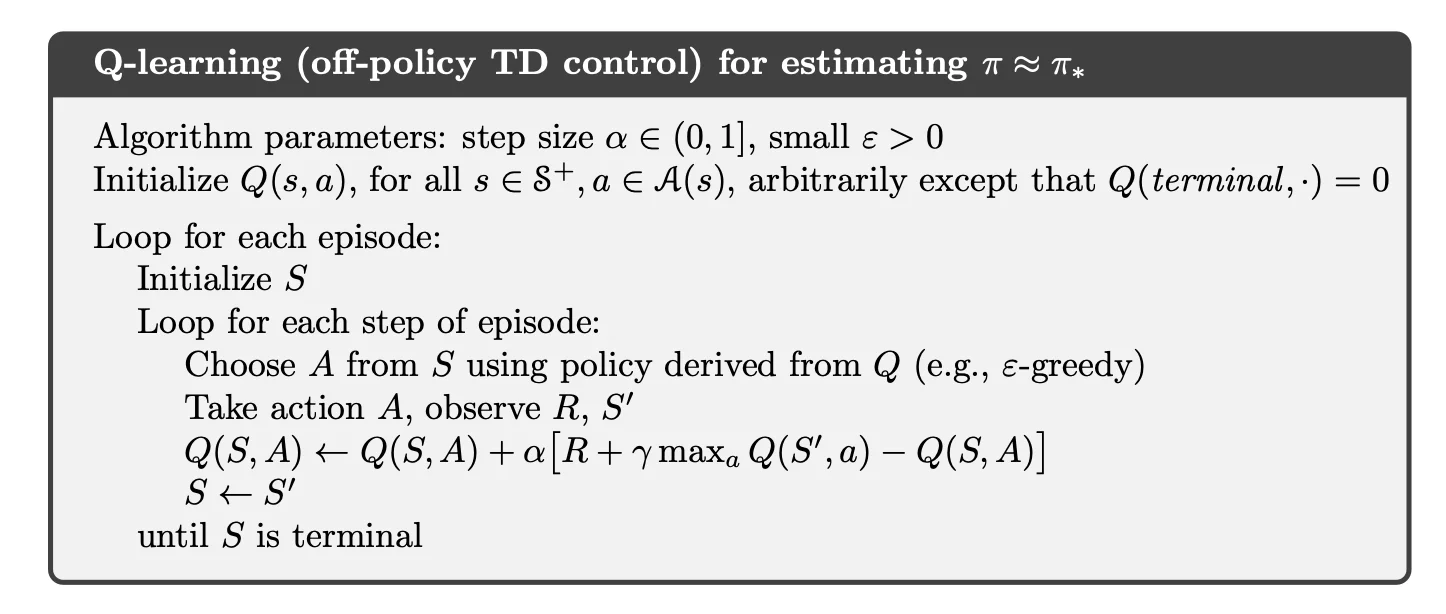
离轨策略下的TD控制
核心更新公式:
$$ Q(S_t, A_t) \leftarrow Q(S_t, A_t) + \alpha \left[ R_{t+1} + \gamma \max_a Q(S_{t+1}, a) - Q(S_t, A_t) \right] $$
$\max_a Q(S_{t+1}, a)$:下一状态 $S_{t+1}$ 所有可能动作的最大动作值
- 直接学习最优策略,而不依赖于当前使用的策略 ($\epsilon$-greedy 策略),能够更快找到最优解
| 特点 | Q-learning (Off-policy) | SARSA (On-policy) |
|---|---|---|
| 策略类型 | Off-policy:学习的是最优策略 | On-policy:基于当前策略更新 |
| 更新目标 | $R_{t+1} + \gamma \max_a Q(S_{t+1}, a)$ | $R_{t+1} + \gamma Q(S_{t+1}, A_{t+1})$ |
| 探索行为的影响 | 更新与探索行为无关,只考虑最优动作 | 更新考虑探索行为,基于当前策略 |
| 学习的激进程度 | 更激进,直接学习最优策略 | 更保守,考虑探索对学习过程的影响 |
| 适用场景 | 适合需要快速找到最优策略的场景 | 适合对探索行为敏感,需更稳定学习的场景 |
Expected SARSA
SARSA+Q-learning的结合
与 SARSA 和 Q-learning 相比,Expected Sarsa 在更新动作值函数时使用了期望回报,而不是基于单个动作的采样回报
更新公式
$$ Q(S_t, A_t) \leftarrow Q(S_t, A_t) + \alpha \left[ R_{t+1} + \gamma E_{a \sim \pi} [Q(S_{t+1}, A_{t+1})| S_{t+1} ] - Q(S_t, A_t) \right] $$
其中 $E_{a \sim \pi} [Q(S_{t+1}, A_{t+1})|S_{t+1}]$:在下一状态 $S_{t+1}$ 下,按照策略 $\pi$ 选择动作时的动作值函数的期望,进一步展开
$E_{a \sim \pi} [Q(S_{t+1}, A_{t+1})|S_{t+1}] = \sum_{a} \pi(a | S_{t+1}) Q(S_{t+1}, a)$
即对下一状态中所有可能的动作值 $Q(S_{t+1}, a)$ 加权求和,权重为当前策略 $\pi$ 对动作 $a$ 的选择概率
-
SARSA 的更新基于具体采样的下一动作 $A_{t+1}$, 而Expected Sarsa 则基于所有可能动作的期望回报更新,消除了由于采样引起的随机性
-
由于期望计算减少了采样的不确定性,Expected Sarsa 学习过程中的方差比 SARSA 和 Q-learning 更小,学习更加稳定
相比 SARSA:Expected Sarsa 更稳定,减小了由于单一动作采样造成的方差。
相比 Q-learning:Expected Sarsa 在高探索策略下更稳定,避免了完全依赖最优动作选择可能带来的不稳定。
Q-learning 是 Expected SARSA 的一种特例
当策略 $\pi$ 是greedy policy时,策略 $\pi$ 的定义如下:
$$ \pi(a \mid S_{t+1}) = \begin{cases} 1 & \text{if } a = \arg \max_a Q(S_{t+1}, a), \\ 0 & \text{else}. \end{cases} $$
将将贪婪策略代回 Expected SARSA的迭代公式,即可回到Q-learning的形式:
$$ Q(S_t, A_t) \leftarrow Q(S_t, A_t) + \alpha \left[ R_{t+1} + \gamma \max_a Q(S_{t+1}, a) - Q(S_t, A_t) \right] $$
Deep Q-Learning
from Q-learning to Deep Q-learning
Q-Learning 是一种表格方法,适用于状态和动作空间较小的情景
很直接的想法: 通过一个参数化的 Q 函数 $Q_{\theta}(s, a)$ 来近似 Q 值,而非使用 Q 表,也就是采用神经网络的方式。
损失函数:比较 Q 值预测和 Q 目标,使用梯度下降来更新 DQN 的权重
DQN 的稳定性问题:
-
Experience Replay:创建一个回放缓冲区存储经验元组,随机采样小批量元组进行训练;防止遗忘之前的经验,同时降低经验之间的相关性
-
Fixed Q-Target:TD 目标和 Q 值的估计都使用相同的网络参数,导致训练中 Q 值和目标值同步移动,产生震荡;可以使用一个单独的目标网络计算 TD 目标,每隔 C 步将 DQN 的参数复制到目标网络中
-
Double DQN:训练初期,选择下一状态最佳动作时可能高估 Q 值,导致学习复杂化;使用两个网络解耦动作选择和 Q 值目标计算,即使用 DQN 网络选择下一状态的最佳动作,使用 目标网络计算选择动作的目标 Q 值。