下半场的一年后
记得25年上半年,当时还在OAI的姚顺雨,在《The Second Half》中提出:
“I think we should fundamentally re-think evaluation. It means not just to create new and harder benchmarks, but to fundamentally question existing evaluation setups and create new ones, so that we are forced to invent new methods beyond the working recipe.”
AI 发展的"下半场"已经到来,而其中一个核心议题,就是对 evaluation 的重新思考。
站在26年的中旬,回头看,一切都变得很快,但一些不变的东西,依旧在那里。
热词从 context engineering 换到了 loop engineering,但把 Loop 拆开看,最核心的依旧是 Evaluator,决定了 loop 何时停止和提升信号。变的是包装,不变的是内核,只不过把过去不少手动的迭代过程,改成了自动实现罢了。
为什么传统开发直觉失效
随机性
工程师对"先建验证、再做优化"并不陌生。软件开发里,测试用例在需求阶段就该准备好,没有人愿意等到上线才发现系统不符合需求;机器学习里更是如此——训练开始之前先划好验证集,实验阶段靠指标快速试错,而不是把模型推上线再听天由命。评测先行,本来就是工程的老规矩。
如果 agent 开发只是把这套规矩照搬过来,事情就简单了。但这个类比失效了:软件测试是确定性的,而 LLM 系统的评估是统计性的。
在过去的单元测试里,只会有绿灯和红灯两种状态,跑一次和跑一百次没有区别。但在概率模型里,同一条 case 跑十次,可能八次成功、两次失败(pass@K or Pass^K)。这意味着,不再只是二元化的 pass / no-pass,而是需要引入统计语言(pass-ratio、方差、置信区间),每次测量都只是一个样本。
复杂度累积
传统系统的复杂来自组件数量,而每个组件本身是确定的;agent 系统则是非确定性 × 组件数量——模型、prompt、工具定义、检索、记忆、多轮编排,每一层都引入自己的随机性,而它们是串联在一起的。
换句话说,从早期测模型,到现在测试的是一整个系统(模型+harness),正如 Why benchmarking is hard 中提到的"许多变动的部件和自由度都会影响最终结果"。
当十个非确定性组件串在一起,任何局部改动的全局影响都超出了人脑推理的范围。这种影响无法事先推演,只能事后测量。我们面对的系统,已经越来越像自然界里的复杂系统:难以预测,只能观测——提出假设,做实验,看数据。
因此,归纳、演绎、控制变量的定性定量分析变得尤为重要。当然这也是一个前物理人在学校所接受到唯二有用的训练(另一个是如何在两个礼拜学完一门课并通过考试[doge])。
评估为什么必须先于优化
“评估先行"最容易被误解成"早点写测试”。
先有尺度,才有优化
优化至少需要三个前提:知道系统现在处于什么水平;知道希望它往哪个方向变化;能够比较修改前后的结果。三者依赖的是同一样东西——一把尺子。
没有评估,“变好了"只是一种感觉。必须先回答"什么叫好”。以一个客服 Agent 为例,“表现更好"至少可以指六件不同的事:回答更完整、回复更快、减少转人工、不做未经授权的承诺、提高一次解决率、提升用户满意度。它们不仅不同,还会互相冲突。
评估标准一旦定下,会反过来决定系统怎么被设计。
Eval 不是成绩单,而是目标函数
Agent 的优化几乎总是多目标的,一个指标的提升常常以另一个指标的退化为代价——局部变好,不等于系统变好。所以在动手优化之前,评估体系要先回答四个问题:核心目标是什么;哪些指标可以权衡;哪些指标不允许退化;哪些失败属于不可接受的红线。否则就是布朗运动。
评估并不是用来证明自己的。
先建回路
关于迭代效率。没有评估时,每一次修改都要靠人重新体验、讨论、争论,反馈以天计。有了最小评测集,迭代才成为闭环:
提出假设 → 修改系统 → 运行评测 → 分析变化 → 决定保留或回滚。
反馈从"以天计"变成"以分钟计”。回路建得越早,之后的每一次优化就越快。
有人会说:我们还在 demo 阶段,建这套东西太贵了。这个判断来自对"评测体系"的过重想象——要平台、要标注团队、要几千条数据。第一版根本不需要:20 到 50 条 case、一组指标、一段简易的评测脚本,半天时间。它很简陋,但已经能回答那个最贵的问题:这次改动,到底是变好了,还是变坏了?
人的位置在上移
在过去,我们逐行写代码。直到去年 coding-agent 开始,自主编码、跑测试、修复、提交,人已经跟不上 Agent 的输出速度了,逐个审查输出变得没有意义。反观从工业革命至今,人从来并非简单的直接被取代,而是在系统中不断上移——从执行者,到审查者,再到系统的设计者和观测者。
上移带来一个必须回答的问题:当你不再亲手做、也不再逐一看,你的判断力从哪里进入系统?
答案只剩一个通道:评估标准。你对"好"的定义、你的品味,都必须被编码成可执行的 Task、可判定的成功标准、可复跑的评测集。评测体系不是系统的附属品,它就是人类判断在自动化系统中的存在形式。
而"通过测量和反馈来优化一个无法直接推演的系统",这件事本身并不新鲜——它就是实验科学干了几百年的事。
结论
- Agent 行为需要统计测量
- 复杂系统需要实验而非直觉
- 评估不只是验收,而是开发基础设施
关于这个系列
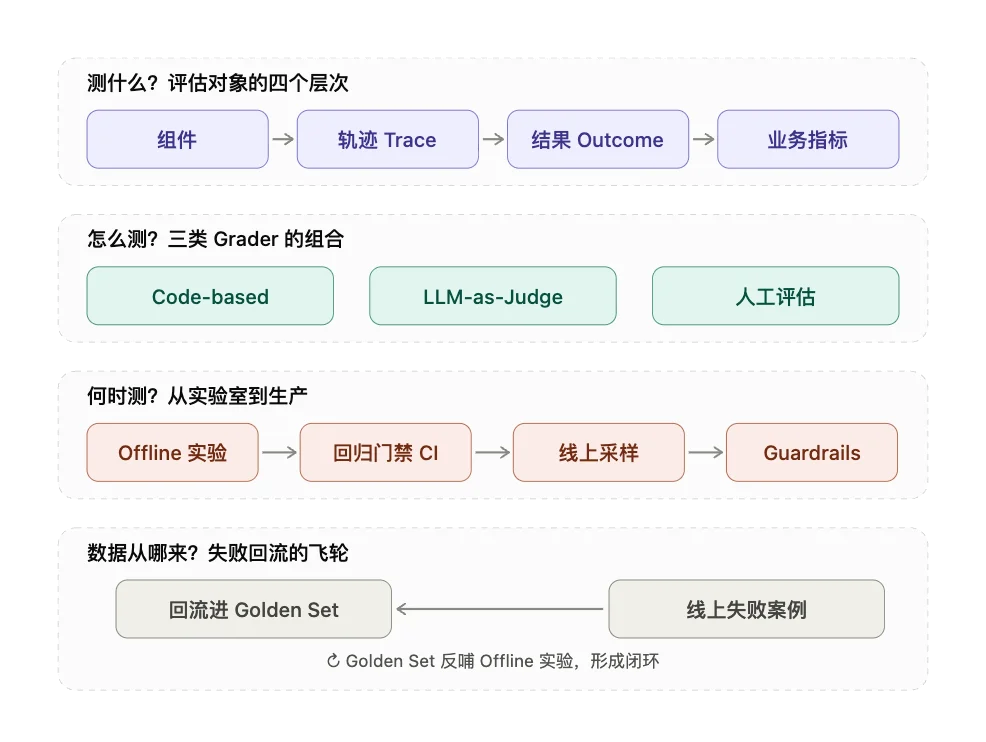
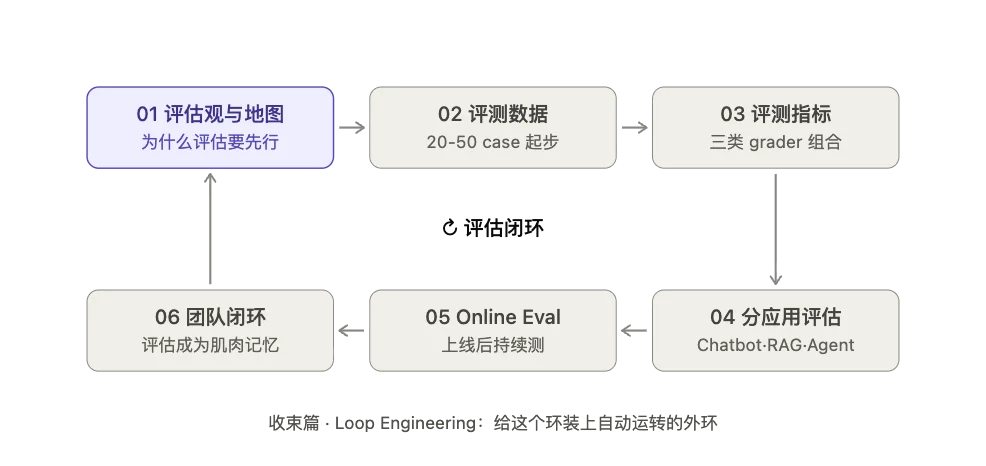
本文是《Agent Eval 实践指南》系列的开篇。这个系列试图回答一个问题:当系统的行为不再能被推理,我们如何知道它变好了?
为什么评估要先行(本篇)→ 第一套评测集怎么搭 → 指标怎么选 → Chatbot / RAG / Agent 分别怎么评 → 上线后怎么持续测 → 评估如何成为团队的工作方式。