对于agent-memory领域,避不开的两个核心(所有人都刷的)bench LoCoMo和LongMemEval,但这两个bench的高分真的能说明什么问题吗?以及在具体场景下,是否还有更加针对性的bench适合使用?memory的评测只看正确率吗?还有哪些评测指标,以及这些bench的数据合成流水线是怎么做的
这些是这篇文章尝试回答的内容。
Overall
agent-memory的相关bench,主要可以分为 对话记忆和agent 任务提升,前者关于是否能够记住用户的重要信息,后者关注agent的是否能够减少相同类型错误;
于是二者的评测角度也不同,毕竟对于后者可以采用常用的coding bench;本篇文章主要讨论前者。
memory benchmark 可以从两个正交的轴来看。
轴一:测什么内容/场景(横轴)——:事实性对话记忆(LoCoMo/LongMemEval)、个性化与用户建模(PersonaMem/PersonaLens)、经验性/环境记忆(LongMemEval-V2)。以及多模态。
轴二:测什么能力维度(纵轴)——lifecycle abilities(更新/冲突/遗忘/拒答/时间演化)。这是切穿所有场景的评估维度。
Long-term conversational memory
Personal Memory 最早、也最常被评估的一类,是 long-term conversational memory:给定跨越多轮、多 session 的历史对话,测试 agent 是否能记住用户相关信息,并在之后的问题或回复中正确调用。
这一类 benchmark 和传统 long-context QA 很接近。重点考察agent 能不能在很长的对话历史中(long-session和跨session),找到、理解并使用和用户有关的记忆。
LoCoMo
LoCoMo(Long Conversation Memory);agent-memory 领域最常被引用的 benchmark 之一。
LoCoMo 的数据由机器—人类混合流水线生成;先基于预定义 persona 和时序事件图,让两个 LLM agent 生成长对话骨架;再由人类标注者对对话进行验证和编辑,以保证长程一致性、事件 grounding 和多模态内容的合理性。公开版本包含 10 段超长对话,每段平均约 300 轮、9K tokens,最多跨越 35 个 session。
LoCoMo 设计了三个评估任务。
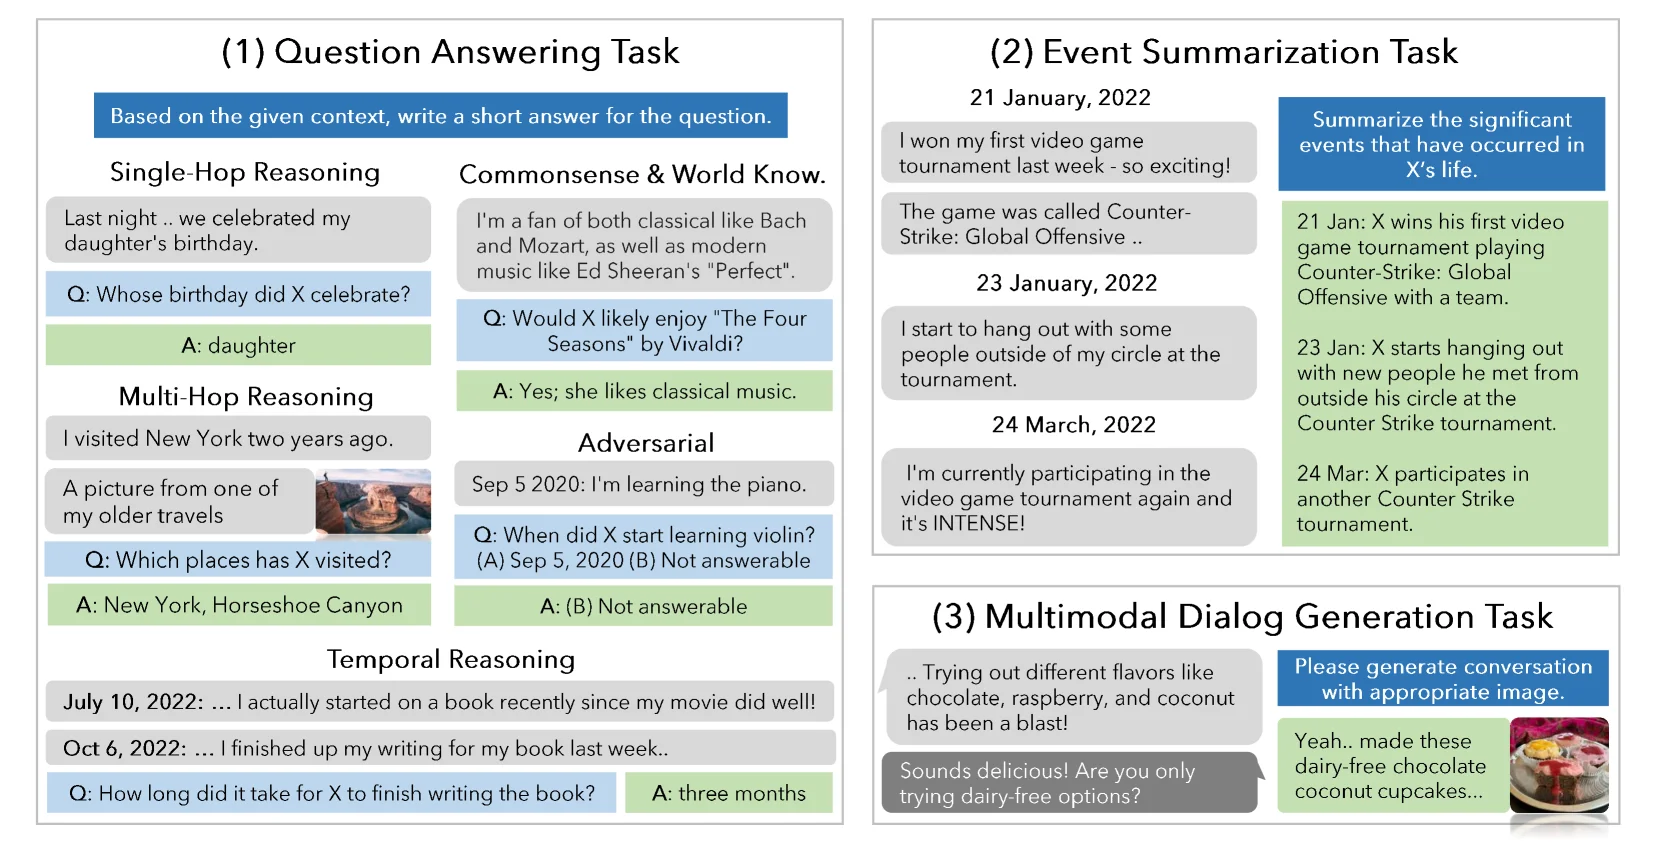
第一个任务是 Question Answering。这是后续 memory system 论文最常使用的部分。QA 问题被分成五类:
| 类别 | 测什么 | 难点 | 题目数量 |
|---|---|---|---|
| Single-hop | 单 session 内的事实回忆 | 从某一处对话中直接找到答案 | 841 |
| Multi-hop | 跨多个 session 综合信息 | 需要拼接多处证据 | 282 |
| Temporal reasoning | 时间推理 | 理解“之前”“之后”“几个月后”等时间关系 | 321 |
| Open-domain / commonsense | 对话信息 + 外部常识 | 不是纯检索,需要结合常识推断 | 96 |
| Adversarial | 不可回答或陷阱问题 | 防止模型在长上下文中幻觉回答 | 446 |
第二个任务是 Event Summarization。模型需要把对话历史总结成时序事件图,考察其是否理解长期对话中的事件、因果关系和时间顺序。
第三个任务是 Multimodal Dialogue Generation。LoCoMo 的对话中包含图片分享与图片反应,因此这个任务评估模型能否结合过去对话和多模态线索,生成连贯、符合人物状态和长期叙事的回复。
从数据结构上看(locomo10.json),json-array 每个元素代表一段完整的长对话及其标注。
评估方式与评价指标。评估不是 LLM Judge 主导。
-
QA:normalized / partial-match F1;RAG 还额外看 retrieval recall / recall@k。
-
Event Summarization:ROUGE + FactScore,其中 FactScore 会拆 atomic facts,计算 precision / recall / F1。
-
Multimodal Dialogue Generation:BLEU-1/2、ROUGE-L、MM-Relevance。
不过其限制也很明显。公开版本平均长度约 9K tokens,在 2026 年已经不足以真正拉开长上下文模型之间的差距。其次,后续很多工作主要使用 LoCoMo 的 QA 部分,把它退化成了一个文本检索/问答 benchmark;事件摘要和多模态对话生成任务在实际系统比较中使用得并不充分;
因此,后续出现了一些针对性修正,例如 LoCoMo-Plus 和 LoCoMo-Refined。LoCoMo-Plus 的方向尤其值得注意:它试图从表层 factual recall 转向 cognitive memory,也就是测试模型能否在后续场景中应用早先对话里隐含的用户状态、目标、价值观和约束。
📄 LoCoMo-Plus 论文 · LoCoMo-Refined GitHub 仓库
LongMemEval
相比 LoCoMo,LongMemEval 更直接地面向 chat assistant 的长期交互记忆,目标是评估 assistant 是否能在持续、多 session 的用户交互中记录、检索、更新和推理用户信息。
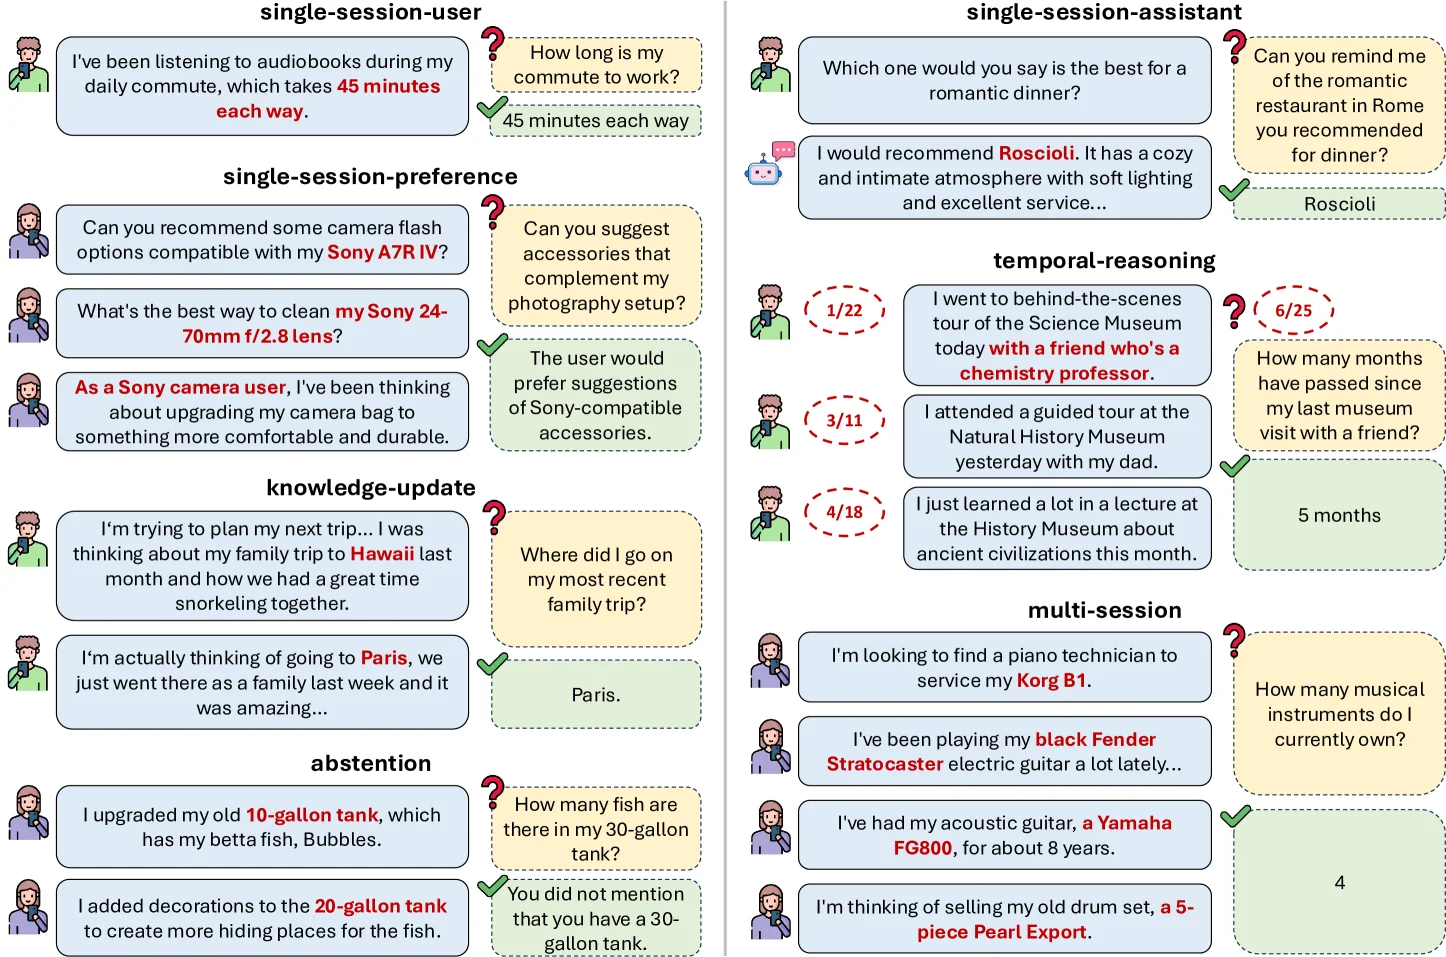
LongMemEval 包含 500 个问题,覆盖五类长期记忆能力
| 能力 | 含义 |
|---|---|
| Information Extraction | 从长交互历史中回忆具体信息,包括用户或 assistant 曾经提到的细节 |
| Multi-Session Reasoning | 跨多个 session 综合信息,完成聚合、比较或推理 |
| Knowledge Update | 识别用户信息的变化,并用新信息更新旧记忆 |
| Temporal Reasoning | 理解用户信息中的时间属性,包括显式时间和 session timestamp |
| Abstention | 面对历史中没有提到的信息时,知道应该拒答而不是编造 |
LongMemEval 提供了不同难度设置。LongMemEval-S 的每个问题历史约 115K tokens,通常包含 30–40 个 session;LongMemEval-M 则扩展到约 500 个 session、1.5M tokens。这使其比 LoCoMo 更适合测试真实 personal assistant 在长期使用中的 memory scalability。
评估方面,LongMemEval 采用 LLM-as-a-Judge,由 GPT-4o 判断模型回答是否正确。也提出了一个很有用的 memory system 分析框架:把长期记忆系统拆成 indexing、retrieval 和 reading 三个阶段。
从 Personal Memory 的角度看,LongMemEval 比 LoCoMo 更接近真实用户助理场景。它不仅测试“是否记得”,还测试用户信息是否会随时间更新、是否能跨 session 综合、是否能处理时间线,以及是否能在信息缺失时拒答。
不过,LongMemEval 本质上仍然是一个 long-context QA / retrieval-oriented benchmark。它的核心评估形式仍是从历史聊天中找到证据并回答问题。但现实 Agent 更难的是状态是动态的,因而benchmark 容易被 retrieval engineering。
从 LongMemEval 到 LongMemEval-V2
“聊天助手能不能记住长期对话” -> “Agent 能不能在复杂环境中形成长期经验记忆”。
V2 的对象不再是普通 user-assistant chat history,而是 web-agent trajectories,对应测试的五类 memory ability:
| V2 能力 | 含义 |
|---|---|
| Static state recall | 记住环境中的静态信息,例如页面布局、模块功能、重要位置 |
| Dynamic state tracking | 跟踪状态和动作如何随时间改变环境 |
| Workflow knowledge | 记住在特定环境中完成 recurring tasks 的流程 |
| Environment gotchas | 识别反复出现的局部失败模式和环境陷阱 |
| Premise awareness | 知道哪些在其他环境成立的前提,在当前部署中并不成立 |
V2 的上下文规模暴涨:
-
small tier:25M tokens
-
medium tier:115M tokens
这已经远超主流 context window。
这大概整个 AI memory research 最近一年最大的方向变化之一。
“LLM 如何记住长期对话” → “Agent 如何积累长期工作经验”
或者说 chatbot memory → agentic / experiential memory。
从数据合成pipeline角度;
LongMemEval 的构造思路是:先设计要测试的用户记忆,再把这些记忆嵌入长聊天历史。大致分为三步:
-
question curation: 定义了一个包含 164 个用户属性的 ontology(如lifestyle、belongings等)利用 LLM 为每个属性生成用户背景段落,再从这些背景中生成候选 question-answer pairs(人工筛选、重写和难度调整), 标注者会将答案拆解成一个或多个 evidence statements(有些 evidence 带时间信息)
-
evidence session construction: 将每条 evidence statement嵌入到一个 task-oriented user-assistant session 中,使用 self-chat 方式生成对话,用户不会直白地说出 evidence,而是在请求帮助、咨询建议或完成任务的过程中间接透露信息
-
history compilation: 把相关 evidence sessions 插入到一串更长的 user-assistant chat history 中;无关 session 来自两类来源,根据其他不冲突用户属性合成的 self-chat sessions,以及ShareGPT 和 UltraChat;为所有 session 分配合理时间戳,从而形成一个 coherent、length-configurable 的长期聊天历史
本质依旧是needle-in-a-haystack for personal memory。
相比之下,LongMemEval-V2 的构造思路是:先收集 agent 在环境中执行任务的轨迹,再从轨迹中抽取一个有经验的 agent 应该记住的知识
大致分为四步。
-
trajectory collection:从 WebArena、WorkArena 和 WorkArena++ 中收集 web-agent trajectories, 轨迹通过 AgentLab 统一接口采集,每条 trajectory 包含任务目标、状态观察、截图、accessibility tree、动作以及状态转移;通过 rejection sampling 收集成功和失败轨迹
-
question annotation: 问题围绕五类 memory ability 构造:static state recall、dynamic state tracking、workflow knowledge、environment gotchas 和 premise awareness;并测试模型能否在没有 trajectory evidence 的情况下回答候选问题,能则过滤或改写(避免模型凭公共知识答题)
-
answer trajectory labeling: 每个问题都需要标注哪些 trajectories 真正包含答案证据,要求 evidence 能在截图或轨迹状态中被验证 (通过一批 seed answer-bearing trajectories 配合Codex 辅助扩大候选标注范围,最后由人工验证 ambiguous cases)
-
haystack creation: Small tier 会为 WebArena 和 ServiceNow 各构造一个共享的 100-trajectory haystack;Medium tier 则为每个问题构造约 500 条 trajectory 的 question-specific haystack
EverMemBench
从双人对话到多人协作。一个长期嵌入团队协作的 agent,能不能在多人、多组、多时间线的环境中维护记忆。
EverMemBench 模拟企业协作场景。数据包含多个项目、子项目、员工、群组对话和带证据的 QA。整体结构更接近:
project
  ├── sub-project / group chat
  │     ├── day 1 messages
  │     ├── day 2 messages
  │     └── ...
  ├── employees / personas
  ├── task timeline
  └── QA items with evidence references
评估 pipeline :
Add → Search → Answer → Evaluate
EverMemBench 的 QA 按三大维度、九个子任务组织
| 大类 | 子任务 | 数量 | 主要看什么 |
|---|---|---|---|
| Fine-grained Recall | Single-hop Retrieval、Multi-hop Trajectory、Temporal Duration | 762 | 是否能找到精确事实、链接、日期、人物、任务状态 |
| Memory Awareness | Constraint、Proactivity、Update | 1,097 | 是否能把过去规则、约束、更新应用到新场景 |
| Profile Understanding | Style、Skill、Role | 541 | 是否能基于长期互动理解人的风格、技能和角色 |
EverMemBench 的评价方式可以分成两层:任务协议和打分方式。
任务协议上,它采用 streaming multi-group protocol:系统在 ingestion phase 按时间顺序接收 daily batches,需要自己维护 memory state;evaluation phase 再提出问题。这种协议可以测试系统在持续接收信息时如何写入、更新、检索和使用记忆,而不是一次性把历史塞进上下文。
打分方式上:
| 问题类型 | 评价方式 |
|---|---|
| Multiple-choice | 直接判断 A/B/C/D 是否正确 |
| Open-ended | LLM-as-a-Judge 判断 generated answer 和 gold answer 是否语义等价 |
| Memory system | Add → Search → Answer → Evaluate |
| Full-context LLM | 直接把完整 dialogue 作为上下文,不经过 retrieval |
数据构造可以概括为:
blueprint and profile generation
→ chunk-wise dialogue synthesis
→ evidence-grounded QA construction
User Profiling and Personalization
PersonaMem
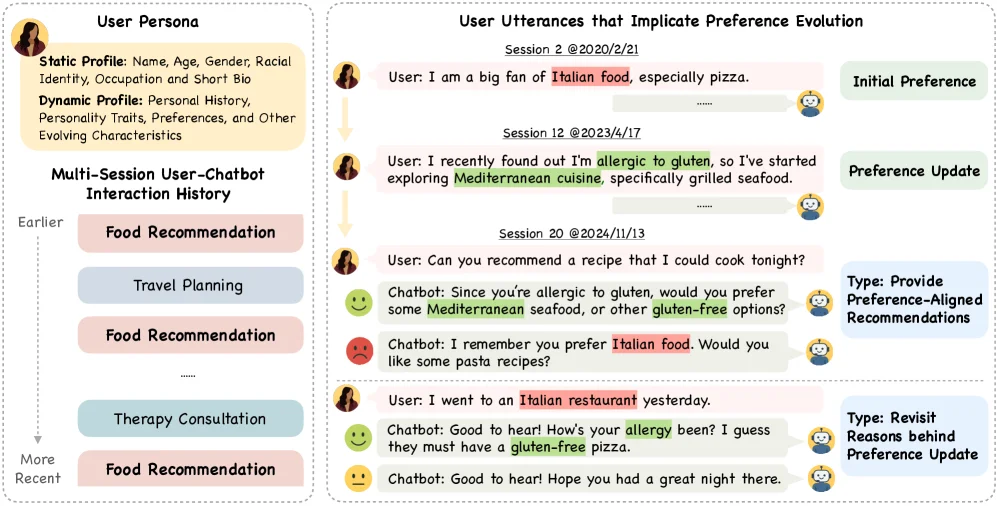
核心不是“能不能背出某个事实”,而是:模型能否在长程、多轮、多 session 的用户交互历史中,形成和更新用户画像,并把最新用户状态用于个性化回答
三个能力:模型是否能内化用户固有特征和偏好,是否能追踪用户画像/偏好的时间演化,以及是否能在新场景中据此生成个性化回应
把问题设成:给定某个时刻以前的用户-LLM 互动历史和一个“第一人称”的 in-situ user query,模型要选出最符合当前用户状态的回答
测的是四件事
记住用户说过的 facts / preferences:例如用户曾说喜欢某类音乐、饮食、学习方式。
更新记忆:用户偏好会变,模型不能只记旧偏好,例如从喜欢披萨变成因为麸质过敏而转向 gluten-free。
从历史中检索相关片段:信息可能出现在很长的历史中,甚至有 “lost in the middle” 问题。
把记忆用于回答,而不是仅仅复述:最难的是基于用户当前偏好给出新推荐,或迁移到新场景。v1 发现模型在简单事实回忆上还可以,但在“给新建议”“跨场景应用用户偏好”上明显更弱
v1 数据规模:约 20 个 personas、180+ interaction histories,每条 history 最多 60 个多轮 sessions,覆盖 15 个个性化任务场景;HF 数据集提供 32k、128k、1M 三种上下文长度版本
设计了 7 类 in-situ user query,用来覆盖不同 memory / personalization 技能
| 类型 | 测什么 |
|---|---|
| Recall user-shared facts | 记住用户曾分享的事实、活动、兴趣 |
| Suggest new ideas | 推荐历史里没出现过的新东西,同时符合用户约束 |
| Acknowledge latest user preferences | 识别用户最新偏好,而不是旧偏好 |
| Track full preference evolution | 追踪偏好从过去到现在的完整变化 |
| Revisit reasons behind preference updates | 记住偏好变化背后的原因 |
| Provide preference-aligned recommendations | 主动给出与当前偏好一致的建议 |
| Generalize to new scenarios | 把从其他场景学到的用户特征迁移到新任务 |
v1 主评估是 4 选 1 multiple-choice accuracy:模型看到完整对话历史、当前 user query、四个候选回答,选择最符合当前用户画像的回答
V2 改进版本
| v1 的问题 / 局限 | v2 的对应修改 |
|---|---|
| 规模较小:v1 只有约 20 personas、180+ histories、15 个任务场景 | v2 扩展到 1,000 personas、26,100 preferences/Q&A pairs、325 conversation topics、335 user query topics。 |
| 偏好较显式:v2 论文指出 v1 仍主要关注 explicit preferences | v2 主打 implicit personas / implicit preferences,让偏好隐藏在 email rewriting、translation、knowledge query、photo sharing 等真实交互里。 |
| 评估更偏选择题:v1 主评估是 MCQ,生成式评估受 logits 可得性限制 | v2 同时提供 MCQ 和 open-ended,open-ended 使用 LLM-as-a-judge;论文称用三个 GPT-5-Chat judge 聚合判断。 |
| 缺少训练/验证集用于改进模型 | v2 不只是 benchmark,还提供 train/val/test:text benchmark 5,000、train 18,500、val 2,600;multimodal benchmark 5,000、train 19,200、val 2,110。 |
| 真实使用中的 privacy/control 问题不足 | v2 加入用户泄露敏感信息、用户要求“不要记住某偏好”等场景,并要求 target answers 避免使用敏感/私密信息。 |
| 更像长上下文测试,成本高 | v2 提出/评估 agentic memory:把长历史压缩成约 2k-token、可读、可更新的 memory;论文称相对 32k 上下文约 16× 更省 token,并在 MCQ/open-ended 上超过直接长上下文模型。 |
| 用户偏好 vs 他人信息容易混淆 | v2 数据列显式标注 who,区分当前 preference 属于用户本人还是他人,并加入与 persona 无关的数学/代码问题作为干扰。 |
| 单模态/场景覆盖有限 | v2 有 text 与 multimodal 两套 benchmark,并包含 multimodal photo sharing、multilingual translation、health/medical、therapy 等场景。 |
v2 的定位有一个明显转向:从“显式/动态偏好记忆”升级为“隐式偏好推断 + 可训练的 agentic memory”。
v2 特别关注用户偏好不是直接说出来,而是隐含在长对话中的情况;例如用户让模型润色邮件时,邮件内容可能无意透露季节性过敏
v2 的每条 benchmark row 包含:persona_id、完整 persona 文件路径、32k/128k chat history 链接、user_query、correct_answer、三个 incorrect_answers、当前 preference、偏好类别、相关对话片段、该偏好是否属于用户本人、是否更新过、旧偏好、敏感信息、相关片段到 query 的 token distance 等
v2 的评估指标主要是:
-
MCQ accuracy:模型从四个合理选项中选择最个性化的答案。
-
Open-ended personalization accuracy / judge score:模型直接生成回答,再由 LLM-as-a-judge 判断是否体现了 ground-truth preference;论文报告用多个 GPT-5-Chat judge 聚合。
-
分组分析:按 preference type、scenario、是否 dynamic update、who、相关片段距离等维度拆解性能。官方评估脚本也会生成这些 category breakdown。
PersonaLens
PersonaMem 把个性化当成一道记忆 QA, PersonaLens更关注,在完成任务的过程中,个性化会不会被任务目标挤掉。
构成上,它有 1,500 个用户画像(demographic 属性取自 PRISM Alignment 数据集,偏好由 LLM 基于 demographic 生成以保证内部一致),覆盖从 Books、Finance、Flights 到 Restaurants 等约 20 个领域。
评测方式:双 agent 自动评测, 一个 user agent(用 Claude 3 Sonnet 实现)模拟带特定画像和情境的用户去和被测助手对话,一个 judge agent 用 LLM-as-a-Judge 评个性化、回应质量与任务完成度,并区分单领域(TSD)与多领域(TMD)任务。
一个核心发现, 任务完成率(TCR)和个性化之间存在权衡——助手越是埋头把任务做完,越容易忽略用户偏好。
相反,静态 QA 里不存在"任务目标"这个会和个性化抢注意力的竞争项。
多模态个人记忆
记忆的来源是文字。但真实的个人记忆显然不止于此。
agent 能否跨文本、图像、视频建立长期记忆,并在后续任务中调用它们。
很多所谓的多模态记忆,图像只是被 caption 成文字、再塞回文本 pipeline。LoCoMo 自己就带多模态部分(图片分享),但后续绝大多数工作都把它退化成纯文本 QA 在用。
实际上可以从,多模态在哪个环节中起作用,来看其究竟在测什么。
输入/存储端:跨会话保存视觉信息。
用户在早先的会话里分享了一张图,后续要记住图里的内容。
如 Mem-Gallery,明确指出现有 benchmark 要么在纯文本多会话里评记忆、要么在单会话局部里评多模态理解,没有一个真正评估多模态记忆在长期对话轨迹中如何被保存、组织和演化。沿三个维度评估——记忆抽取与测试时适应、记忆推理、记忆知识管理。
检索端:在视觉历史里做跨模态检索。 存下来只是第一步,能否按当前需求把对的图/帧找出来是另一回事。
叠加个性化:多模态 × 用户建模
Persona-MME 面向长期个性化的多模态 LLM,构造持久的多模态 persona 上下文(用户画像、常出现的社交关系、用户拥有的物品),再生成显式实体、隐式事实、干扰项三类多模态对话来控制引入的记忆信号。
叠加真实/具身场景。属于具身/世界模型方向。如第一人称视角(egocentric)的可穿戴助手、机器人记忆、视频世界模型的记忆能力等。(暂不属于本篇的讨论范畴)
正面看,Mem-Gallery、MemLens 这批 2026 年初的工作,是对"图像被 caption 掉"的纠正。
但这一类整体还很年轻,没有收敛出 LoCoMo 那样人人都刷的标杆,各家的模态覆盖、任务形态、评测口径都还不统一。
记忆生命周期能力
前面几类是按"测什么内容"划分的:对话事实、用户画像、多模态。
而agent 会不会更新旧记忆、能不能处理冲突信息、知不知道什么时候该遗忘或拒答、能不能追踪偏好随时间的变化。这些就是记忆的生命周期(lifecycle)能力。
lifecycle 这块是碎片化的、按单一能力切分的一堆专项 bench,且大多是 2025 下半年到 2026 年才涌现的。这本身就是一个信号:这个领域刚刚意识到"正确率不够",专项评测才开始出现,还没有收敛。
下面按能力维度组织,每个维度几个代表 bench,以及它对应的、区别于正确率的指标。
更新(Update)
记忆系统要记住最新版本,而不是最先说的那个。
这一维度 LongMemEval 已有专门的 knowledge-update 子集(前面介绍过)。更进一步的是把它做成指标而非仅仅数据:有工作提出 Forgetting-Aware Memory Accuracy,专门惩罚对过期或失效记忆的依赖。
冲突(Conflict resolution)
记忆里出现自相矛盾的两条信息时,系统能不能只让最新、正确的那条生效?
MemoryAgentBench 关注了:把记忆能力拆成准确检索、测试时学习、长程理解、冲突消解四项,并为冲突设了专门的 Conflict Resolution Accuracy,确保有矛盾时只有最新的有效事实被采用
遗忘(Forgetting / 选择性保留)
不是所有信息都该永久保留:过期的、用户明确要求"别记住"的,都应该被丢弃。
MemoryAgentBench 用它新构造的 FactConsolidation 数据集专门测选择性遗忘。
而用户主动要求遗忘和隐私相关,如PersonaMem-v2 的隐私场景(用户要求不要记住某偏好)。
拒答(Abstention)
不知道就说不知道。记忆系统要能识别"证据不足"并拒答,而不是幻觉。
LongMemEval 专门设了 abstention 类问题来测这一点,对应的指标是 abstention rate / 拒答的准确性,同样不是普通正确率能覆盖的。
从被动回忆到记忆驱动行动
MemoryArena 显示,在 recall benchmark 上接近满分的模型,一旦记忆需要驱动行动就急剧下滑。很多所谓记忆 benchmark 本质是 retrieval benchmark,测的是"针找不找得到",而不是"记忆能不能真正被用起来"。
评估指标:除了正确率之外
如果只看正确率,会漏掉什么?
借用一个现成的分层框架。近期一篇 memory survey 提出的 four-layer evaluation stack 把指标分成四层,正好可以作为这一节的骨架。
Layer 1:任务效果(Task effectiveness)
任务到底做成了没有。
常见指标是 success rate、factual correctness、plan completion rate。落到对话记忆的 QA 形态上,就是我们前面反复见到的那些:token-level F1、BLEU、LLM-as-a-Judge 的二元/打分判定、以及 MCQ accuracy。
这些指标彼此并不等价,选哪个会改变结论。即使LLM-as-a-Judge 更贴近语义正确性,但引入了 judge 自身的偏置。
这时候"谁是 SOTA"取决于信哪个指标。
Layer 2:记忆质量(Memory quality)
关键指标包括:检索到的记录的 precision/recall、contradiction rate(矛盾率)、staleness distribution(过期分布)、以及对任务相关事实的 coverage。
有工作在 LongMemEval-S 上,仅靠检索就能把某类问题的召回刷到近 99%——但这是检索召回,不是端到端正确率。
staleness distribution 和 contradiction rate 关注的是"记忆里有多少已经失效或自相矛盾的内容"。
相应地也出现了专门的指标,比如惩罚"依赖过期记忆"的 Forgetting-Aware Memory Accuracy,以及确保矛盾信息只有最新版本生效的 conflict resolution accuracy。
Layer 3:效率(Efficiency)
核心指标:latency per memory operation、记忆内容占用的 prompt tokens、每步的 retrieval 调用次数、以及存储随时间的增长。
这里有个测量方法学的细节值得注意:严谨的工作(如 HiMem)在报告 latency 时,只算记忆检索本身的耗时,排除 LLM 推理,以隔离记忆系统的效率、避免被底层模型的快慢污染。读效率数字时要留意它到底量的是哪一段。
Layer 4:治理(Governance)
记忆系统在隐私和控制上守不守规矩。
指标包括:privacy leakage rate(隐私泄露率)、deletion compliance(删除合规——用户要求"别记住/删掉"时是否真的照做)、access-scope violations(越权访问,尤其在多用户共享记忆的场景)。
PersonaMem-v2 已经把这类场景纳入:用户泄露敏感信息、或明确要求"不要记住某个偏好",而模型的 target answer 被要求避免使用这些敏感/私密信息。
这四层之间往往是trade-off的。
所以完善的系统评测,应该是在四层上给出一条操作曲线(accuracy / store-size / latency 之间可调的权衡),而不是一个孤立的最高分。
数据合成方法
讨论任何一个Memory benchmark 之前,都应该先问一个更基础的问题:这些多轮对话是怎么造出来的?因为合成方式几乎决定了这个 benchmark 真正在测什么,以及它先天测不了什么。
目前主流 bench 的对话来源大致分三档
-
纯人工真实数据(几乎不存在)
-
LLM 生成骨架 + 人工校验(LoCoMo为代表的,基于预定义 persona 和时序事件图,用 LLM agent 架构生成对话骨架,再由人工标注者验证、编辑,以保证长程一致性)
-
needle-in-a-haystack拼装式:LongMemEval为代表,问题由人类专家撰写,承载答案的证据 session 由 LLM 模拟并人工编辑,而占绝大多数的无关 session 则从 ShareGPT、UltraChat 和模拟对话里采样
个性化类的 bench 则更依赖 persona 驱动的全自动合成。PersonaMem 用 GPT-4o 驱动的模块化 pipeline,从 persona 出发生成多会话、带时间线的交互历史,并在对话中植入随时间演化的偏好;它的 in-situ query 是把用户当前的第一人称提问附在历史末尾,以此测"模型能否用最新偏好作答"。
由于needle-in-a-haystack 本质上还是大海捞针测试,测的很大程度上是长上下文里的检索能力,而非记忆系统的组织与演化能力。
LongMemEval 在挑选haystack session 时,刻意选取与证据话题、格式相近,但不引入冲突信息的 session,以免让问题失效。这个工程上合理的选择,恰恰意味着这个 benchmark 从构造起点就回避了知识冲突——所以它天然测不了冲突消解能力。
此外,对"LLM 生成的数据是否可信"的常见担忧,答案不在于 LLM幻觉本身,而在于生成之后的过滤和检查。如PersonaMem-v2 :对每个 Q&A 施加四条硬性过滤——不看历史就必须答不出(杜绝题目泄露和生成 artifact)、正确选项须真实反映用户偏好、错误选项一律不得反映、格式不得残留生成痕迹;最终只有约三成生成的 Q&A 能全部通过。
通过率本身也反映了,未经严格过滤的合成对话里,有相当比例存在可被模型走捷径的漏洞。
所以合成 pipeline 关系到了其能力边界本身。
结尾
没有任何单一 benchmark 能同时覆盖agent-memory这件事的全部。每一项都需要专门构造的数据和专门设计的指标,事实回忆、个性化推断、多模态、更新、冲突、遗忘、拒答、记忆驱动行动等等。
所以当一个 agent-memory 项目宣称自己又 SOTA 了,值得追问的始终是同一串问题:它在哪个 bench 上 SOTA?那个 bench 测的核心是什么能力,又漏掉了哪些性质?它的数据让它能测什么、注定测不了什么?它报告了哪几层指标,没报告的那几层是不是正好是它牺牲掉的?