引子
“今天你 Harness 了吗?”
2026 年,“Harness"大概是 AI Agent 领域被用得最多的一个词,也伴随着巨大的误解。反观过去这 2-3 年内 AI 发展,伴随的是如雨后春笋般出现的各式各样 agent 框架、脚手架和编排工具,大多也深陷技术债的泥潭,从此销声匿迹。
在本文中,先不谈宏大的 Harness Engineering(笔者认为这个词更多包含了让 Agent 自我迭代优化的含义),只聊聊 Harness 本身。
这篇文章只回答一个问题:一个面向未来的、最小化的 Agent Harness,到底由哪些不可替代的核心组件构成?
以及,在当下的技术语境里,如何摆脱过去两年积累的技术债,选择或开发一个合适的 Agent Harness。
造好 Harness,Agent 会完成剩下的。
正本清源:Harness 到底是什么
要搞清楚 Harness 到底是什么,需要先做一点简单的赛博考古。
在传统软件工程中,Test Harness(测试自动化框架) 指的是为了执行测试而建立的自动化环境,核心目标是“去人工化”。
而在 LLM、Agent 领域,harness 起初更多被用在 LLM 评测语境下,如 SWE-bench 等复杂的评测基准中,单纯的 LLM 无法拿高分,需要一套外置循环和工具来辅助测试。此时,Harness 仅限于 Eval 领域。
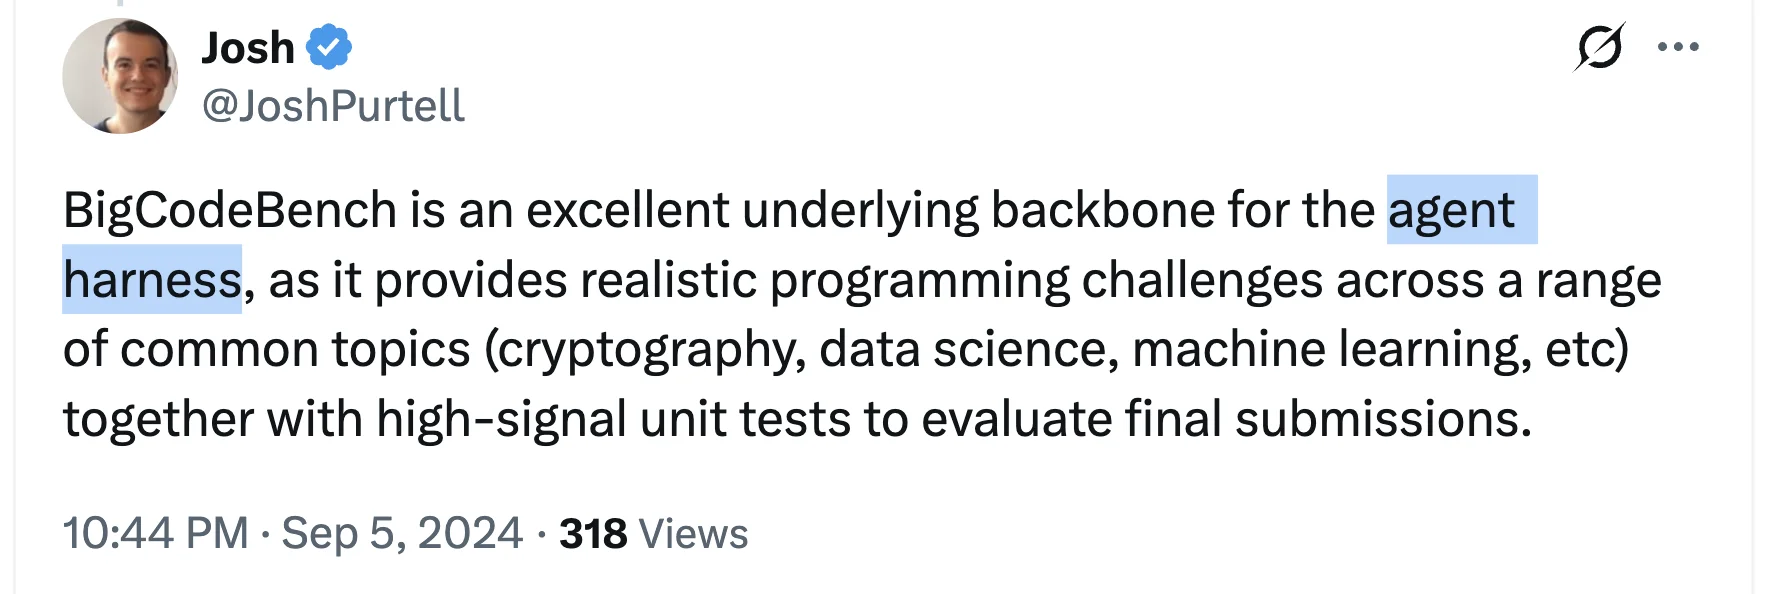
直到 Claude-Code 等应用的出现,agent harness 逐渐有了新的含义:支撑 AI 工作的底座。
目前能找到最早的来源, 2025 年 9 月 23 日,开发者 Vivek Trivedy 在博客中首次系统阐述“agent harness”。
“Agent Harness: External set of functionality to enhance a model’s runtime execution. …
而真正的爆火,来自 Anthropic: Effective harnesses for long-running agents (Nov 26, 2025) 和 OpenAI: Harness engineering: leveraging Codex in an agent-first world (Feb 11, 2026) 的两篇文章。
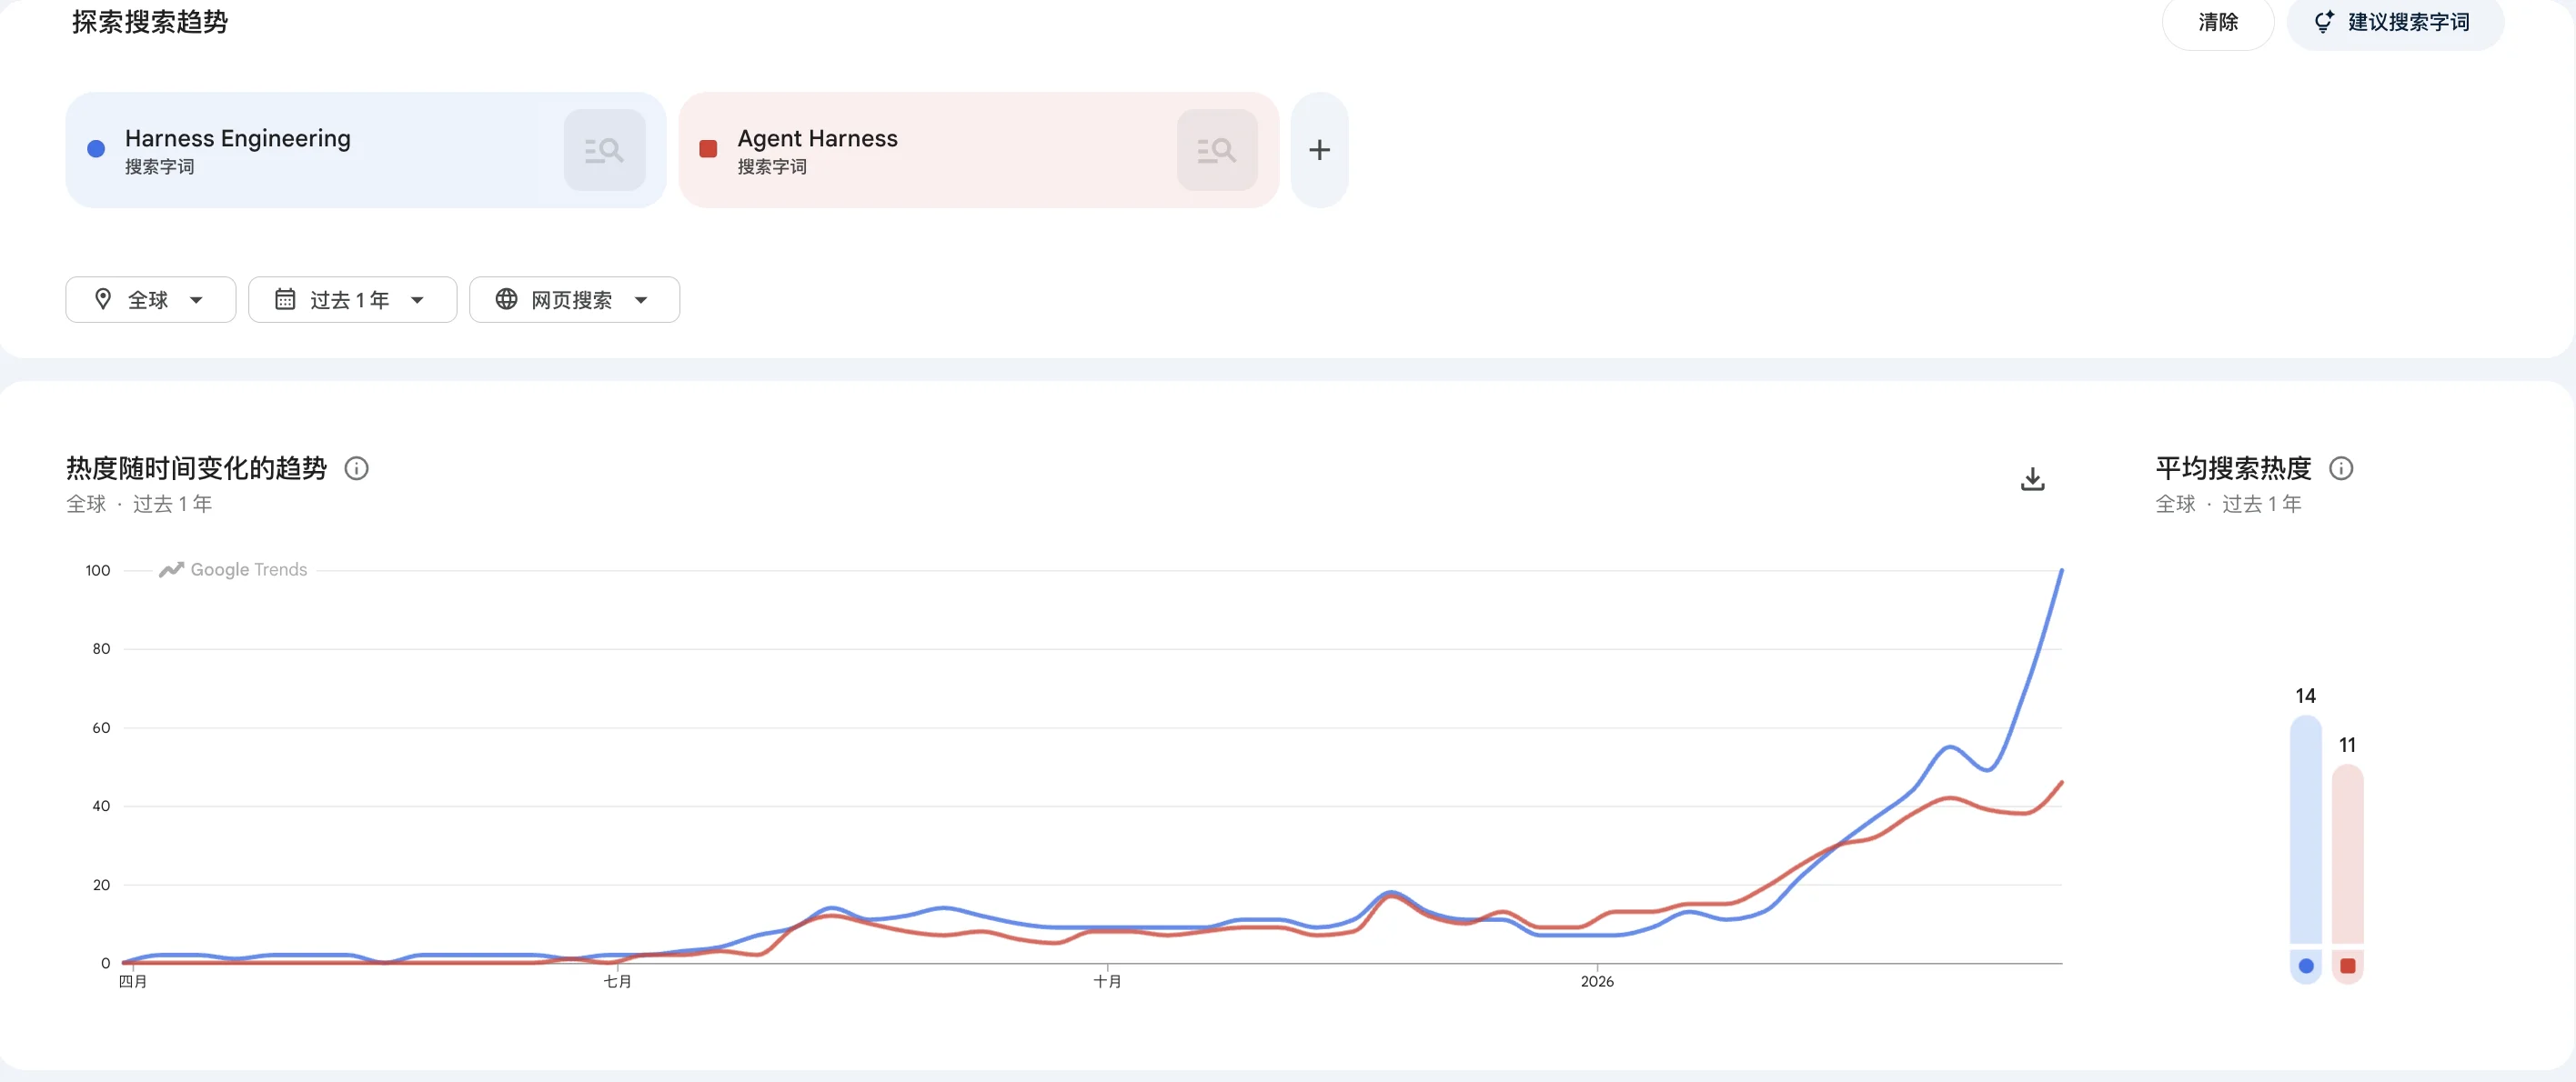
简单来说,如果用一句话定义: Harness 就是包裹在 LLM 外面的软件外壳——它把一个只会说话的模型,变成一个能做事的 Agent,甚至是能持续运行数小时的 long-running Agent。
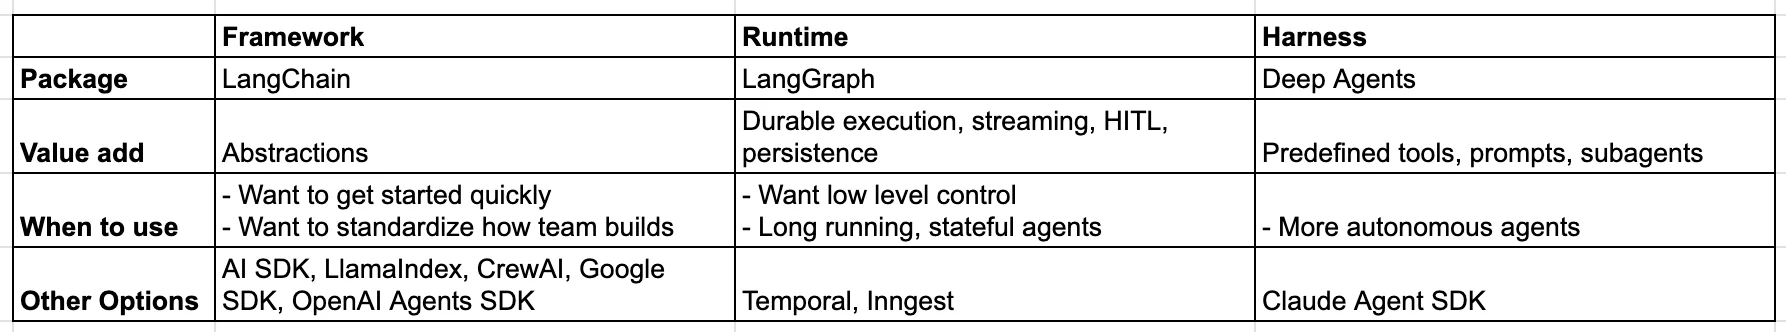
包括 LangChain 在内的各种生态为了跑马圈地,创造了无数概念把人搞得云里雾里,所以,Agent Frameworks, Runtimes, scaffolding, Harnesses 这些词究竟有什么区别?
结合 LangChain 的文章:Agent Frameworks, Runtimes, and Harnesses - oh my!
-
Runtime:解决“agent 怎么在生产里稳定、可持久地跑”的底层基础设施。
-
Framework:提供一套抽象和编程模型,帮你“更容易写 agent 应用”。
-
Harness:在 framework 之上加上默认配置、工具和工作流,做成“拿来就能跑任务的高层套件”。
(概念都是人造的,都是先有了物,才有了概念)
设计哲学:Less is More
从 How To Be A World-Class Agentic Engineer 以及 Learning the Bitter Lesson 中所总结的经验和教训便是:Less is More。各种人为加入的结构或偏置虽然短期有用,却会在长期成为限制,应随着模型和计算能力提升逐步去除。
具体来说,The Bitter Lesson 在 Agent 领域的推论:
在 Harness 中写的每一行"聪明"的控制逻辑,都是在和未来的模型能力对赌。如:
-
2024 年你写了精巧的 ReAct 状态机 → 2025 年模型原生支持多轮工具调用,你的状态机成了负担
-
2025 年你写了复杂的 Planning 模块 → 2026 年模型的 reasoning 能力足以自主规划,你的 Planner 成了天花板
这不是说不需要 Harness,而是说:Harness 的每一个组件都应该问自己——“这个东西,模型自己能不能学会?”
如果答案是"迟早能”,那它就是辅助组件,写的时候就要预留拆除的口子。 如果答案是"不可能"(因为它涉及的是 LLM 外部的物理世界),那它就是核心组件。
换句话说,极简的、最小化必要的组件,才是一个能扛住未来 3-6 个月模型迭代的 Harness 的核心。
具体的,如果以 “Long-running”为目标,Harness 的组件可以被划分为两类:
-
核心组件: Agent-loop、Context 管理、原子化核心工具、File-system 、Hooks 与 Subagent 隔离(或者是task管理)
-
辅助组件(短期内的补丁,长期会被取代的)
核心组件
Agent Loop
所有关于 Agent 的故事都始于 Agent-Loop。一个好的 Agent-Loop 必然是极其简洁的,由 LLM 主导决策,而非人为预设路径。
从底层来看,LLM 依然是一个预测下一个 Token 的自回归模型。这个基本盘在长远来看是成立的。Agent-Loop 的作用仅仅是:执行工具 → 捕获结果 → 追加上下文 → 再次调用 LLM 。
def agent_loop(query):
    messages = [{"role": "user", "content": query}]
    while True:
        response = client.messages.create(
            model=MODEL, system=SYSTEM, messages=messages,
            tools=TOOLS, max_tokens=8000,
        )
        messages.append({"role": "assistant", "content": response.content})

        if response.stop_reason != "tool_use":
            return

        results = []
        for block in response.content:
            if block.type == "tool_use":
                output = run_bash(block.input["command"])
                results.append({
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": output,
                })
        messages.append({"role": "user", "content": results})
(from learn-claude-code)
这就是 agent 的核心循环。所有的"智能"都来自同一个地方:LLM 预测下一个 token 时的内在推理。Harness 只是把 tool response 喂回去,让这个推理过程能够持续。
当然,从工程角度和生产级考虑,agent-loop 本质上仍是这个 while-true 循环,但需要增加大量的防御机制来提升韧性。
据非官方流出的 claude-code 源码分析,queryLoop(src/query.ts:241)围绕核心循环构建了超过 1700 行的防御层,包括:
-
Streaming 处理
-
权限检查
-
Tool 格式处理、校验
-
错误恢复
-
…
Context 管理
过去半年多,“Context Engineering"这个词开始频繁出现。它指的不是简单的 Prompt 调优,而是解决一个更根本的矛盾:不断累加的 Message 同 LLM 有限的 context-length 和注意力之间的矛盾。在 Long-running 状态下,持续 append 的 messages 最终会导致:
-
Context 溢出:超出 LLM context-window 的物理上界
-
Context Rot: 在窗口内,不代表模型能有效处理,无效信息过多会严重干扰模型的推理
优秀的 Harness 如何处理 Context?
Context 管理不仅仅是拼接修剪 Prompt,其中最核心的原则是 token 成本,或者说是 KV-cache 的缓存命中率。也就是说,在保证缓存命中的前提下,进行 context 的优化。
1. Microcompact
处理掉前几轮 tool-using 产生的 tool result 中间结果。据源码分析,Claude-code 分成了两种处理方式:
-
Time-based Microcompact:当用户离开一段时间后回来,服务端的 prompt cache 已经过期,此时无需保护缓存,直接构造新的消息对象替换旧的工具结果内容。
-
Cached Microcompact(Context editing):在 cache 存活期间不能替换消息内容,而是通过 Anthropic API 的 Context editing 机制,在 API 层面删除指定工具的
tool_result。
2. Summary、Compact、Auto-Compact
当手动或自动触发阈值时,Harness 会调用 LLM,根据现有的 context 进行总结和摘要并替换掉之前的 context。以 Claude Code 为例,摘要中通常包含:
// 摘要必须包含以下9个部分
1. Primary Request and Intent      // 主要请求和意图
2. Key Technical Concepts          // 关键技术概念
3. Files and Code Sections         // 文件和代码段
4. Errors and fixes                // 错误和修复
5. Problem Solving                 // 问题解决
6. All user messages               // 所有用户消息
7. Pending Tasks                   // 待处理任务
8. Current Work                    // 当前工作
9. Optional Next Step              // 可选下一步
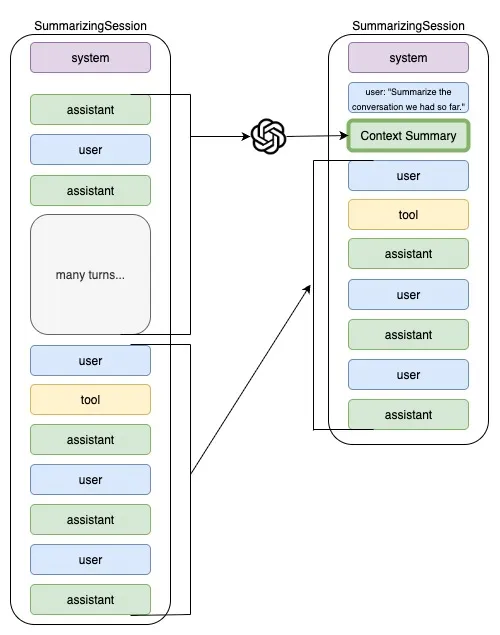
在 Anthropic Claude API 中,system prompt 与 Messages 是独立的,因此可以采用"完全 summary"模式——把历史消息整体替换为摘要。
相比之下,OpenAI 的 Codex 采用"初始上下文 + 最近用户消息(最多 20k tokens)+ 摘要"的分层模式:
3. Offload
不同于 compact 的有损压缩,offload 利用 file-system,将 context 写入文件中永久保存,然后释放对应的 context 窗口,在后续按需加载,实现无损压缩。
4. Isolation
对于存在大量工具调用和探索的过程,将大任务拆解成多个小任务,分别由 subagent 完成,从而实现 context 的独立和隔离,避免 context 的污染。
Context 管理的目标:在信息完整度 × KV-Cache 命中率 × Token 成本 之间取最优解
原子化工具
严格来说,LLM 所谓的 tool-using,并不是真正在“使用工具”。模型本身只是在输出一种特殊格式的工具调用文本;真正的工具执行,是由 Harness 去解析这些文本后,转化为对环境的真实调用。
然而,工具并非越多越好。
过多的工具不仅会降低调用准确率,还会占用宝贵的上下文,带来明显的 Context Rot。对于 Agent 来说,真正重要的不是工具数量,而是工具是否具备:
-
原子性
-
正交性
-
完备性
-
可组合性
换句话说,工具层应该尽可能“原语化”——每个工具只做一件明确的事,但这些工具之间可以自由组合,从而构建出复杂行为。
无论是 Manus 的三层工具设计,还是 Anthropic 提出的 tool-search-tool 与 programmatic tool calling,背后的核心问题其实是同一个:
对 Agent / LLM 而言,什么才是“原生工具”?
所谓原生工具,不是工程师为了业务方便封装出的高度特化接口,而是那些模型更熟悉、更容易理解、也更容易稳定调用的工具形式。也可以说,它们是 agent-oriented tools。
bash is all you need
像 Bash、文件读写、文本编辑、正则处理这类底层能力,本来就是 Linux 和软件工程世界中最常见的操作接口;它们在训练数据中出现频率极高,也更容易进入 agentic RL 的训练分布。相比之下,那些人为定义、语义暧昧、接口风格各异的自定义工具,往往会显著增加 Agent 的理解与选择负担。
因此,与其为 Agent 提供几百个高度特化的第三方插件,不如优先提供少量稳定、低层、可组合的基础能力。
(面向 Agent 的 CRUD?)
File System
在 Agent 系统里,file system 的意义远不只是“保存文件”。
一方面,file system可以将原本停留在上下文窗口中的信息持久化下来,包括中间结果、计划、草稿、观察记录,以及工作记忆(也就是上文所提到的context offload)。
另一方面,file system本身也是最自然的执行环境之一。尤其在 coding agent 场景下,代码、配置、日志、测试输出、脚本和文档,本来就是围绕文件来组织的。相比额外发明一套新的记忆接口或工具抽象,直接提供 read、write、edit 等基础操作,更符合 Agent 的使用习惯,也更贴近操作系统级的真实工作流。
因此,在 harness 中,file system 往往承担至少三类关键角色:
-
工作记忆(Working Memory):保存中间状态、任务计划、阶段性结论和临时产物
-
执行环境(Execution Environment):承载代码、脚本、配置、输入输出和运行结果
-
隔离边界(Sandbox):通过受控目录、虚拟文件系统或沙箱环境限制 Agent 的操作范围与权限
在这篇文章中 Everything is Context: Agentic File System Abstraction for Context Engineering,借用了Unix 哲学中的“Everything is a file” 理念,之于 agent的file-system中。
Subagent
Subagent 最初是 context isolation 的手段,进一步则演化为一种任务调度与多 Agent 协作的基本单元
在很多任务里,主 agent 的上下文是非常宝贵的资源。像搜索大型代码库、运行测试、排查错误、做长时间分析这类任务,往往会产生大量过程性噪音。如果把这些中间过程全部塞进主对话,不仅会污染主线上下文,也会降低后续推理和决策的质量。
因此,一个自然的做法是:spawn 一个 subagent,让它在独立的上下文中完成这些“脏活”。
主对话不需要消费完整过程,只需要接收一个总结性的结果。从 main-agent 的视角看,它只是调用了一个高阶工具AgentTool,然后等待(或稍后收到)一段总结文本,再将这段文本作为 tool_result 写回自己的上下文。换句话说,subagent 的引入并没有改变核心的 queryLoop 结构。
进一步看,它也是一种任务调度机制。
这种调度通常有两种形式:
-
同步 subagent:像普通工具一样调用,阻塞等待结果
-
异步 subagent:作为后台任务运行,主对话继续推进,结果稍后回收
一旦进入异步模式,系统就必须维护一个全局任务注册表(例如 Claude Code 中的 AppState.tasks),在后台持续运行,完成后通过信息注入的方式加入到主 agent 的 agent-loop 中。
当多个后台 subagent 同时运行时,subagent 的价值就不再只是 context isolation,也是 multi-agent orchestration 的起点。
Hooks
为了保持 agent-loop 的简洁,新的能力不应该继续往 loop 内部堆。
否则,一个本来只有“执行工具 → 捕获结果 → 追加上下文 → 再次调用LLM”四步的循环,很快就会被各式各样的业务逻辑拖成一个巨大的 if-else 状态机。
Hooks 的意义,就在于把这些复杂性移到 loop 外部。
通过 PreToolUse、PostToolUse、PreCompact、SubagentStop 等事件,harness 可以在关键节点捕捉状态、注入上下文、拦截风险、验证结果,而不必让 loop 自己理解所有规则。
因此,hooks 的本质不是“多几个扩展点”,而是把机制和策略分离:
-
loop 负责推进执行
-
hooks 负责施加控制
表面上看,hooks 只是提供了一堆事件名;但更重要的是,这些事件定义了 Agent 系统中的关键边界。
一旦边界清晰,很多能力就不再需要直接修改 loop 本身,而是可以通过外部策略注入:
-
安全策略可以挂在工具调用前后
-
记忆治理可以挂在 compact 前后
-
任务编排可以挂在 subagent 生命周期上
-
…
边界组件
除了上文提到的六大核心组件,还有一些常被讨论的概念。它们并非每个都是必需品,但理解它们的位置有助于避免过度设计。
Checkpointing / Recovery
对于 Long-running Agent 来说,错误恢复和状态检查点确实重要。但从 Harness 的视角看,Checkpointing 更像是一种跨组件的横切能力:File System 负责持久化,Hooks 负责在关键节点触发保存,Agent Loop 负责从断点恢复。它很难被单独抽象为一个独立的"组件”,而是各个核心组件协作的产物。
Planner / Todo-list
还记得 2026 年初,Claude Code 取消了内置的 todo-list 工具。原因很直接:新版本模型的 reasoning 能力已经足够强,不再需要人为维护一个显式的待办列表。这恰好印证了 Bitter Lesson 的预言——你今天写的 Planning 模块,很可能就是明天第一个被拆除的辅助组件。如果一定要做,请确保它能被干净地剥离,而不是和 Loop 深度耦合。
Skills
Skills 本质上是核心组件的组合产物:一个 Command Registry 加上按需的 Message Injection,以及一堆md文件。它不属于 Harness 的底层,而是 Harness 之上的应用层。
MCP / Plugins
MCP是一个协议层,不是 Harness 本体。支持 MCP 当然是个加分项,但它解决的是"如何暴露外部资源"的问题,而非"Harness 应该具备哪些核心能力"的问题。
Memory
Memory 无疑是重要的,但截至目前,业内尚未形成共识的形态。无论是 OpenClaw 还是 Claude Code,普遍采用基于 Markdown 文件的轻量级记忆方案。这种"文件即记忆"的方式虽然朴素,却恰好符合 Harness 的极简哲学——与其造一个复杂的记忆数据库,不如让 Agent 用最熟悉的文件接口来管理自己的长期状态。
Agent Team and Multi-agent
扩展到多 Agent 时,每个 Agent 内部的 Harness 组件完全不变——同样的 agent loop、同样的 context 管理、同样的原子工具。唯一新增的是 Agent 之间的连接方式。
如果你的 Harness 为单 Agent 设计得足够好,扩展到 team 时,90% 的基础设施可以直接复用。Subagent 和 Agent Team Member 的区别可以用下表概括:
| 维度 | Subagent | Agent Team Member |
|---|---|---|
| 生命周期 | 任务完成 → 销毁 | 跨任务存活,可能运行数小时 |
| 身份 | 匿名(只有 task 描述) | 有角色身份(“reviewer”、“coder”、“tester”) |
| 状态 | 无状态,结果返回后消失 | 有持久状态(自己的 context 历史、记忆文件) |
| 生成方式 | 主 agent spawn | 预先定义 / 动态 spawn 均可 |
从 Harness 的角度,多 Agent 系统需要额外提供:
-
Agent 注册表:谁在跑、角色是什么、当前状态
-
生命周期钩子:
on_spawn、on_idle、on_terminate -
优雅退出与资源回收:这是最容易被忽视、也最关键的一点
Subagent 是单向的(主 agent 发任务 → subagent 返回结果),而 Agent Team 需要双向甚至多向通信。但通信方式的设计,依然应该遵循"贴合 LLM 习惯"的原则:共享文件系统本身就是最自然的通信通道。
Harness Engineering = Bigger Loop
受限于篇幅,这里不展开太多 Harness Engineering 的内容。借用这篇文章 Harness Engineering 在讨论什么:三个 Scaling 维度的统一框架 的观点,Harness Engineering 的核心关键词是 Scalability——时间的延展、空间的扩展、以及交互方式的进化。
从笔者的角度,私认为Harness Engineering 和compound-Engineering 是同义词,真正的价值在于 如何让 Agent 越跑越好?
这一切的前提,都是一个好用的 Harness 加上一个更大的 Loop。
一个完整的 Agent 系统存在两个循环:
-
Inner Loop(Agent Loop):单次任务内的"工具调用 → 结果捕获 → 上下文追加 → 下一步决策"循环。这是本文的核心讨论对象。
-
Outer Loop(Evolution Loop):跨任务的"执行 → 评估 → 反馈 → 改进"循环。这是 Harness Engineering 的核心讨论对象。
这些内容在 Andrej Karpathy 的autoresearch 或者是 Ralph Loop 中都能看到。
Outer Loop 不需要另起一套架构,它是 Inner Loop 的核心组件在更大时间尺度上的复用。 Hooks 提供观测点,File System 提供持久化记忆,Subagent 提供并行实验能力,Context 管理保证运行不会失控。
好 Harness 的设计原则
1. 极简性 (Minimality)
能不加的组件就不加。每个组件都问自己:
“如果去掉它,agent 是完全不能跑,还是只是跑得没那么好?”
前者是核心,后者是辅助。
2. 可拆卸性 (Removability)
辅助组件必须能被干净地移除,而不是和核心组件纠缠在一起。
这是 Bitter Lesson 的工程实践:你今天写的东西,
要让六个月后的自己能轻松删掉。
3. 模型无关性 (Model Agnosticism)
Harness 不应该为某个特定模型的怪癖做特殊适配。
好的 harness 换一个模型,改个 API 调用就能跑。
(当然,针对特定模型的 prompt 优化是另一回事)
4. 面向进化 (Evolution-Ready)
Harness 的终极目标不是"跑一个任务",
而是"提供一个让 agent 越跑越好的环境"。
每个组件的设计都应该考虑:
它如何为 Outer Loop 贡献数据、反馈、或可调参数?
结语
Agent Harness 不是越复杂越好。恰恰相反,它的价值在于克制。
2023-2026 年的 Agent 发展史,本质上是一部"人为控制逻辑不断被模型能力淘汰"的历史。Harness 的真正使命,是为模型提供一个稳定、安全、可进化的运行环境,然后把决策权交还给模型本身。
更多阅读
Anthropic: Effective harnesses for long-running agents
OpenAI: Harness engineering: leveraging Codex in an agent-first world
Agent Frameworks, Runtimes, and Harnesses - oh my!
Harness design for long-running application development
Difference Between Agent Harnesses & Agent Frameworks
Harness Engineering Is Cybernetics
The importance of Agent Harness in 2026
The Claude Code SDK and the Birth of HaaS (Harness as a Service)
Agent design lessons from Claude Code