
引言
在信息化时代,数据和知识的快速提取变得尤为重要。特别是对于学术和技术文档,如何从格式丰富且结构复杂的PDF文件中准确地提取信息,是提高研究效率的关键。本文将探讨几种先进的技术方法,用于优化学术论文的PDF解析及其表格内容的处理。
对于文档解析,langchain 和 llama_index 提供的 document loader 能够支持多种文件类型,覆盖绝大多数文档格式的需求。但对于pdf解析而言还存在着一些挑战。
人类与机器的阅读差异
尽管PDF格式适合人类阅读,提供了优秀的视觉体验和格式保真,但它并不适合机器阅读。PDF文件通常包含复杂的布局和多样的内容元素,如多列布局、公式和表格,这些都给自动解析带来了挑战。
常见的PDF解析问题
使用传统的PDF解析库可能遇到多种问题:
-
多列布局导致的文本流读取错误。
-
公式和表格的解析效果差,难以正确提取信息。
-
解析过程中结构化信息(如标题和列表)的丢失。
-
影印版PDF的文本无法被标准OCR工具识别。
高级解析技术
根据unstractued提供的方案,文档解析可以大致分为两种方法:结构化解析和基于图像的解析。结构化解析侧重于从文档中提取文字和其它字符数据。而图像基解析则包括以下两种技术:
-
OCR技术:首先使用目标检测模型对文档布局进行分析,识别出标题、表格等关键元素的位置,然后在这些位置上使用OCR技术提取文字。
-
基于Transformer的端到端解析:使用深度学习模型直接将图像转换为相应的文字内容。在这方面,
Dount和Nougat模型表现出色,尤其是Nougat能够将图像中的文章整理成Markdown或Latex格式,非常适合需要保留结构信息(如标题层级、公式和表格)的场景。
只可惜Nougat只针对英文的学术论文做了训练,但遇到其他语言如中文论文的效果就不是那么的好了。

必须强调一点的是,Markdown格式因其简洁性和易于解析的特点,被广泛认为是LLM(大型语言模型)友好的文档格式。Markdown通过明确的标记语法,帮助模型更好地理解文档结构和内容,从而提高信息提取的准确性和效率。特别在存在大量公式,表格的学术论文场景下,Markdown可能是更合适的格式选择。
快速上手:使用Nougat将pdf解析成适合LLM读取的markdown
依赖按照
!pip install -q pymupdf python-Levenshtein nltk
!pip install -q git+https://github.com/huggingface/transformers.git
Load model and processor
from transformers import AutoProcessor, VisionEncoderDecoderModel
import torch

processor = AutoProcessor.from_pretrained("facebook/nougat-base")
model = VisionEncoderDecoderModel.from_pretrained("facebook/nougat-base")
device = "cuda" if torch.cuda.is_available() else "cpu"
model.to(device)
将pdf转成图像
from typing import Optional, List
import io
import fitz
from pathlib import Path

def rasterize_paper(
    pdf: Path,
    outpath: Optional[Path] = None,
    dpi: int = 96,
    return_pil=False,
    pages=None,
) -> Optional[List[io.BytesIO]]:
    """
    Rasterize a PDF file to PNG images.

    Args:
        pdf (Path): The path to the PDF file.
        outpath (Optional[Path], optional): The output directory. If None, the PIL images will be returned instead. Defaults to None.
        dpi (int, optional): The output DPI. Defaults to 96.
        return_pil (bool, optional): Whether to return the PIL images instead of writing them to disk. Defaults to False.
        pages (Optional[List[int]], optional): The pages to rasterize. If None, all pages will be rasterized. Defaults to None.

    Returns:
        Optional[List[io.BytesIO]]: The PIL images if `return_pil` is True, otherwise None.
    """

    pillow_images = []
    if outpath is None:
        return_pil = True
    try:
        if isinstance(pdf, (str, Path)):
            pdf = fitz.open(pdf)
        if pages is None:
            pages = range(len(pdf))
        for i in pages:
            page_bytes: bytes = pdf[i].get_pixmap(dpi=dpi).pil_tobytes(format="PNG")
            if return_pil:
                pillow_images.append(io.BytesIO(page_bytes))
            else:
                with (outpath / ("%02d.png" % (i + 1))).open("wb") as f:
                    f.write(page_bytes)
    except Exception:
        pass
    if return_pil:
        return pillow_images
from transformers import StoppingCriteria, StoppingCriteriaList
from collections import defaultdict

class RunningVarTorch:
    def __init__(self, L=15, norm=False):
        self.values = None
        self.L = L
        self.norm = norm

    def push(self, x: torch.Tensor):
        assert x.dim() == 1
        if self.values is None:
            self.values = x[:, None]
        elif self.values.shape[1] < self.L:
            self.values = torch.cat((self.values, x[:, None]), 1)
        else:
            self.values = torch.cat((self.values[:, 1:], x[:, None]), 1)

    def variance(self):
        if self.values is None:
            return
        if self.norm:
            return torch.var(self.values, 1) / self.values.shape[1]
        else:
            return torch.var(self.values, 1)


class StoppingCriteriaScores(StoppingCriteria):
    def __init__(self, threshold: float = 0.015, window_size: int = 200):
        super().__init__()
        self.threshold = threshold
        self.vars = RunningVarTorch(norm=True)
        self.varvars = RunningVarTorch(L=window_size)
        self.stop_inds = defaultdict(int)
        self.stopped = defaultdict(bool)
        self.size = 0
        self.window_size = window_size

    @torch.no_grad()
    def __call__(self, input_ids: torch.LongTensor, scores: torch.FloatTensor):
        last_scores = scores[-1]
        self.vars.push(last_scores.max(1)[0].float().cpu())
        self.varvars.push(self.vars.variance())
        self.size += 1
        if self.size < self.window_size:
            return False

        varvar = self.varvars.variance()
        for b in range(len(last_scores)):
            if varvar[b] < self.threshold:
                if self.stop_inds[b] > 0 and not self.stopped[b]:
                    self.stopped[b] = self.stop_inds[b] >= self.size
                else:
                    self.stop_inds[b] = int(
                        min(max(self.size, 1) * 1.15 + 150 + self.window_size, 4095)
                    )
            else:
                self.stop_inds[b] = 0
                self.stopped[b] = False
        return all(self.stopped.values()) and len(self.stopped) > 0
将pdf转成markdown
from tqdm import tqdm

def trans_pdf_to_markdown(filepath):
  output = ""

  images = rasterize_paper(pdf=filepath, return_pil=True)
  for i in tqdm(range(len(images))):
    image = Image.open(images[i])
    pixel_values = processor(images=image, return_tensors="pt").pixel_values

    # autoregressively generate tokens, with custom stopping criteria (as defined by the Nougat authors)
    outputs = model.generate(pixel_values.to(device),
                              min_length=1,
                              max_length=3584,
                              bad_words_ids=[[processor.tokenizer.unk_token_id]],
                              return_dict_in_generate=True,
                              output_scores=True,
                              stopping_criteria=StoppingCriteriaList([StoppingCriteriaScores()]),
    )
    generated = processor.batch_decode(outputs[0], skip_special_tokens=True)[0]
    generated = processor.post_process_generation(generated, fix_markdown=True)

    output+=generated
    output+="\n\n"

  return output

filepath = 'xxx.pdf'
makrdown_ = trans_pdf_to_markdown(filepath)
具体参考Nougat的官方示例。
表格类数据的RAG问题
表格类目前的解决方案主要有两种:
对于内容较小的表格,一般采用LLM对表格进行summary, 以table summary构建查询的index,在召回后, 进行表格内容的复原或者根据问题后处理提供至LLM进行生成。
对于内容较多的表格, 一般采取结构化处理, 也就是存储至数据库, 在查询阶段根据问题匹配对应的表schema, 有模型执行text-to-sql任务,生成sql并执行获得结果,最终根据结果回答内容。
对于第一种方案,在Langchain 的cookbook中提到了Semi-structured RAG的方法值得借鉴;
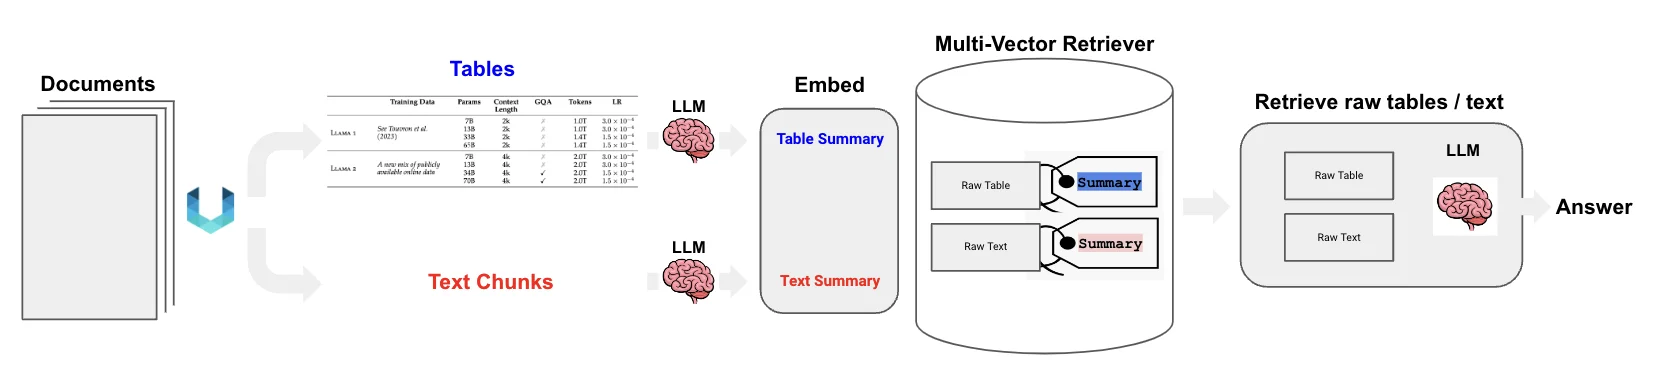
此外在HRoT这篇工作中, 也提到了类似的方法;
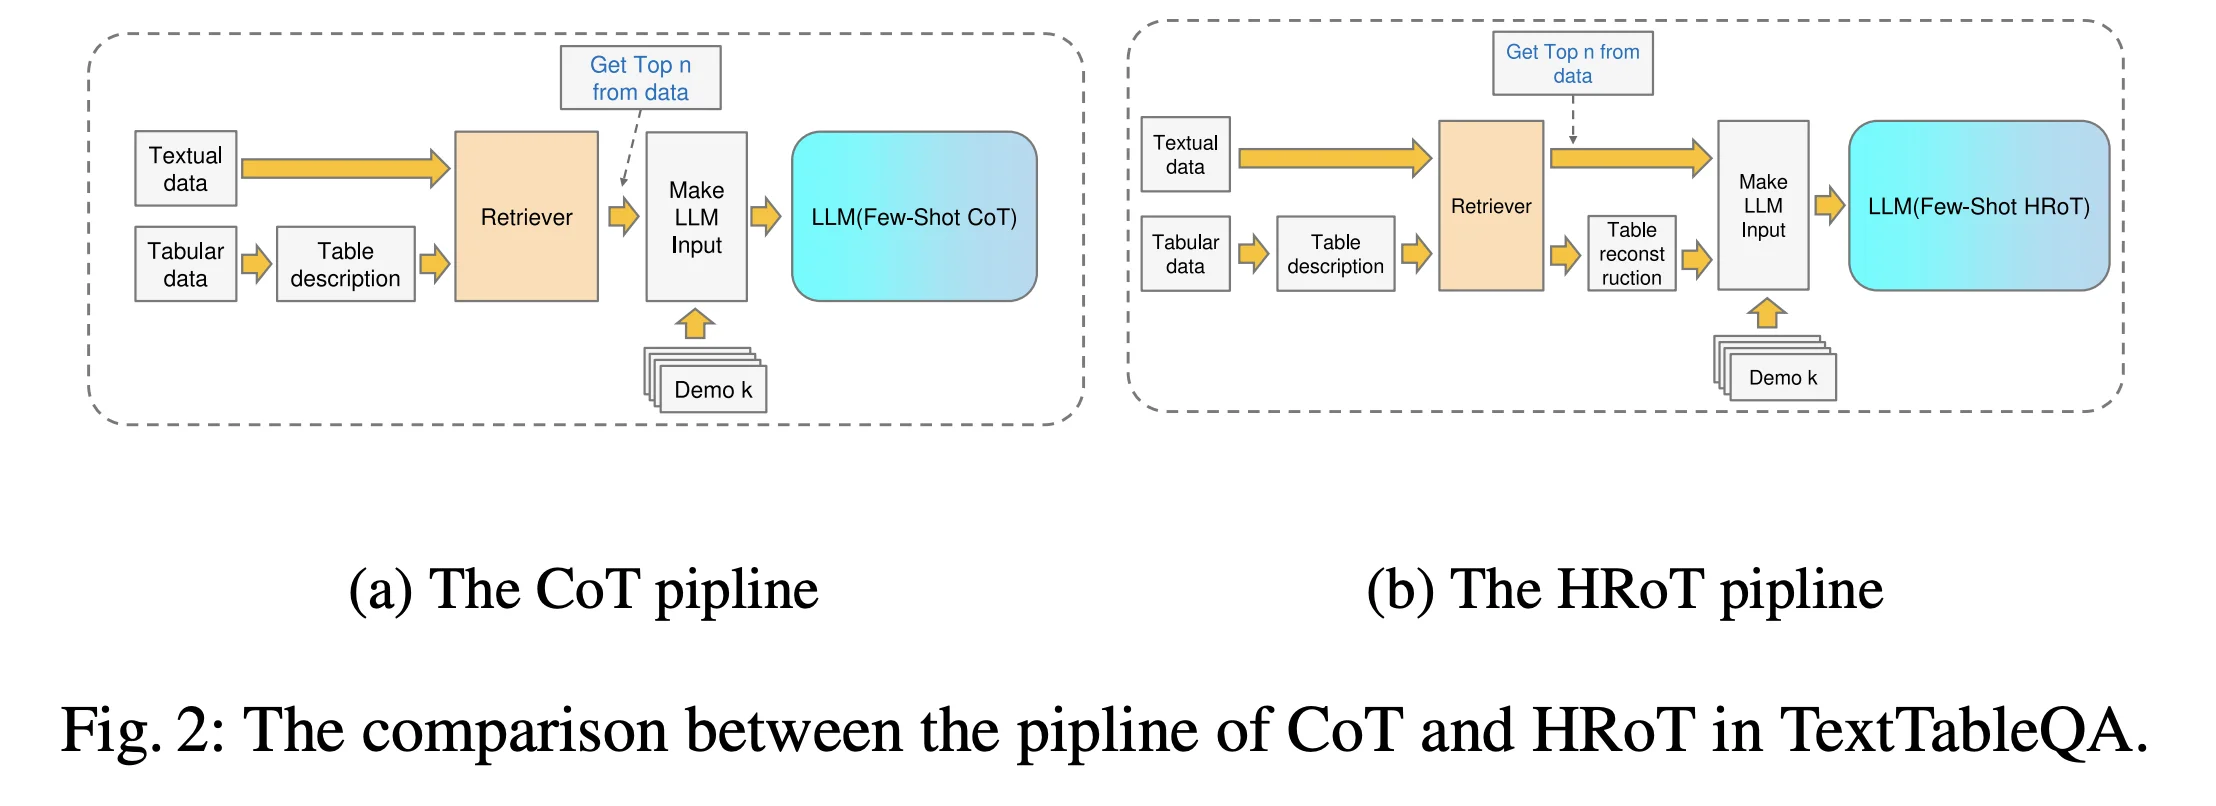
在HRoT这篇工作中, 增加了将table基于问题进行重构的算法,
Type-Aware Table Reconstruction algorithm
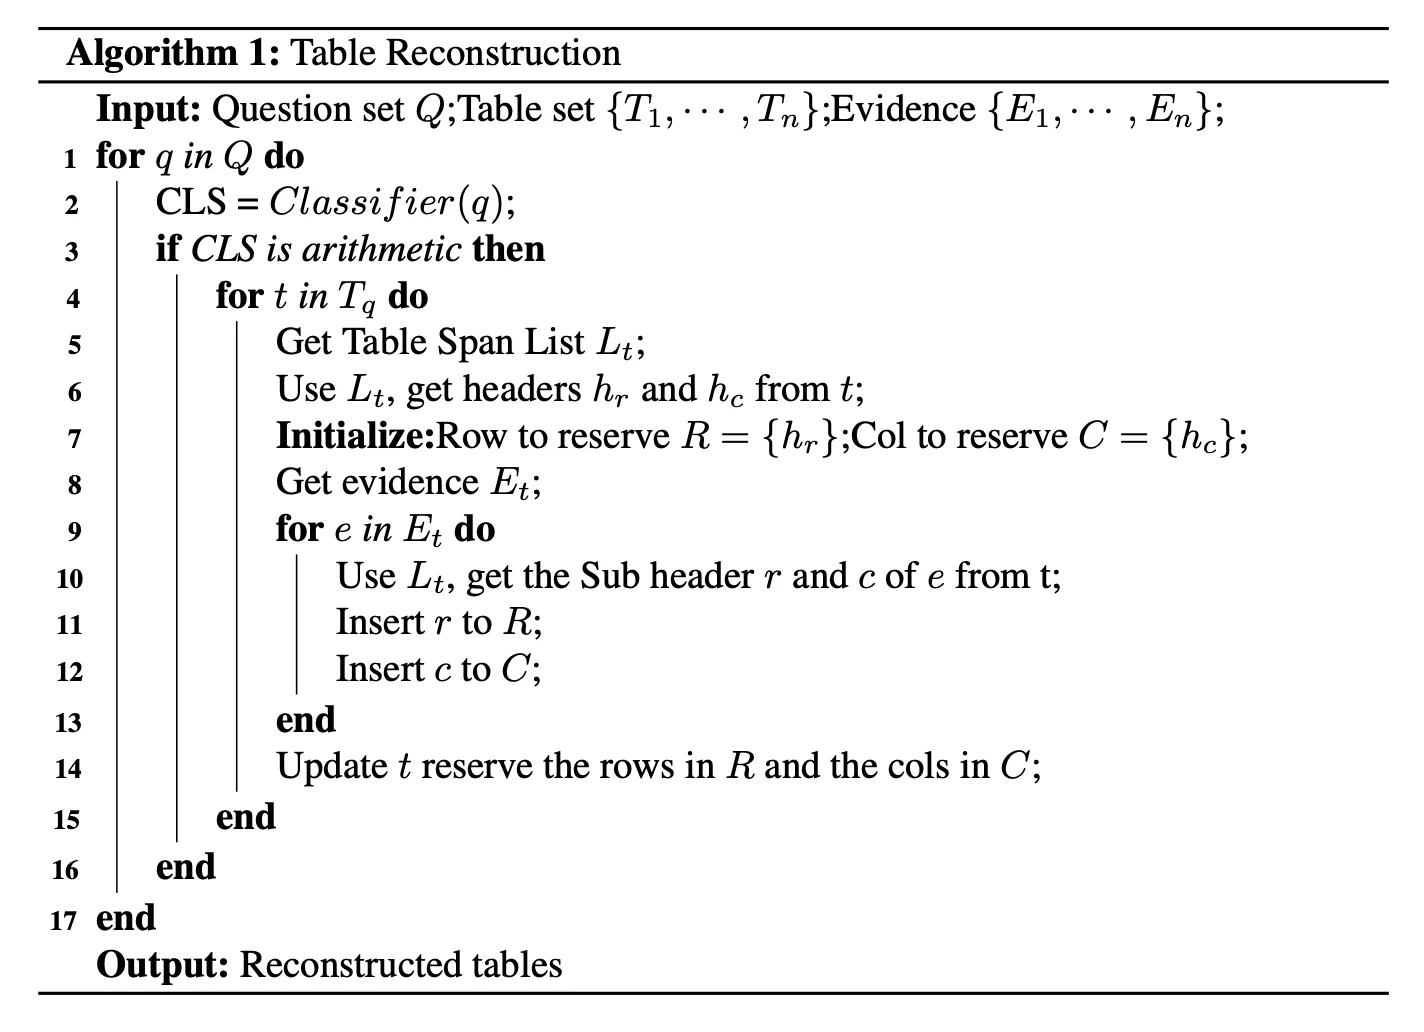
该算法的实现步骤如下:
-
问题分类:首先,算法对问题进行分类,判断问题是算术问题还是跨列选择问题。这有助于确定需要从表格中检索的信息类型。
-
获取表格和证据:对于算术问题,算法获取与问题相关的表格集合。然后,从这些表格中提取出作为证据的文本和表格片段。
-
表格分区:对于每个表格,算法将其分区为多个子表格。这是通过获取表格的跨度列表(Lt)来完成的,该列表包含了表格中每个头部(行和列)的起始和结束位置。
-
确定保留的行和列:算法根据问题类型和证据来确定哪些行和列是回答问题所必需的。这是通过分析每个证据的子标题(即表格中的行和列标题)来实现的。
-
重建表格:在确定了需要保留的行和列之后,算法根据这些信息重建表格。重建的表格只包含对问题回答有帮助的信息,从而减少了无关信息的干扰。
在TableQuery 这篇工作中, 利用一系列模块组件,实现了基于LLM对数据库的高效查询。
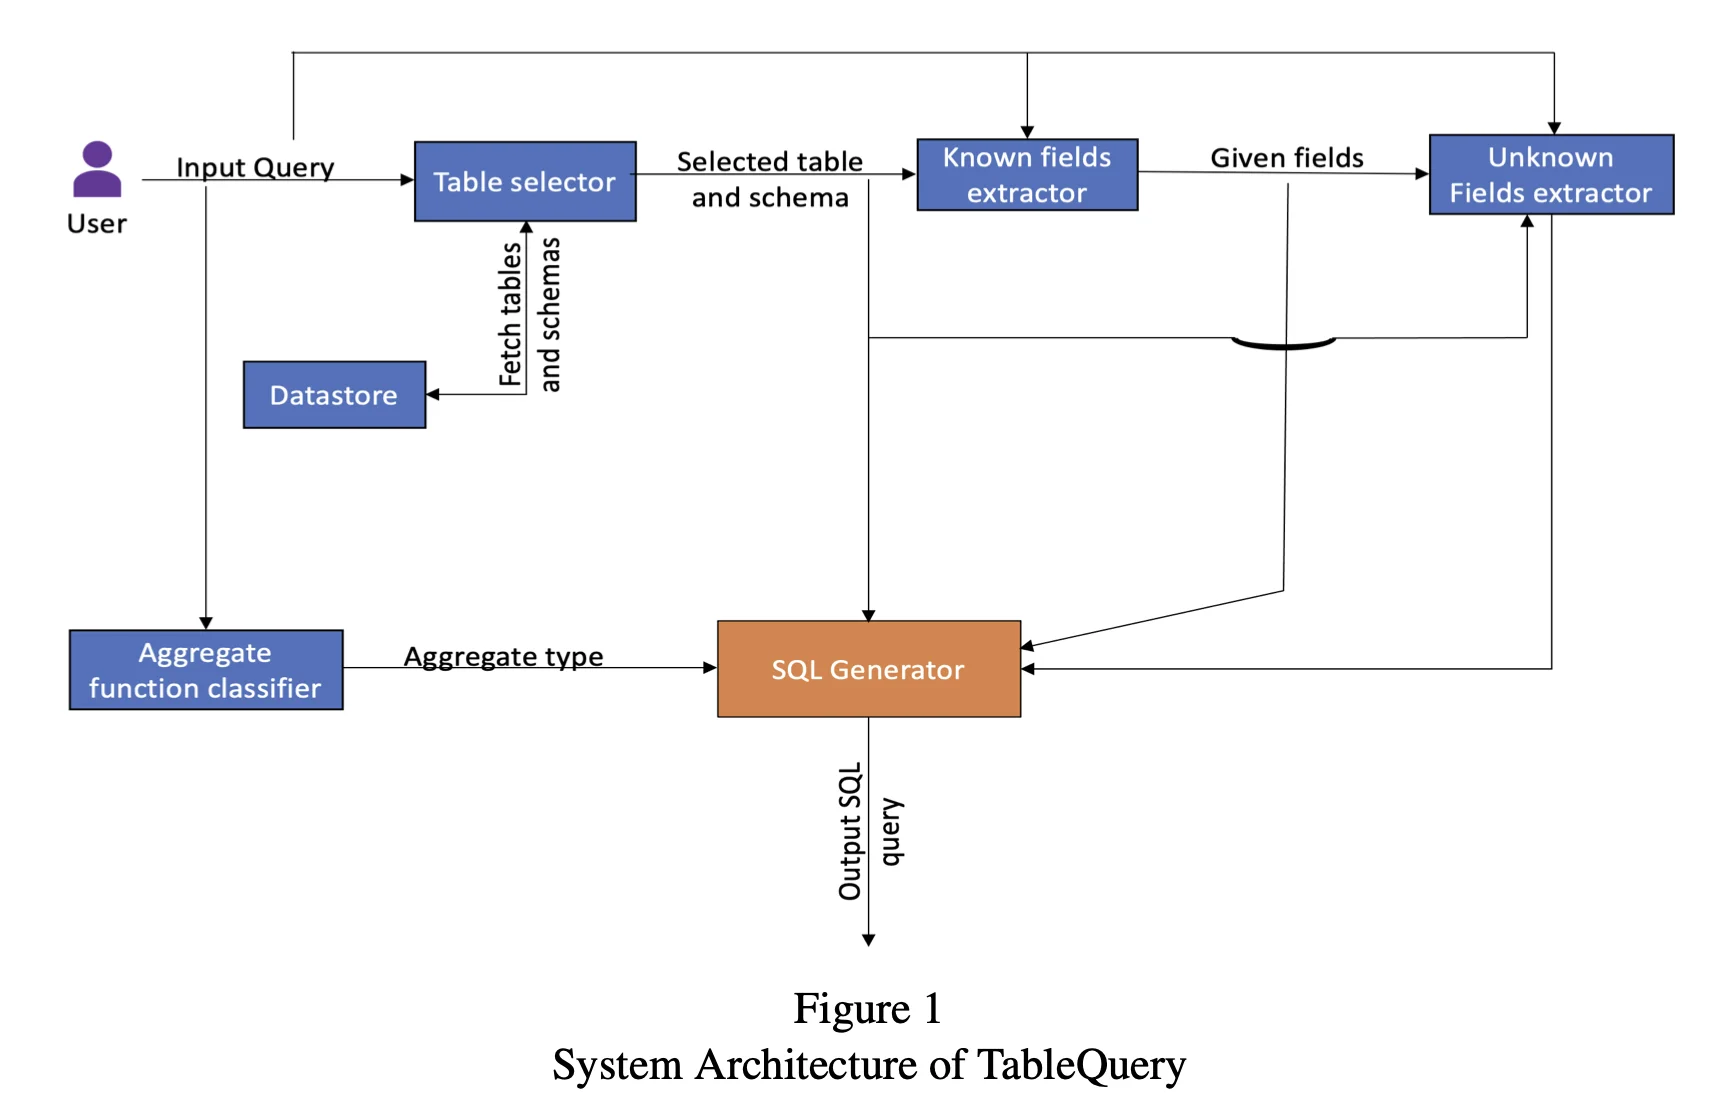
TableQuery的架构设计包括以下几个主要模块:
-
Datastore:Datastore是一个表格集合,可以通过自然语言查询。这些表格可以是数据库或电子表格目录。除了表格数据,Datastore还包含模式文件,这些文件包含每个表的元数据,如表关键词、列名、列类型、列关键词(用户为列名提供的关键词)等。模式文件可以手动为这些表创建,也可以通过应用各种启发式方法自动生成。
-
Table Selector:表选择器根据输入查询从Datastore中选择合适的表。这是通过从输入查询中提取关键词,并找到与问题关键词(以及模式中的表关键词、列名、列关键词等)重叠系数最大的表来完成的。
-
Known Fields Extractor:已知字段提取器提取查询中已经给出值的列。对于这些列中的每一个,也提取了相应的值。这是通过一个预训练的深度学习模型来完成的,该模型用于在自由文本上执行问答。
-
Unknown Fields Extractor:未知字段提取器提取需要从选定表中检索值的列。这是通过排除已知字段提取器已经从查询中提取的列,并找到其列关键词与问题关键词重叠系数最大的列来完成的。
-
Aggregate Function Classifier:一些查询可能需要对选定表中的未知字段的值执行进一步操作。这是通过在生成的SQL查询中包含SQL聚合函数(如COUNT、SUM、MIN、MAX、AVG等)来实现的。聚合函数分类器决定给定输入查询要使用的聚合函数。为了执行这项任务,作者训练了一个两层的神经网络,该网络以使用通用句子编码器编码的查询作为输入,并输出要使用的适当聚合函数(如果有的话)。
-
SQL Generator:结合已知字段和值、未知字段和聚合函数来构建SQL查询,当该查询在选定的表上运行时,返回所需的结果。
关于text-to-sql的更详尽内容, 可以参考这篇综述文章:Natural Language Interfaces for Tabular Data Querying and Visualization: A Survey。 限于篇幅就不展开了。
参考文献
Nougat: Neural Optical Understanding for Academic Documents
langchain: Semi-structured RAG
HRoT: Hybrid prompt strategy and Retrieval of Thought for Table-Text Hybrid Question Answering
TableQuery: Querying tabular data with natural language
Natural Language Interfaces for Tabular Data Querying and Visualization: A Survey