写在最前面
在过去的几个月中,我主要致力于与RAG(检索增强生成模型)相关的研究和实验工作。通过深入地分析众多论文和项目代码,我发现虽然在RAG领域取得基本成就相对容易,但要实现出色的成果却异常困难。
此系列文章旨在分享我在RAG研究中的心得和挑战。正如我们从OpenAI的开发者日活动中看到的,即使是在这个领域的领头羊也在不断试验和努力以寻求突破。
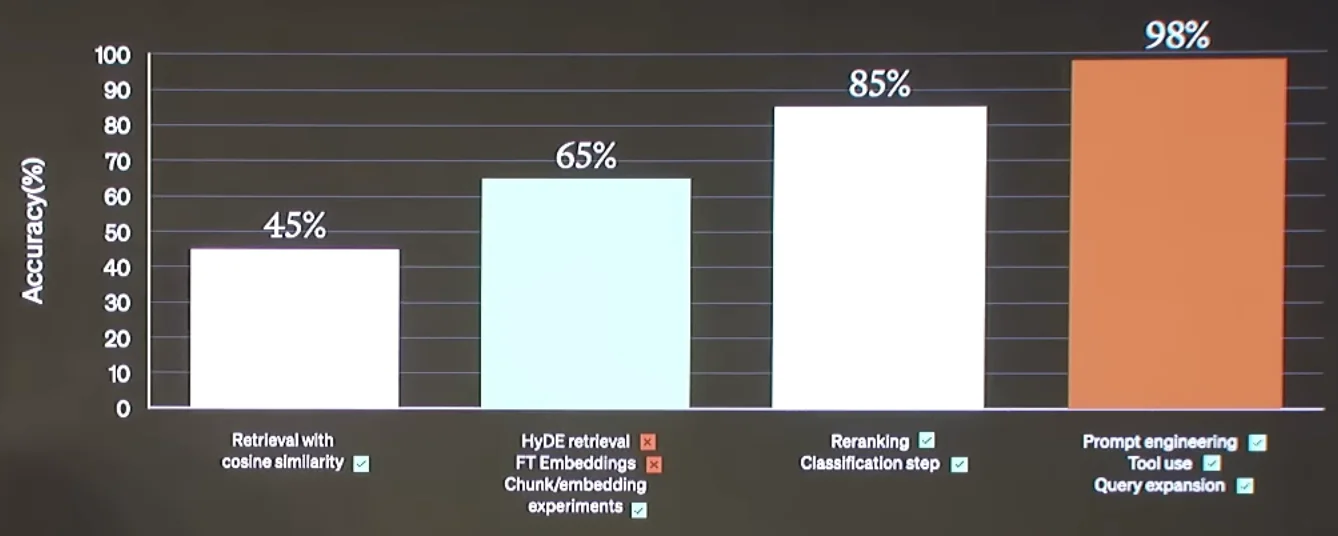
在我们深入探索RAG系统提升的各种方法之前,有一个基本问题需要解决:我们如何准确地评估一个RAG系统的性能?这就像是在机器学习或深度学习任务中没有给定的测试集和评价标准,我们难以判断实验的成功与否。
因此,本系列的第一篇文章将聚焦于介绍RAG系统的评价方法、相关指标以及测试框架,为我们接下来的探索设定明确的标准和目标。
测试框架
以下是一些测试框架,为RAG系统评估提供了强大的支持。
TruLens
TruLens提供了一个独特的视角来评估和跟踪大型语言模型(LLM)实验,通过一系列创新的功能和方法,帮助开发者和研究人员更深入地了解模型性能和行为。
TruLens的反馈功能(Feedback Functions)是其核心概念之一,提供了一种程序化的方法来评估应用的运行表现。这些函数从“可扩展性”和“有意义性”两个维度出发,考虑评估的范围,旨在为用户提供有价值的反馈,帮助他们理解和改进他们的LLM应用。
在RAG应用中,提供准确的上下文信息至关重要,以避免生成不真实的“幻觉”答案。TruLens采用了创新性的RAG三元组评估方法,专门针对RAG架构的每个环节进行幻觉风险评估,确保模型的每个部分都能有效地工作,从而减少误导信息的产生。
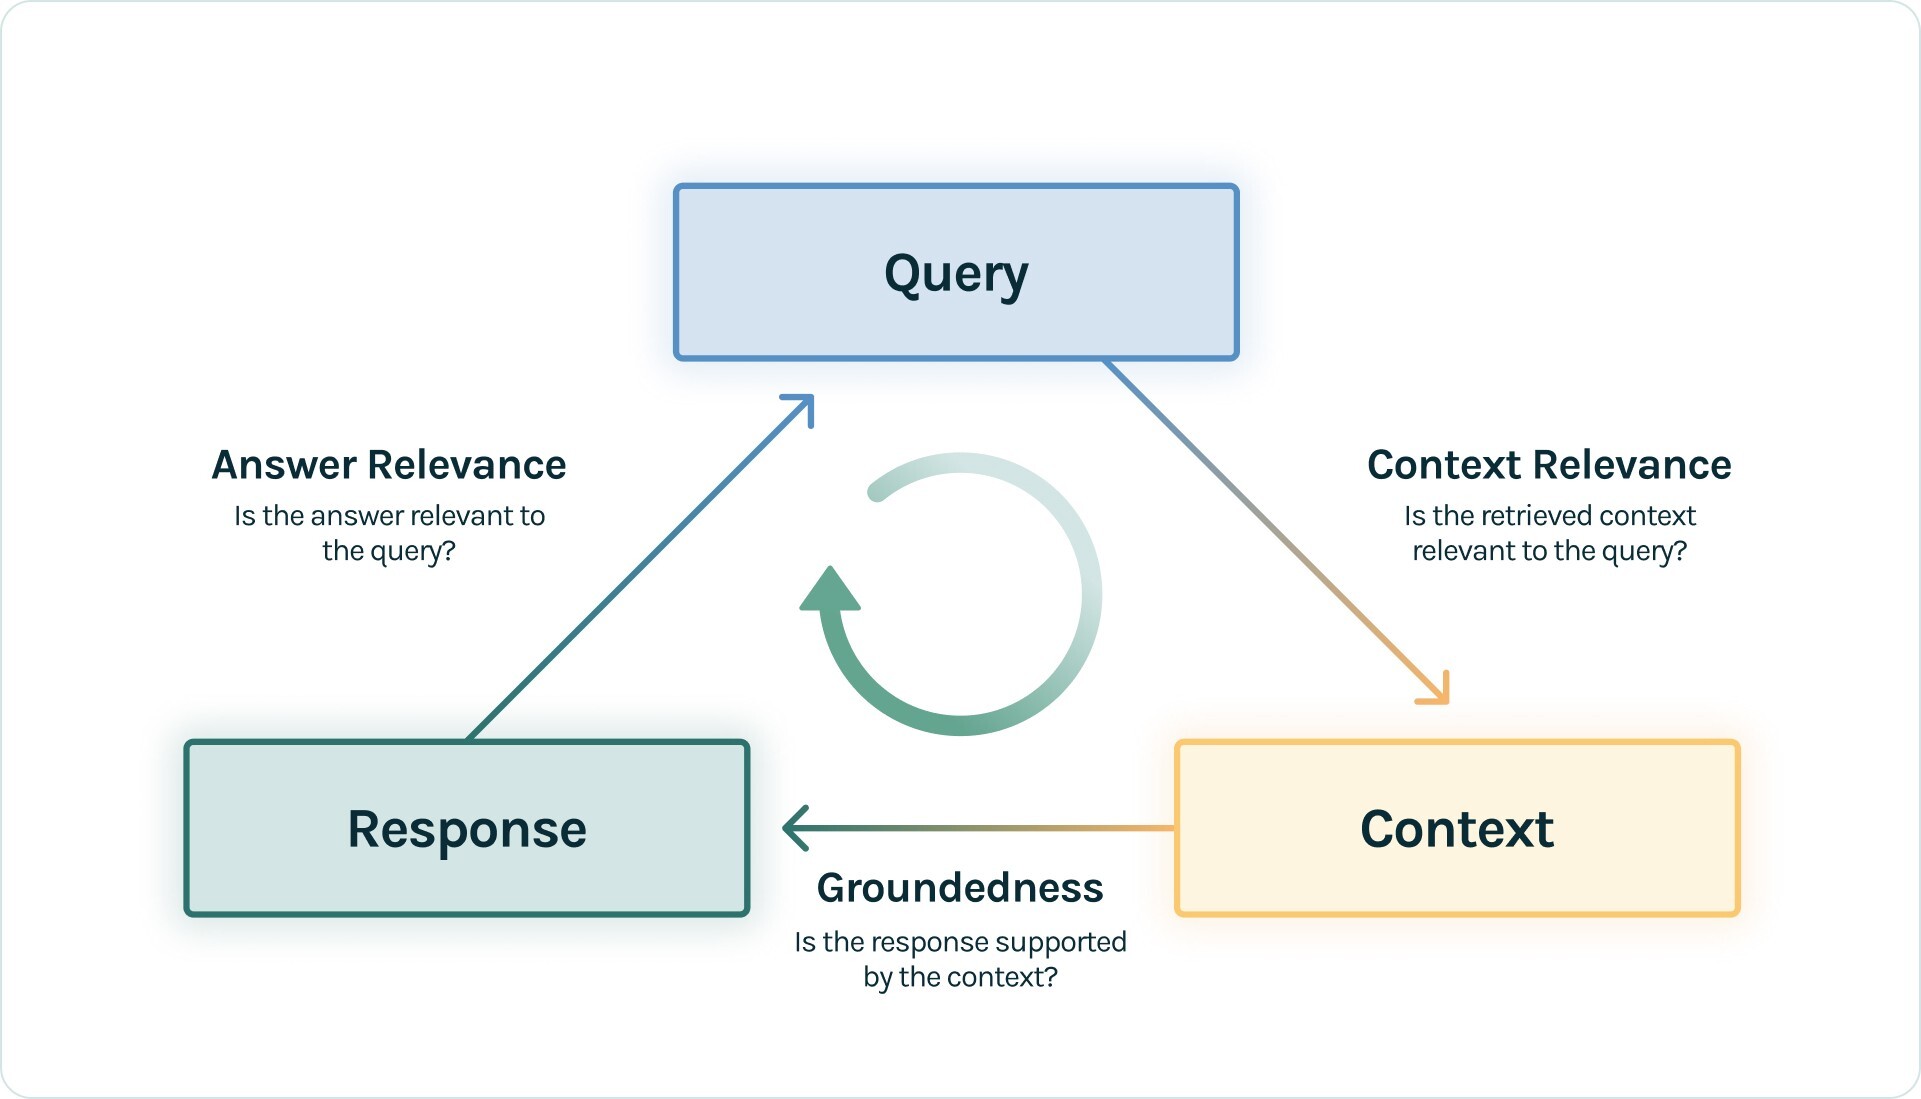
上下文相关性(Context Relevance)
上下文相关性是评估RAG应用的第一步,确保每一段检索到的上下文都与提出的查询紧密相关。TruLens利用序列化记录的结构来评估上下文的相关性,这是一个关键的步骤,确保模型在正确的信息上生成回答。
真实性(Groundedness)
在检索到的上下文信息的基础上,大型语言模型将生成答案。TruLens强调了独立验证每个回答的重要性,以确保它们基于可靠信息,并且能够在检索到的上下文中找到支持的证据。这一步骤是确保模型回答的真实性和可靠性的关键。
答案相关性(Answer Relevance)
最后,评估需要确保最终回答有效地解答了原始问题,这通过评估应用的最终回答与用户输入的相关性来实现。这一过程确保了模型的输出不仅是真实的,而且是对用户查询有用的。
TruLens还提出了“诚实、无害和有帮助”的评估原则(Honest, Harmless, and Helpful Evaluations),这些原则旨在确保LLM应用在提供帮助的同时,也是安全和可信的。
Ragas
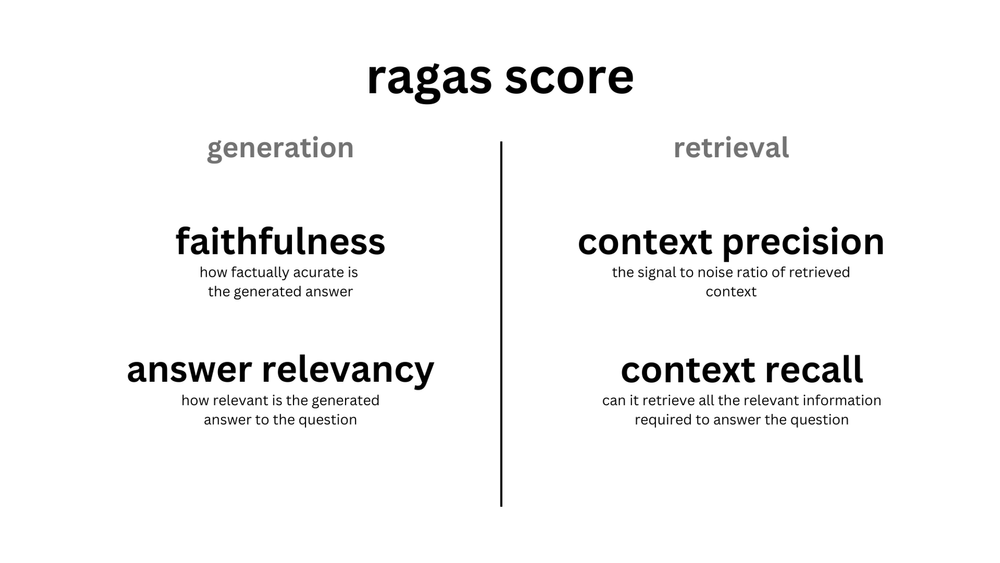
Ragas框架专为评估检索增强生成(RAG)系统而设计,定义了四个核心评估指标:上下文相关性(context_relevancy)、上下文回溯(context_recall)、忠实度(faithfulness)和答案相关性(answer_relevancy)。这些指标共同构成了Ragas的评分体系,提供了一个全面的方法来评价RAG系统的性能。
此外,Ragas巧妙地利用大语言模型(LLM)进行无参考评估,有效降低了评估成本。通过这种方法,Ragas能够提供一种既经济又有效的方式来评估RAG系统,尤其是在处理大量数据和复杂查询时。
其他测试框架
DeepEval
DeepEval How to Evaluate RAG Applications in CI/CD Pipelines with DeepEval
ARES
数据
在评估数据集时,不必依赖人工标注的标准答案,而是通过底层的大语言模型 (LLM) 来进行评估。
为了对 RAG 流程进行评估,需要以下几种信息:
-
question:这是RAG流程的输入,即用户的查询问题。
-
answer:这是由RAG流程生成的答案,也就是输出结果。
-
contexts:这是为了解答question而从外部知识源检索到的相关上下文信息。
指标
在深入研究检索增强生成(RAG)系统和其他相关技术时,了解和使用正确的评估指标至关重要。以下是几个关键指标,它们帮助我们量化和评估检索系统的效能:
检索指标
MRR(平均倒数排名)
MRR是衡量检索系统性能的一种方法,特别关注于检索结果中的首次正确命中的排名。MRR的高值表示系统能够更频繁地将相关结果排在前列。
$$ MRR = \frac{1}{查询数量}\sum_{i=1}^{查询数量} \frac{1}{首次正确命中的排名} $$
这个指标特别有用,因为它直接关注于用户最有可能查看的第一个搜索结果的质量。
召回率(Recall)
召回率是另一个重要指标,它衡量了系统检索到的相关文档数量与总的相关文档数量之间的比例。高召回率意味着系统能够检索到更多的相关文档。
$$ Recall = \frac{检索到的相关文档数量}{总的相关文档数量} $$
NDCG(标准化折扣累积增益)
NDCG(Normalized Discounted Cumulative Gain)是一个在信息检索、推荐系统和机器学习领域常用的评估指标,用于衡量一个系统或模型返回的结果列表的质量。NDCG特别关注于结果的排序质量,即最相关或最有价值的结果是否排在了列表的前面。与其他评估指标相比,NDCG的独特之处在于它考虑了结果的相关性(relevance)不仅是二元的(相关或不相关),而且可以是多级的(例如,从不相关到非常相关的多个级别)。
EM(精确匹配)
EM度量了系统输出的答案与标准答案完全一致的比例,是评估系统准确度的直接方式。在某些场景下,即使是非常小的差异也可能导致答案被视为不正确,这使得EM成为一个严格的评估标准。
基于大语言模型评估的LLM生成指标
在RAG任务中,对LLM回答的问题主要关注了回答的可验证性(verifiability),即是否严格遵循检索到的上下文如实回答。可验证性由两部分组成:
-
高引用召回率(high citation recall):即所有生成的内容都有充分的引用(外部知识)支持。
-
高引用精度(high citation precision):每个引用是否真的支持生成的内容。
回答相关性(Answer Relevance)
回答相关性关注的是系统生成的回答与用户提出的问题之间的相关性。理想情况下,回答应该直接且准确地对应于问题,没有偏离主题或提供不相关的信息。
- TruLens中回答相关性的计算方式:
TruLens通过提供一种基于LLM的评估方法,允许开发者和研究人员通过编程方式获取对系统生成回答的相关性评估。这种方法利用链式推理(Chain of Thought, CoT)增强理解和推理过程,为评估提供透明度和可解释性。
from trulens_eval.feedback.provider.openai import OpenAI
openai_provider = OpenAI()

qa_relevance = (
    Feedback(openai_provider.relevance_with_cot_reasons, name="Answer Relevance")
    .on_input_output()
)
在relevance_with_cot_reasons方法中,使用聊天完成模型来评估回答对于提示的相关性,并揭示评分背后的推理过程。这种方法不仅考虑回答的内容和长度,而且还评估其是否全面回答了问题,并提供了与问题所有部分相关的上下文信息。
- RAGAS中回答相关性的计算逻辑:
RAGAS通过利用LLM重新生成问题(QUESTION_GEN),然后计算这个重新生成的问题与原始问题之间的相似度来评估回答的相关性。这种方法特别关注于系统生成回答的准确性和与原始问题的对应关系。
# https://github.com/explodinggradients/ragas/blob/main/src/ragas/metrics/_answer_relevance.py
QUESTION_GEN = HumanMessagePromptTemplate.from_template(
    """
Generate question for the given answer.
Answer:\nThe PSLV-C56 mission is scheduled to be launched on Sunday, 30 July 2023 at 06:30 IST / 01:00 UTC. It will be launched from the Satish Dhawan Space Centre, Sriharikota, Andhra Pradesh, India
Question: When is the scheduled launch date and time for the PSLV-C56 mission, and where will it be launched from?

Answer:{answer}
Question:
"""
)
不过,由于用户提出的问题通常比较简略,使用RAGAS计算出的回答相关性通常较低。
上下文相关性(Context Relevance)
上下文相关性专注于评估给定上下文(例如从数据库或文档中检索到的信息片段)与用户查询之间的相关性。高相关性的上下文信息为大型语言模型(LLM)提供了生成准确回答的基础。
- 在TruLens中上下文相关性的计算方式:
在TruLens,上下文相关性的评估使用了与回答相关性相同的反馈函数,但是采用了不同的选择器来专注于输入(用户问题)和检索到的上下文信息之间的相关性。这通过对输入问题和来源节点中的文本应用.on_input().on(TruLlama.select_source_nodes().node.text)选择器并计算它们的平均相关性得分来实现。
qs_relevance = (
    Feedback(openai_provider.relevance_with_cot_reasons, name="Context Relevance")
    .on_input()
    .on(TruLlama.select_source_nodes().node.text)
    .aggregate(np.mean)
)
底层计算逻辑:此过程首先识别出与用户问题直接相关的上下文信息,评估这些信息的相关性,可能会应用链式推理(CoT)方法来提高评分的准确性和深度。最终生成的平均分表示了上下文信息的整体相关性,分值范围从0到1。
- 在RAGAS中上下文相关性的计算逻辑:
RAGAS采用了一种略有不同的方法来计算上下文相关性。它通过提取与问题相关的上下文句子(candidate sentences),并对这些句子进行自洽性检查。然后,使用提取的句子数量与检索到的上下文中的总句子数量的比率作为评分标准。
$$ \text{context relevancy} = \frac{|S|}{|\text{Total number of sentences in retrieved context}|} $$
这个方法通过使用LLM根据问题和上下文,从上下文中提取出能够支持回答的句子,进而计算这些候选句子和上下文的长度占比(这里使用的是词元数量的比值)。
      # https://github.com/explodinggradients/ragas/blob/main/src/ragas/metrics/_context_relevancy.py
      CONTEXT_RELEVANCE = HumanMessagePromptTemplate.from_template(
          """\
      Please extract relevant sentences from the provided context that is absolutely required answer the following question. If no relevant sentences are found, or if you believe the question cannot be answered from the given context, return the phrase "Insufficient Information".  While extracting candidate sentences you're not allowed to make any changes to sentences from given context.

      question:{question}
      context:\n{context}
      candidate sentences:\n"""
      )
真实性或忠实度(Groundedness or Faithfulness)
在TruLens和RAGAS中,真实性或忠实度的评估旨在衡量生成的声明或回答在事实上的准确性及其对源材料的依赖程度。这一评估标准对于确保生成内容的质量和可信度至关重要。
- TruLens中的Groundedness
在TruLens框架中,groundedness的评估通过检查声明中的每个句子是否在源材料中有支持来进行。这个过程利用大型语言模型(LLM)和链式推理(Chain of Thought, CoT)方法来增强评估的准确性和深度。具体来说,评估方法会将整个声明作为一个整体进行处理,并对声明中的每个句子赋予一个从0到10的评分,0代表没有任何信息重叠,而10代表信息完全重叠。
grounded = Groundedness(groundedness_provider=openai_provider)

groundedness = (
    Feedback(grounded.groundedness_measure_with_cot_reasons, name="Groundedness")
        .on(TruLlama.select_source_nodes().node.text)
        .on_output()
        .aggregate(grounded.grounded_statements_aggregator)
)
- RAGAS中的Faithfulness
而在RAGAS框架中,Faithfulness(忠实度)的概念与TruLens中的Groundedness(真实性)相似,旨在评估生成回答的事实一致性。忠实度得分通过比较生成回答中的声明与给定上下文的一致性来计算,特别是检查回答中的声明是否可以从给定的上下文中推断出来。
$$ \text{Faithfulness score} = \frac{|\text{Number of claims that can be inferred from given context}|}{|\text{Total number of claims in the generated answer}|} $$
# https://github.com/explodinggradients/ragas/blob/main/src/ragas/metrics/_faithfulness.py
LONG_FORM_ANSWER_PROMPT = HumanMessagePromptTemplate.from_template(
  """\
Given a question and answer, create one or more statements from each sentence in the given answer.
question: Who was  Albert Einstein and what is he best known for?
answer: He was a German-born theoretical physicist, widely acknowledged to be one of the greatest and most influential physicists of all time. He was best known for developing the theory of relativity, he also made important contributions to the development of the theory of quantum mechanics.
statements:\nAlbert Einstein was born in Germany.\nAlbert Einstein was best known for his theory of relativity.
question: Cadmium Chloride is slightly soluble in this chemical, it is also called what?
answer: alcohol
statements:\nCadmium Chloride is slightly soluble in alcohol.
question: Were Shahul and Jithin of the same nationality?
answer: They were from different countries.
statements:\nShahul and Jithin were from different countries.
question:{question}
answer: {answer}
statements:\n"""  # noqa: E501
)

NLI_STATEMENTS_MESSAGE = HumanMessagePromptTemplate.from_template(
  """
Prompt: Natural language inference
Consider the given context and following statements, then determine whether they are supported by the information present in the context.Provide a brief explanation for each statement before arriving at the verdict (Yes/No). Provide a final verdict for each statement in order at the end in the given format. Do not deviate from the specified format.

Context:\nJohn is a student at XYZ University. He is pursuing a degree in Computer Science. He is enrolled in several courses this semester, including Data Structures, Algorithms, and Database Management. John is a diligent student and spends a significant amount of time studying and completing assignments. He often stays late in the library to work on his projects.
statements:\n1. John is majoring in Biology.\n2. John is taking a course on Artificial Intelligence.\n3. John is a dedicated student.\n4. John has a part-time job.\n5. John is interested in computer programming.\n
Answer:
1. John is majoring in Biology.
Explanation: John's major is explicitly mentioned as Computer Science. There is no information suggesting he is majoring in Biology.  Verdict: No.
2. John is taking a course on Artificial Intelligence.
Explanation: The context mentions the courses John is currently enrolled in, and Artificial Intelligence is not mentioned. Therefore, it cannot be deduced that John is taking a course on AI. Verdict: No.
3. John is a dedicated student.
Explanation: The prompt states that he spends a significant amount of time studying and completing assignments. Additionally, it mentions that he often stays late in the library to work on his projects, which implies dedication. Verdict: Yes.
4. John has a part-time job.
Explanation: There is no information given in the context about John having a part-time job. Therefore, it cannot be deduced that John has a part-time job.  Verdict: No.
5. John is interested in computer programming.
Explanation: The context states that John is pursuing a degree in Computer Science, which implies an interest in computer programming. Verdict: Yes.
Final verdict for each statement in order: No. No. Yes. No. Yes.
context:\n{context}
statements:\n{statements}
Answer:
微调模型评估
在评估RAG系统时,虽然GPT-4等大型语言模型(LLM)因其高性能而被广泛使用,但由于成本和本地部署的需要,选择一个有效的本地部署开源模型也成为了许多研究和应用场景的必需。然而,与GPT-4等高级模型相比,这些本地开源模型的能力通常存在差距,特别是在特定领域内的应用效果上。因此,针对特定领域微调一个LLM用于评估变得尤为重要。
以下是使用Trulens测试框架,基于笔者所在领域的语料库,对同一个RAG系统使用不同的开源LLM进行评价的结果展示。特别关注的是不同验证模型的失败评分率,这里的失败评分率指的是模型无法按照提示给出有效评分的情况(例如,要求在0~1范围内打分,但模型未给出评分或评分超出范围)。
失败评分率对比
| eval model | Groundedness-FailRatio | Context-Relevance-FailRatio | Answer-Relevance-FailRatio | Records |
|---|---|---|---|---|
| gpt-3.5-turbo | 0.00 | 0.00 | 0.00 | 41 |
| gpt-4-turbo | 0.00 | 0.00 | 0.00 | 41 |
| Qwen1.5-14B-chat | 0.07 | 0.05 | 0.02 | 41 |
| Qwen1.5-7B-chat | 0.10 | 0.10 | 0.07 | 41 |
| zephyr-7b-beta | 0.27 | 0.22 | 0.22 | 41 |
| Qwen1.5-4B-chat | 0.32 | 0.15 | 0.17 | 41 |
| chatGLM3-6b-32K | 0.36 | 0.71 | 0.54 | 41 |
微调策略和建议 为了确保评价结果的稳定性和准确性,微调模型时使用的数据集应特别关注于测试框架中使用的提示格式。这样做旨在提高模型对特定提示格式的响应能力,从而提高评价的准确度和一致性。
此外,从测试结果来看,建议至少使用13B以上的模型进行评价。较小的模型可能在遵循指令和评分准确性方面存在挑战,从而影响评价结果的可靠性。
对于这个场景的微调,一般采用LoRA微调方法即可满足需求。LoRA(Low-Rank Adaptation)是一种有效的微调技术,可以在不大幅增加模型参数的前提下,通过更新模型的少数关键参数来实现性能的提升。这种方法特别适用于需要特定领域知识增强的场景。
如果能够收集到足够多的人类反馈结果,采用RLHF(Reinforcement Learning from Human Feedback)专门训练一个评价模型也是一个可行的选择。RLHF通过从人类反馈中学习来优化模型的性能,这可以在成本可控的范围内提供更精确的评价结果。
传统NLP评估
BLEU
BLEU(Bilingual Evaluation Understudy)通过计算机器翻译输出与一个或多个人工翻译的参考译文之间的词汇精确度来评价翻译的质量。BLEU的主要目的是自动地评估文本翻译的好坏,尽量接近人类翻译质量评估的结果。
ROUGE
ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是自然语言处理(NLP)任务中常用的一种评估指标,尤其在自动文摘(自动摘要)和机器翻译等领域中非常流行。它主要用于评估自动生成的文本与人工编写的参考文本之间的相似度。ROUGE指标通过计算生成文本与参考文本之间的重叠来量度生成文本的质量。
常见的ROUGE度量方式有:基于n-gram的重叠度量方法(如ROUGE-1, ROUGE-2)。它计算生成文本与参考文本之间共有的n-grams的数量,并以此评估生成文本的质量。以及基于最长公共子序列(LCS) 的 ROUGE-L,它考虑了句子级别的结构相似性,不仅仅是简单的词汇重叠。通过计算最长公共子序列的长度,ROUGE-L能够捕捉到生成文本和参考文本之间的顺序依赖性,从而提供更全面的相似度评估。
对于n-gram ROUGE有两个变体: 召回率(Recall):参考文本中与生成文本共有的n-grams数量除以参考文本中的n-grams总数。精确率(Precision):参考文本中与生成文本共有的n-grams数量除以生成文本中的n-grams总数。以及二者的调和平均 F1-score。
More Details:
例子:
# !pip install rouge
from rouge import Rouge
rouge = Rouge()

long = 'It was the best of times, it was the worst of times, it was the age of wisdom, it was the age of foolishness, it was the epoch of belief, it was the epoch of incredulity, it was the season of Light, it was the season of Darkness, it was the spring of hope, it was the winter of despair, we had everything before us, we had nothing before us.'
short = 'It was an age of wisdom, foolishness, belief, Light, Darkness, hope, and despair, with both light and darkness.'

scores = rouge.get_scores(short, long)
print(scores)

# output:
'''
[{'rouge-1': {'r': 0.39285714285714285,
   'p': 0.6470588235294118,
   'f': 0.4888888841876543},
  'rouge-2': {'r': 0.06976744186046512,
   'p': 0.17647058823529413,
   'f': 0.09999999593888906},
  'rouge-l': {'r': 0.39285714285714285,
   'p': 0.6470588235294118,
   'f': 0.4888888841876543}}]

'''
where r, p, and f representing for recall, precision, and f_score.
ROUGE指标的缺点:
-
依赖于参考文本: 如果参考文本的质量不高或者数量不足,可能会导致评分不准确
-
忽略语义信息: 即使两段文本表达相同的意思,但使用了不同的词汇或表达方式,ROUGE评分也可能较低
-
无法评价文本的流畅性和一致性
-
对长文本的评价能力有限
-
无法全面评估信息的新颖性和重要性
数据集
一些公开的RAG数据集
HotpotQA (HQA)
-
数据集链接:HotpotQA at Hugging Face
-
特点:基于维基百科的问答数据集,需要阅读多个支持文档来回答和推理问题。问题多样,不局限于任何预先存在的知识库。提供了句子级别的支持以强化LLM的推理需求。最后,提供了新类型的事实对比问题,测试LLMs提取和比较文本中各种实体属性的能力。
Qasper (QASP)
-
数据集链接:Qasper at Hugging Face
-
特点:基于NLP论文的问答数据集,筛选自Semantic Scholar Open Research Corpus (S2ORC)。
NarrativeQA (NQA)
-
特点:NarrativeQA是一个英语语言的故事和相应问题的数据集,旨在测试阅读理解能力,特别是对长文档的理解。
QuALITY (QLTY)
-
数据集链接:QuALITY at Hugging Face
-
特点:一个基于故事和文章的多项选择问答数据集,来源包括Project Gutenberg和Open American National Corpus等资源。
PopQA
-
论文链接:PopQA Paper
-
数据集链接:PopQA at Hugging Face
-
特点:PopQA是一个大规模的开放领域问答(QA)数据集,包含14k个以实体为中心的QA对。每个问题都是通过使用模板将从Wikidata检索到的知识元组转换而来的。
TriviaQA
-
数据集链接:TriviaQA at Hugging Face
-
特点:TriviaqQA是一个阅读理解数据集,包含超过650K的问题-答案-证据三元组。TriviaqQA包括由琐事爱好者编写的95K个问题-答案对。
ASQA
-
数据集链接:ASQA at Hugging Face
-
特点:ASQA是第一个专注于含糊事实问题的长形式问答数据集。与以往的长形式答案数据集不同,每个问题都标注了长形式答案和可由生成段落回答的提取式问答对。
PUBHEALTH
-
特点:一个包含11,832个用于事实检查的声明的数据集,这些声明涉及一系列健康话题,包括生物医学主题(如传染病、干细胞研究)、政府医疗政策(如堕胎、心理健康、妇女健康)以及其他与公共健康相关的故事。